Firecrawl
本文目录
📌 核心价值:把任意网页一行变成 AI 能直接“吃”的干净数据
做自媒体、做研究、做 Agent,最头疼的就是“网页数据喂不进模型”——JS 渲染、反爬、广告噪音、脏 HTML。Firecrawl 把这堆脏活全包了。
🚀 什么是 Firecrawl?
Firecrawl 是火遍全球的「网页上下文 API」:一句话概括,它就是 AI Agent 的“网页上下文基础设施”——你给它一个 URL 或一句话,它返回干净 Markdown、结构化 JSON、截图或者整站抓取结果,全程帮你搞定代理轮换、JS 渲染、限速与反爬。
它目前是 GitHub 上最火的开发者工具之一,累计 168,809 Star、9,437 Fork,采用 AGPL-3.0 开源协议,由 Y Combinator 背书,官方称已被 150,000+ 家公司用于生产。


核心定位:让 AI 应用“找得到、读得懂、用得上”实时网页。 普通爬虫给你一堆原始 HTML,Firecrawl 给你的是“去掉导航、页脚、广告之后,只留正文的干净内容”,官方实测能帮模型减少 93% 的输入 token。
✨ 核心能力一览
Firecrawl 把过去要自己拼一堆脚本才能做的事,收敛成 7 个统一端点:
- Search:搜网页,直接拿搜索结果的完整正文
- Scrape:单个 URL → Markdown / JSON / 截图 / HTML
- Crawl:一个请求抓取整站所有 URL
- Map:瞬间发现网站全部链接
- Batch Scrape:成百上千 URL 批量抓取
- Interact:点击、滚动、输入、等待,操作真实浏览器
- Agent:用自然语言描述“要什么数据”,自动多页采集
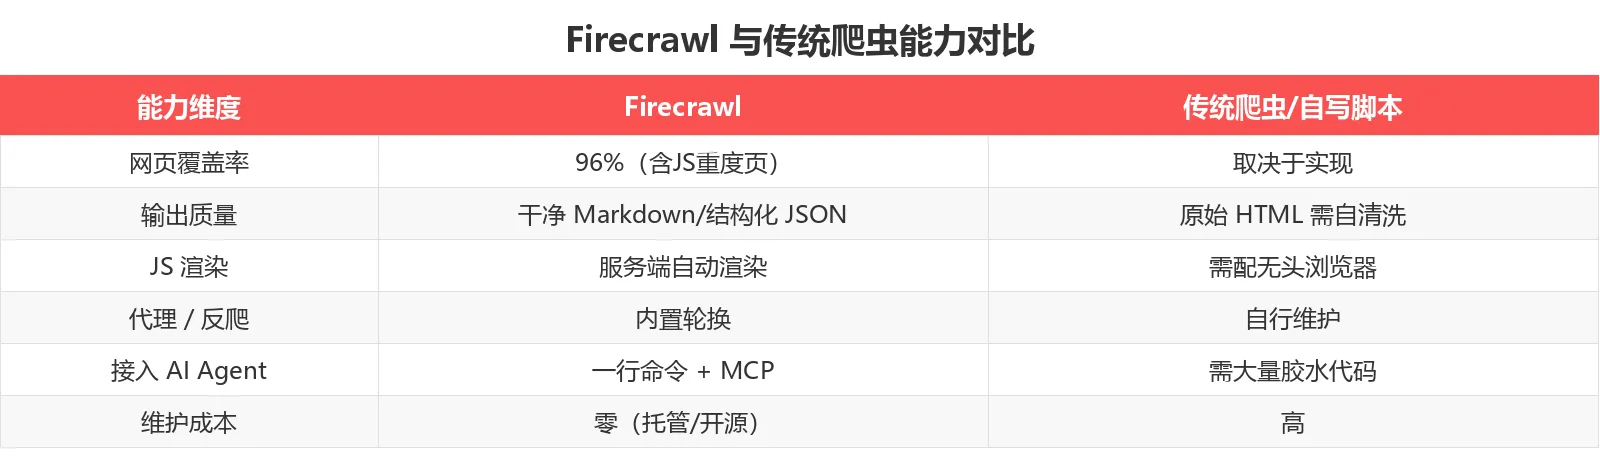
它主打三个硬指标:覆盖 96% 的网页(含 JS 重度页面)、百万级请求 P95 延迟 3.4 秒、输出对 LLM 友好。和传统“自己写爬虫”的对比一目了然:
🛠️ 快速上手:5 分钟跑通
Firecrawl 提供 Python、Node、Rust、Go SDK,也支持 REST、CLI 和 MCP。最常用的入口是 Python SDK:
pip install firecrawl-py
把任意网页转成干净 Markdown
from firecrawl import Firecrawl

firecrawl = Firecrawl(api_key="fc-YOUR-API_KEY")

# 一行把网页变成 AI 能直接用的 Markdown
doc = firecrawl.scrape("https://example.com", formats=["markdown"])
print(doc.markdown)
结构化抽取(JSON 模式)
不想自己写解析正则?直接用自然语言 + Schema 抽取结构化字段:
data = firecrawl.scrape("https://firecrawl.dev", formats=[{
    "type": "json",
    "prompt": "提取产品的核心功能",
    "schema": {
        "type": "object",
        "properties": {"features": {"type": "object"}},
        "required": ["features"]
    }
}])
print(data.json)
一次抓取整站
result = firecrawl.crawl_url("https://docs.firecrawl.dev", limit=50)
for page in result.pages:
    print(page.url, len(page.markdown))
注意:自托管完全免费,只有调用官方云才按 credit 计费;免费版就够个人试用。
对于交互型页面(登录、多步表单),用 actions 数组就能点击、填写、等待并截图,无需自己维护无头浏览器:
curl -X POST https://api.firecrawl.dev/v2/scrape \
  -H "Authorization: Bearer fc-YOUR-API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"url":"https://example.com/login","formats":["markdown"],
       "actions":[{"type":"write","text":"john@example.com"},
                  {"type":"press","key":"Tab"},
                  {"type":"write","text":"secret"},
                  {"type":"click","selector":"button[type=submit]"},
                  {"type":"wait","milliseconds":1500},
                  {"type":"screenshot","fullPage":true}]}'
💡 它到底帮你连起了什么?
一句话:它是 AI Agent 和真实网页之间的“网关”。Agent 说一句话,Firecrawl 去真实浏览器里把数据取回来、洗净、结构化,再交还给模型——整个过程对 Agent 完全透明。
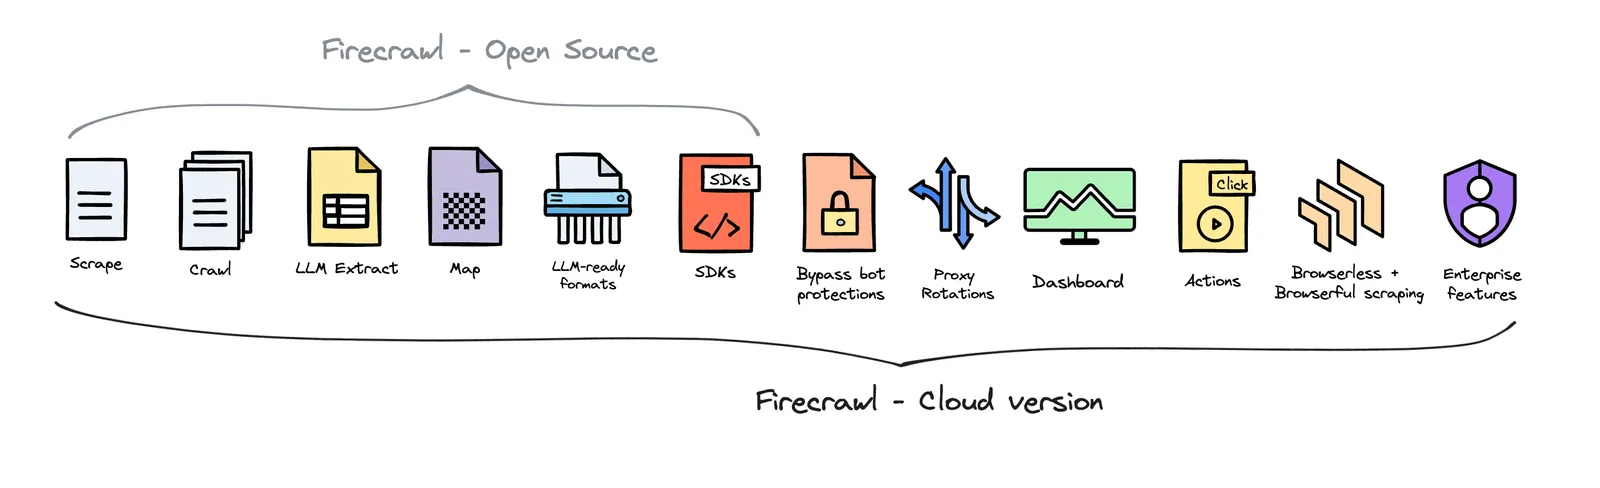
而且它同时提供开源自部署与官方托管云两条路线,下面是官方给出的部署形态对比:
📊 适用场景
场景 1:自媒体 / 内容创作一键采料
功能说明:做选题、做盘点、做竞品分析时,需要把大量网页变成可引用的正文。Firecrawl 一键把几十个链接转成干净 Markdown,直接喂给写作 Agent。
输入要求:目标 URL 列表,或一句自然语言采集指令。
输出效果:去噪后的正文 Markdown / 结构化字段,省掉 90% 的清洗时间。
适用场景:每日资讯速览、行业报告素材收集、竞品官网信息比对。
场景 2:给 AI Agent 接上“实时网感”
功能说明:RAG、深度研究、智能客服这类 Agent,最缺的就是实时网页数据。Firecrawl 通过 Skills / CLI / MCP 一键接入,Agent 随时能搜、能抓、能交互。
输入要求:Agent 运行环境(Claude Desktop、Cursor 等 MCP 客户端或自研服务)。
输出效果:Agent 调用 firecrawl_scrape 之类工具即可拿到网页上下文,无需写胶水代码。
适用场景:深度研究 Agent、知识库实时更新、销售线索富化(Lead Enrichment)。
场景 3:大规模数据采集与监控
功能说明:用 crawl / map / batch_scrape 一次性摸清整站结构并批量取数,配合定时任务做价格、舆情、合规监控。
输入要求:起始 URL + 并发/限额配置。
输出效果:成百上千页面的结构化数据集,可直接进数据仓库或训练管线。
适用场景:竞品价格监控、行业榜单采集、合规与舆情巡检。
用户群体总结
- ✅ 自媒体 / 内容团队:把网页素材一键变成干净正文,省掉清洗
- ✅ AI 应用开发者:给 Agent 一行接上实时网页,免维护爬虫
- ✅ 数据分析 / 增长团队:批量抓数、线索富化、舆情监控
- ❌ 不适合:纯静态、无需联网的本地任务;或对数据出境有严格合规限制的场景(可用自托管缓解)
💰 定价方案
Firecrawl 同时提供免费、付费订阅、开源自托管和按量四种路线,门槛极低:
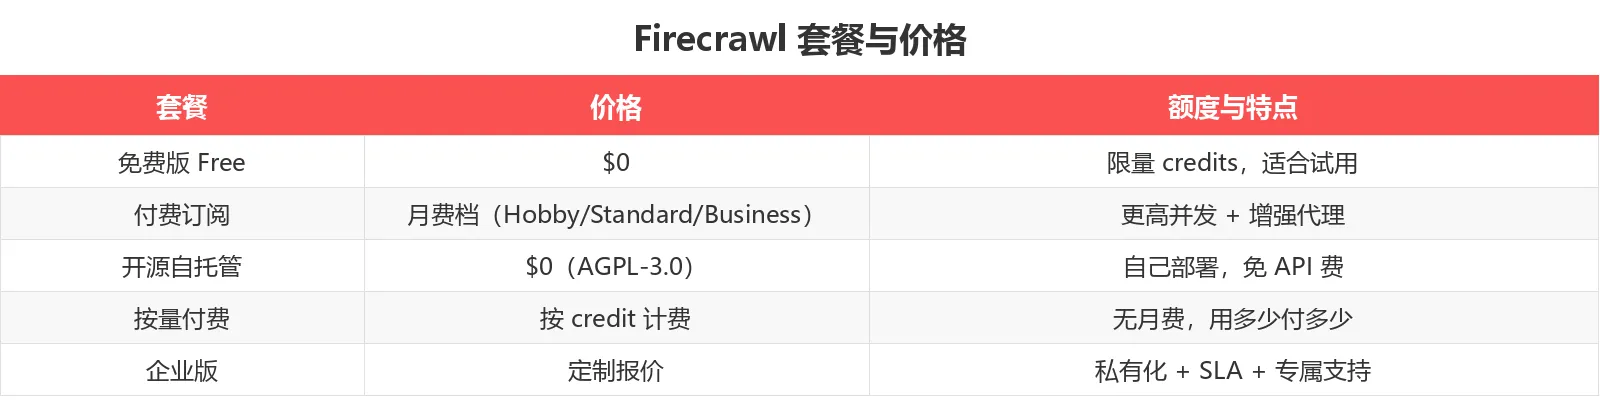
开源协议: AGPL-3.0
💡 新用户福利:免费版即可上手试用,个人做内容采料基本零成本;要更高并发和增强代理再上付费档。
🎯 总结
Firecrawl 解决的是一个所有 AI 应用都会遇到的真问题:网页数据“取得到、洗得净、接得进模型”。它把代理、JS 渲染、限速、反爬这些最磨人的脏活标准化成一个 API,又用开源协议把门槛打到地板价。无论你是做自媒体采料、做研究 Agent,还是搭数据管线,它都值得放进工具箱。
推荐指数: ⭐⭐⭐⭐⭐(满分 5 星)
适合人群: 内容创作者、AI 应用开发者、数据分析与增长团队
立即体验: Firecrawl 官网
GitHub 仓库: firecrawl/firecrawl
数据截至 2026-08-18,最新信息请以官网为准。