AI 终于能听声音了:不用显卡,201 个音效白拿
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../earshot-recommend.pptx../../earshot-recommend.mp4AI 终于能听声音了:不用显卡,201 个音效白拿
剪完一条片子,画面你改十遍都不心虚;可声音一出问题,多数人只能把时间轴拖来拖去,凭感觉调。
现在有个开源工具能让 AI 替你"听"一遍。它不只看波形,还能用大白话告诉你:这一声像什么、和画面对没对上、哪一秒该动刀。最实在的是它不用显卡——笔记本的 CPU 就能跑,核心功能 MIT 开源、全程本地,201 个音效直接白拿。
先泼盆冷水:它听不出品味和情绪,判断不了素材版权,也听不清人声内容。所谓"听",其实是两个开源模型加一套客观测量。但就"音效和画面对没对上"这件事,它给出的数字比人耳靠谱得多——官方拿自家演示片一测,86% 的音效起点落在 1 帧以内。
🚀 它到底在解决什么问题
一个画面里有 41 个声音事件,你记得住哪个键按下去是第几帧吗?
这不是抬杠。AI 现在能写代码把一条片子渲染出来,但它听不见自己做了什么——分不清一个高级的按键声和廉价的按键声,发现不了一个打击点晚了 80 毫秒,也听不出音乐在错误的地方涨了上去。
earshot 干的事,就是把声音变成 AI 能推理的证据:这段录音听起来像什么(用词描述)、和你的描述有多像、长录音里最好的那一段在哪、是真的录音还是代码合成的、整部片子逐秒的"听感记录"、一张能直接看的标注图,以及一份对照专业发布片的评分卡。
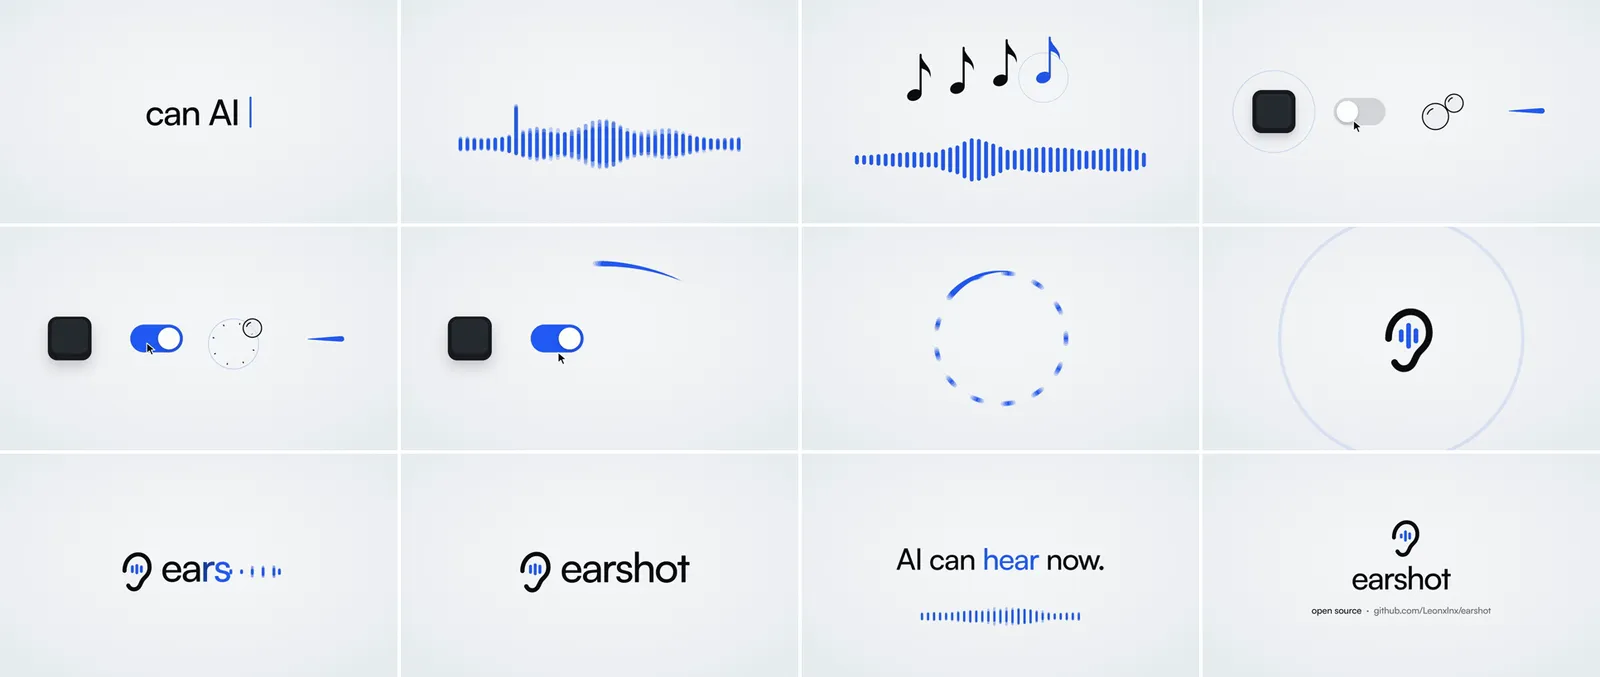
它自己的发布短片就是这么做的:22 秒,片子里每一个声音都是用代码现写的——没有一段录音素材,没有一个音乐音轨,全程 earshot forge 生成。片名就叫"AI can hear now"。
✨ 九条命令,各管一件小事
它不是一个"一键出大片"的按钮,而是九把各管一件事的螺丝刀。真正省时间的,是每把刀都能被 Agent 直接调用。
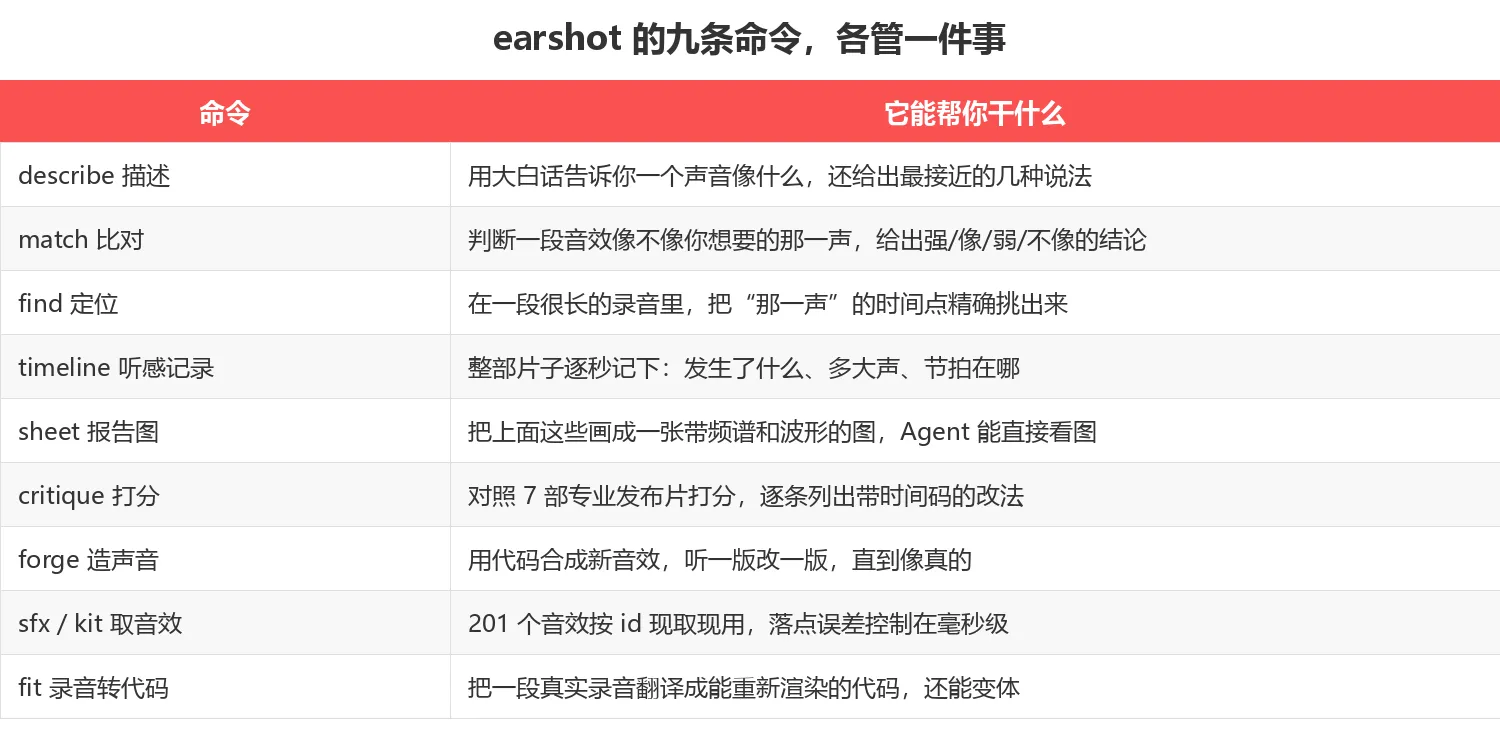
几条命令的真实输出长这样,都是官方 README 里的原话:
$ earshot describe enter.ogg
  0.56 s short transient (attack 3 ms, decays in 190 ms). Sounds most like:
  a single mechanical keyboard key press (z +5.4), a soft key release click (z +3.6)
  ... peak -0.1 dBFS, brightness 1.5 kHz ...

$ earshot match key.ogg "a deep thocky mechanical keyboard press"
  -> strong (z +3.7; would rank #2 among 322 vocabulary descriptions)

$ earshot critique film.mp4
  VERDICT: close - 21 of 23 scored metrics in range
  FIX FIRST: 1. [major] nothing reaches body level until 0:01.01
最后那句才是重点。它不说"声音不错",而是告诉你第一秒零一帧之前,整条片子都没进入应有的厚度——这种话,新手说不出来,老手得反复听。
📊 它凭什么说自己"听得见"
点开一张 sheet 报告图就明白了。下面这张是它对自家 22 秒演示片的完整分析,横轴是秒,从上到下六层,一层层往下剥。
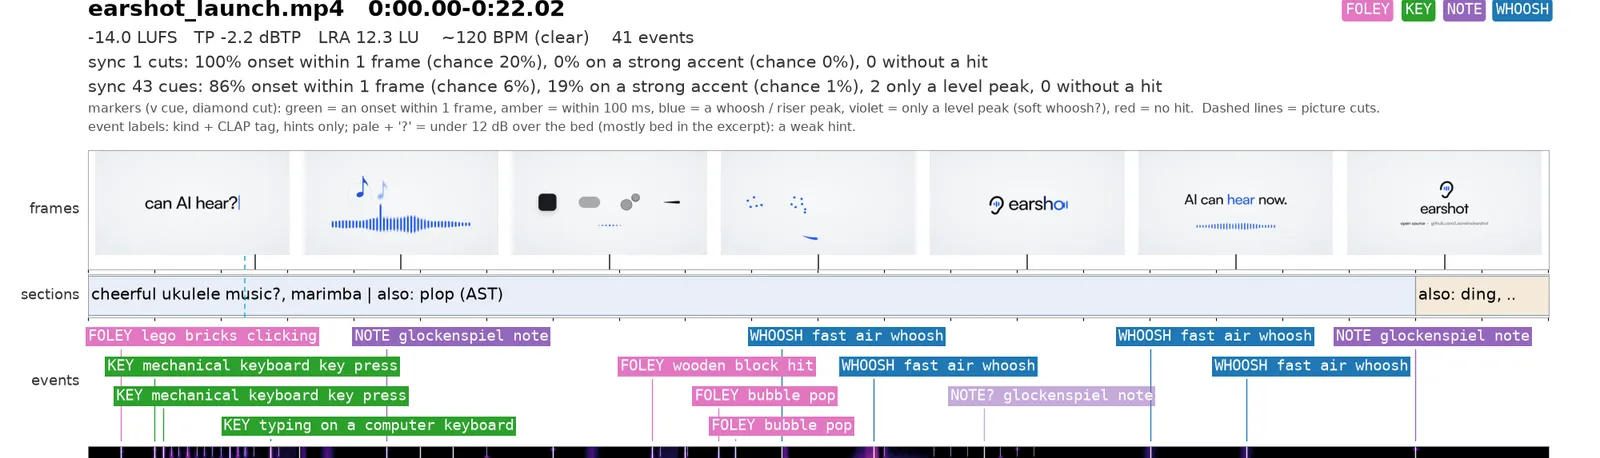
顶部那行字就是一整套体检结果:
- -14.0 LUFS、真峰值 -2.2 dBTP、响度范围 12.3 LU、约 120 BPM——客观指标全部达标
- 41 个事件:从"乐高积木咔哒"、"机械键盘按键"、"木鱼敲击",到"泡泡爆掉"、"钟琴音符"、"快速风声"
- sync 43 cues:86% 的事件起点落在 1 帧以内(随机瞎猜只有 6%),19% 正好压在重音上
- 还有 0 个"只有电平峰值、没有真实起音"的假触发
换句话说,它把"这条片子的音效有没有气口、有没有踩在点上"变成了可核验的数字。
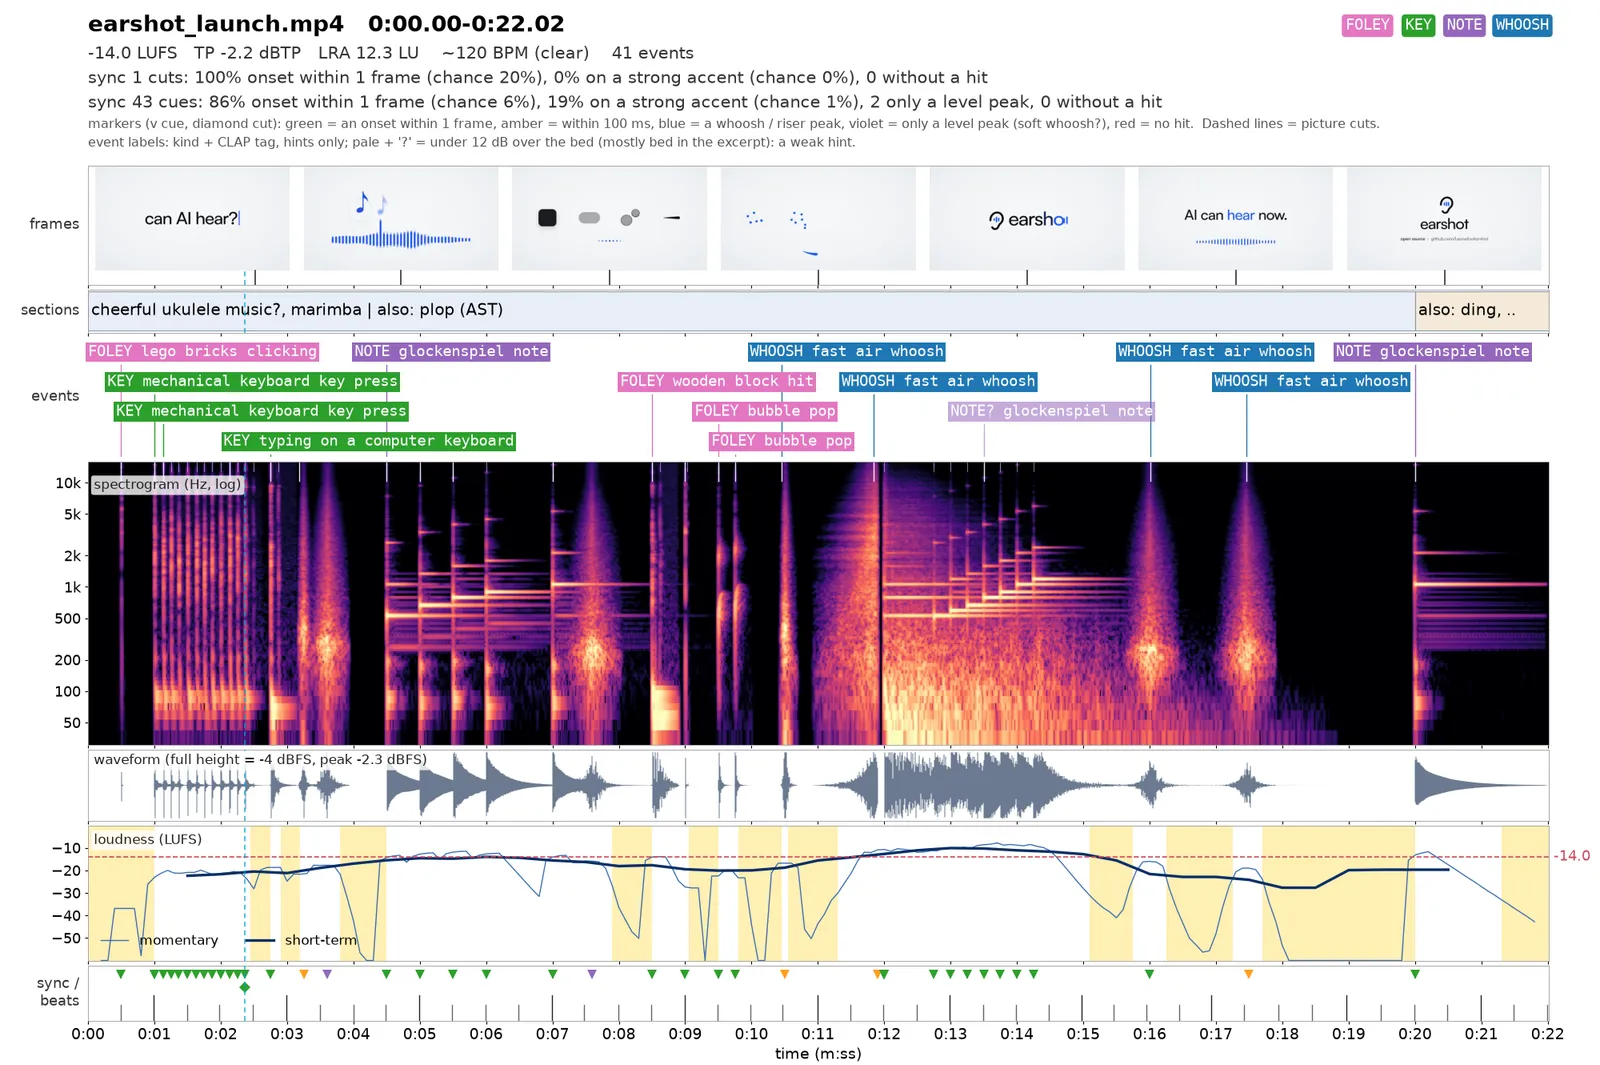
第三行是"分区听感"——AI 听完整段后给的一句话判词:cheerful ukulele music?, marimba | also: plop (AST)。注意那个问号,它不装懂。
再往下是它的"感官器官":
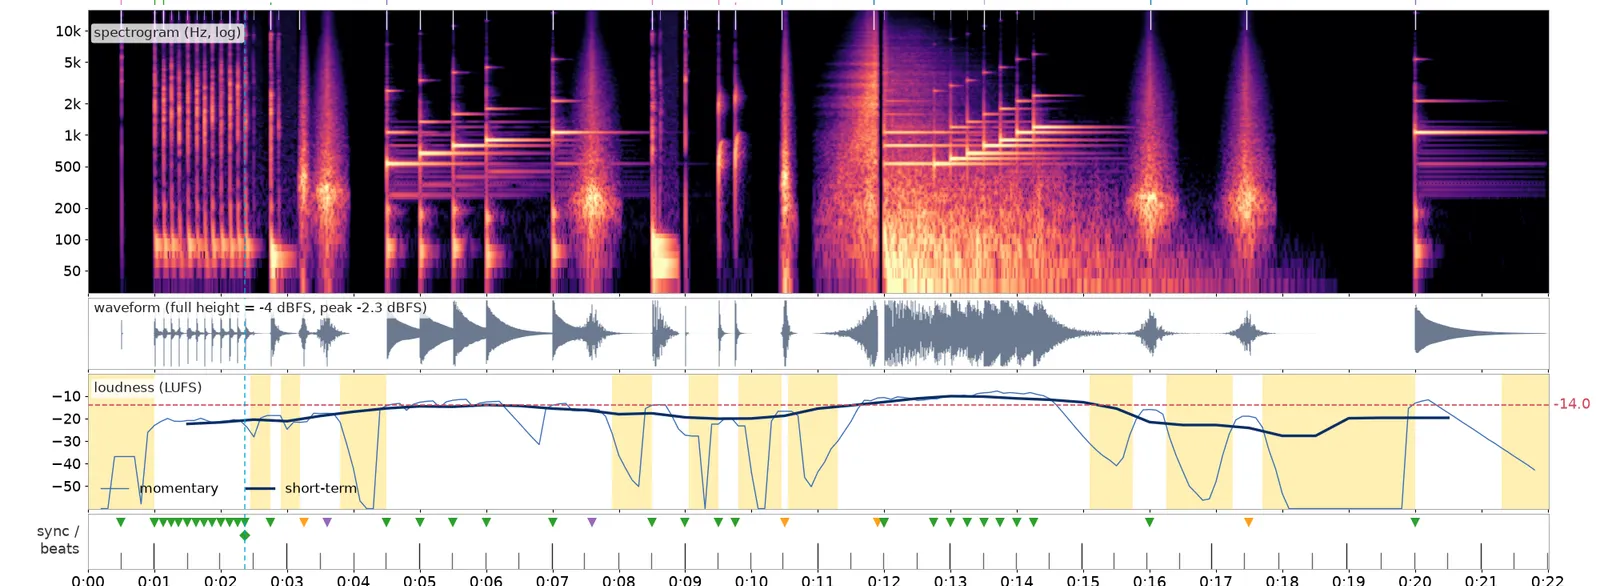
对数频谱看音色与瞬态,波形看电平包络,LUFS 曲线看动态有没有被压平,绿黄紫蓝的小三角是"音效落点 vs 画面剪切点"的对齐判定。绿点=卡在 1 帧内,黄点=偏差 100 毫秒内,蓝点=只是呼啸声的顶点,紫点=只有电平起伏,红点=完全空枪。 一张图读完,不用听。
🛠️ 装好它,三条命令
要求很低:Python 3.10+,ffmpeg / ffprobe 在 PATH 里,纯 CPU,不碰显卡。
git clone https://github.com/Leonxlnx/earshot && cd earshot
python -m venv .venv
# Windows 用 .venv/Scripts/python
.venv/bin/python -m pip install torch --index-url https://download.pytorch.org/whl/cpu
.venv/bin/python -m pip install -e ".[mcp,llm,dev]"
.venv/bin/python -m earshot doctor --load
第一次用会下载两个开源模型,合计约 1.1 GB:CLAP(听懂"这段声音像什么词")和 AudioSet 打标模型。之后就只读本地缓存,再也不联网。
有个坑先说清楚:每条命令都是新进程,冷启动要加载模型,约 20–40 秒才开始回答。调用次数多的时候别一条条敲,直接开 MCP 服务(模型常驻),或者写一个 Python 脚本调 from earshot import api。另外 measure、sfx、kit 三条命令不加载模型,秒回。
想接进 Claude Code,一行:
claude mcp add earshot --scope user -e EARSHOT_THREADS=3 -- /path/to/earshot/.venv/bin/python -m earshot mcp
老机器记得调 EARSHOT_THREADS(默认是 min(4, 核心数/2)),别让它把 CPU 吃满。
💡 三种人用它最划算
第一种:一个人剪完整条片子的人。 音效是剪辑里最耗时的环节之一,买素材包要钱,找免版权要翻半天。earshot 内置 201 个音效——183 个 forge 成品(34 类)、3 把卡林巴、15 段从 CC0 录音拟合出来的——按 id 直接渲染,不加载模型、不联网、几秒钟出结果。想要一个 0.8 秒的清脆风声,把最响的那一刻对准 0.32 秒:
earshot sfx render whoosh_fast/crisp -o w.wav --dur 0.8 --apex 0.32
earshot sfx check w.wav   # 自动体检:爆音、截断尾音、削波、梳状啸叫
官方给的数字:--apex 要求把声音最响的瞬间落在目标点 5 毫秒内,实测误差 2.5 毫秒。201 个音效里有 185 个通过体检,官方预设只用这 185 个。
第二种:想让 Agent 自己做完一条片子的人。 这是它设计的初衷。Agent 写代码渲染画面,再用 earshot 听一遍自己的作品,改,再听。你不需要在旁边当"人肉耳朵"。
第三种:手上有一段声音,想拆解它的人。 earshot fit 能把一段录音翻译成代码——存的是声音的结构,不是采样。12 段真实录音实测,生成代码重新渲染出来的声音与原录音的 CLAP 余弦相似度中位数 0.945(最低 0.881),12 次盲听里人耳分不出哪段是原声。有了代码就能改变体:音高、亮度、衰减、尺寸,甚至两段声音之间做渐变。
⚠️ 它听不出什么
这一点必须讲清楚,因为官方自己把话说得很死。
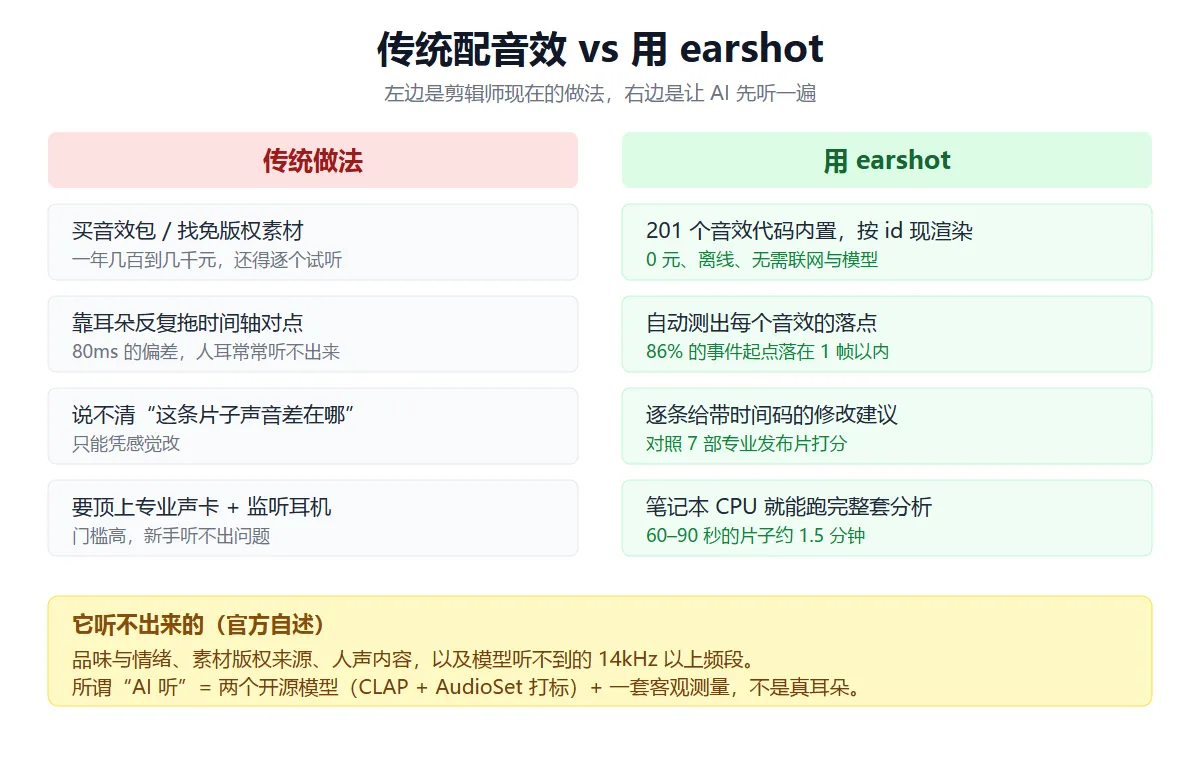
可信的:响度、时间与画面同步、"这是不是我要的那类声音"(单个干净的声音)、从多个候选里挑最好的、明显的代码合成音。
仅供参考的:嘈杂混音里单个事件的标签、音乐的曲风与情绪。
完全做不到的:品味与情绪、素材来源与版权、人声内容、以及模型听不见的 14 kHz 以上频段。
还有一条最该被记住的自曝:作者做了个盲测,把代码生成的 5 种音效和真实录音混在一起让自己听,15 次里只认对 8 次——和抛硬币没区别。而且 forge 的搜索优化的是 earshot 自己的模型,模型可以被讨好:搜索完之后,连"真假判别"模型都分不出来了,只有 1/3 倍频程的客观测量还能看出破绽。
这份坦诚反而值得信任。一个肯把自己的盲测成绩写成"硬币水平"的项目,通常比宣称"完美还原"的项目更靠谱。
🎯 值不值得装
如果你只是偶尔配个背景音乐,用不上它——它解决的是"音效对不对得上"这种精细活。
但如果你符合下面任一条,它值得占你 1.1 GB 硬盘:
- 一个人剪片子,音效全靠自己一个个试
- 在让 Agent 自动产出视频,需要它自己检查声音
- 想把一段好听的音效拆开、改成自己的版本
- 手上有老笔记本,一直以为"AI 音频处理需要显卡"
最后一条可能最反直觉:这套东西全程不用 GPU。响度、时间对齐、音效落点这些真正决定"专业感"的指标,本来就不需要大模型——一个 60 到 90 秒的片子,笔记本 CPU 大约 1.5 分钟跑完。
项目地址:github.com/Leonxlnx/earshot,MIT 协议,上线五天拿到 1,796 颗星。它还很年轻,槽点不少:冷启动慢、命令行参数多、文档全英文。但它补上的那个空洞是真的——让 AI 从"能画"走向"能听"。
📌 快速参考
- 项目:Leonxlnx/earshot,上线五天 1,796 颗星,MIT 协议
- 许可:代码 MIT;CLAP 模型 Apache-2.0,AST 打标模型 BSD-3-Clause
- 硬件:纯 CPU,全程不用显卡
- 依赖:Python 3.10+、ffmpeg / ffprobe 在 PATH
- 首次下载:约 1.1 GB(两个开源模型,之后彻底离线可用)
- 内置音效:201 个,其中 185 个通过自动体检
- 接入方式:命令行 / Python API / MCP 服务 / 两个现成 Agent Skill
- 适合谁:独立剪辑者、自动化出片流程、需要拆解音频的人