开源AI量化框架为何给AI套上枷锁
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../deepseek-harness-quant-recommend.pptx../../deepseek-harness-quant-recommend.mp4本文目录
开源AI量化框架为何给AI套上枷锁
本文仅作技术交流,不构成投资建议。股市有风险,投资需谨慎。
2026 年市面上的“AI 选股”工具,几乎都在做同一件事:让大模型直接吐买卖点。但我在 GitHub 上翻到一个反着来的开源框架——DeepSeek HARNESS Quant,它把一条规矩写死在架构里:AI 不直接下个股买卖结论。这不是选项,是硬约束。
我拉取了它的源码核实:驱动层是语言模型,执行层是写死的确定性 Python 引擎,事实层是本地数据系统。AI 可以挖因子、做审计、蒸馏牛散经验,但永远不能替你下“买哪只、什么时候买”的结论。下面说清楚它为什么这么设计,以及它到底适合谁。
一、反共识的核心:把“不确定”关进驱动层
大多数 AI 量化工具把大模型放到决策的最终一环,等于把最不可控的部分交给概率。这个框架反过来:
- 驱动层(语言模型):只负责控制、挖因子、审计、牛散蒸馏。可以犯错,可以试探,但结论不进交易。
- 执行层(写死引擎):评分、回测、风控、扫描全部是确定性 Python,可复现。同样的输入永远得到同样的输出。
- 事实层(数据系统):Point-in-Time 数据接口,T+1 校验,覆盖率分年核查,可证伪。
它自己的话说得很直白:“主观决策 + 写死引擎 + 数据裁决”。AI 是“研究员”,不是“交易员”。
二、决策链:AI 挖因子,数据来裁决
框架的决策链是分层的,每一步都有明确边界:
| 环节 | 职责 | 谁说了算 |
|---|---|---|
| L0 择时 | 市场档位判断 | 写死引擎(数据驱动) |
| L2 Pitch 审批 | 机会池候选审批 | 引擎评分 + 规则 |
| T+1 执行 | 实际下单执行 | 引擎(确定性) |
| 五池验证 | T+1 / 5 / 20 / 60 远期池 | 数据裁决,跨周期证伪 |
关键在“五池远期验证”:一个因子或候选,不是今天看起来好就算数,要放到 T+1、T+5、T+20、T+60 四个远期池里分别验证。能跨周期站稳的才留,站不住的直接证伪。这把“过拟合”挡在了数据层面,而不是靠 AI 一句话。
三、123+ 因子,宁可证伪也不凑数
框架内置 123+ 个因子,全部在 A 股本地实证,覆盖换手率、低波动、反转、流动性、彩票偏度、振幅动量、基本面低频、涨跌边界(一字板过滤)、机构行为、行业层、Alpha101 等维度。
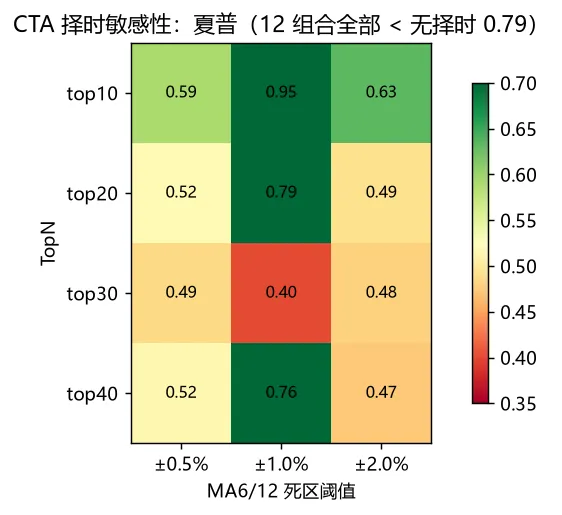
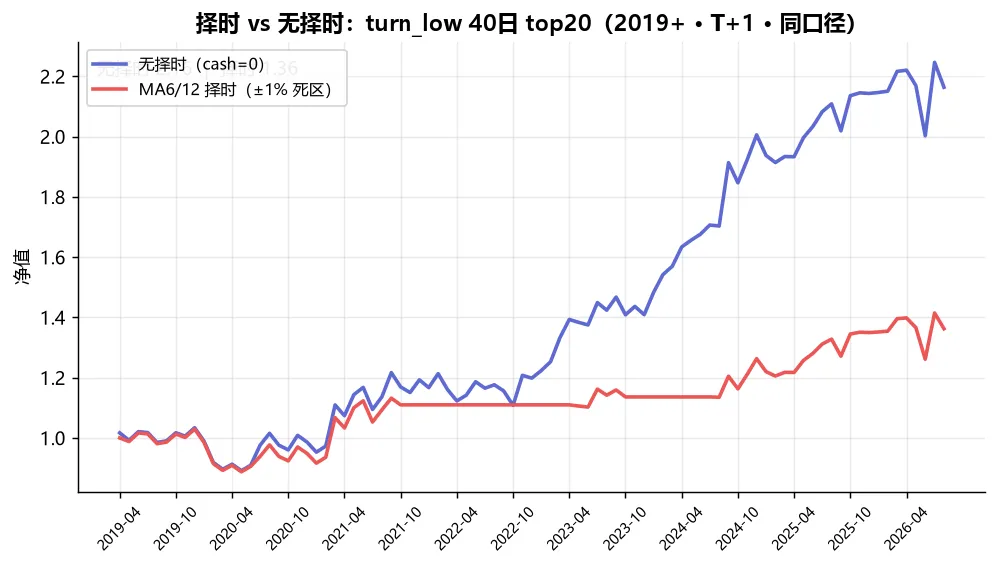
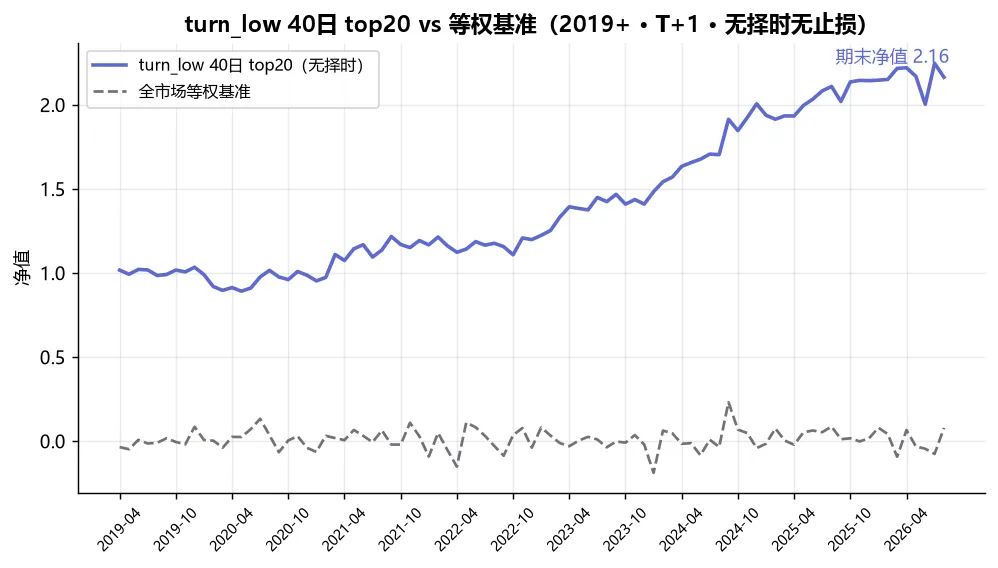
它的入池流程是“九步入池 + 17+ 项证伪留档”。注意重点是“证伪”:一个因子要先被尝试推翻,推不翻才进池。我看到的实证数据里,换手率因子 turn_mid_prox 的 ICIR 到 0.87,反转族 limup_ex_5 到 1.24,流动性 amihud 多空夏普 1.12——这些都是可复现的本地回测结果,不是模型喊出来的“会涨”。
下面三张是仓库里真实的回测验证图(技术回测,仅供方法验证):
四、风控七道 + 牛散蒸馏
风控不是一句“注意风险”,而是七道硬闸门:数据审计、因子健康、FRC 排雷、Beneish 造假检测、竞价检查、单因子检查、L0 门控。任何一道不过,候选直接出局。
更有意思的是“牛散蒸馏”:框架把 7 位知名牛散人格(林园、陈小群、章盟主、赵老哥、冯柳等)做成可对话的人格模块,让 AI 用他们的视角去选股,决策再进远期池验证。还有动态 Cordis 插件热更新——系统行为能在运行时改,不用重编译。
五、怎么用:接上 DeepSeek API 就能自然语言驱动
接入很简单:
# 1. 准备 DeepSeek Key(https://platform.deepseek.com/api_keys)
copy harness\home\.credentials.yaml.example harness\home\.credentials.yaml
# 2. 填入 DEEPSEEK_API_KEY: sk-xxx
# 3. 启动(打印“启动 DeepSeek HARNESS”即集成成功)
python launcher.py
#    Web 决策台: http://127.0.0.1:8787/control
接入后直接用自然语言对话:“研究散户情绪量化”“让 AI 自查前视偏差”“7 位牛散人格对话选股”。不接 API,就只剩写死引擎,没有 AI 这一层。
六、我的实测结论:它强在哪,又不适合谁
强的地方很明确:架构上把“不确定性”和“可复现性”彻底分开,AI 再能聊也越不过数据裁决这道墙;五池远期验证 + 17 项证伪,是对抗过拟合实打实的工程手段;MIT 协议、本地运行、数据自备,隐私和可控性都好。
但我不建议这几类人碰:
- 只想点开即用的小白:它需要 Python 3.10+、可选 Node.js 18+,数据要自己接 Tushare 等源,不是开箱即用的 App。
- 指望 AI 直接给买卖点的:它的设计哲学就是“AI 不直接下个股买卖结论”,你要的是结论,它给的是研究过程,预期错配会非常失望。
- 没有数据源权限的:仓库不分发数据,行情要自己获取,2019 年前的换手率数据本来就缺失,相关结论本就作废。
一句话总结:它是给“想用 AI 做研究、但不想被 AI 忽悠”的人准备的框架,不是给“想让 AI 替我赚钱”的人准备的遥控器。
数据截至 2026-09-15,最新信息请以项目官网与仓库为准。