Chubby Skills
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../chubbyskills-recommend.pptx../../chubbyskills-recommend.mp4本文目录
📌 核心价值:13 个 AI Skill 把抖音/B站/小红书/公众号/播客全部装进你的第二大脑
一键把刷到的爆款视频、播客金句、推文干货、公众号长文自动转成统一 Markdown,直接入 Obsidian vault;Claude Code、Codex、OpenClaw 通过 MCP Server 就能直接读你的知识库回答问题。
🚀 什么是 Chubby Skills?
Chubby Skills 是一套面向个人知识库 + AI Agent 的全栈内容采集工具集,由 @chubbyguan 维护。
它把中文创作者最常消费的 13 个内容源(B站、抖音、小红书、YouTube、公众号、X、播客、TikTok、微博、知乎、RSS、Markdown、PDF)一次性接进统一管线,每条内容都按 schema v1 输出为带 frontmatter 的 Markdown,自动入 Obsidian vault,并配套 knowledge-base-management MCP Server,让 Claude Code、Codex、OpenCode、OpenClaw、Hermes 五大 Agent 直接消费你沉淀的内容。
版本:v0.10.0 开源协议:MIT Stars:499 ⭐ / 73 🍴(截至 2026-07-02) 核心定位:个人知识库自动化 / 全渠道中文内容采集 / Agent Skill 化


核心定位:13 个 Skill + 1 个 MCP Server + 1 套统一 schema = 把信息流变成可被 Agent 调用的第二大脑
✨ 核心功能一览
13 个 Skill(按内容类型分组)
| 类型 | Skill 名称 | 覆盖平台 | 核心能力 |
|---|---|---|---|
| 🎬 视频转录 | bilibili-transcribe |
B站 | 字幕优先 / 视频转录 / 批量处理 |
| 🎬 视频转录 | douyin-transcribe |
抖音 | 视频转文字稿 |
| 🎬 视频转录 | tiktok-transcribe |
TikTok | 视频转文字稿 |
| 🎬 视频转录 | weibo-transcribe |
微博 | 视频转文字稿 |
| 🎬 视频转录 | zhihu-transcribe |
知乎 | 视频转文字稿 |
| 🎬 视频转录 | youtube-transcribe |
YouTube | 转录 / 翻译 / 中英对照 |
| 🎙️ 播客转录 | podcast-transcribe |
小宇宙 / 喜马拉雅 / RSS | 音频转文字稿 |
| 📝 图文采集 | wechat-article-ingest |
公众号 | 文章和 PDF 转 Markdown |
| 📝 图文采集 | xiaohongshu-ingest |
小红书 | 图文 / 视频 / 爆款拆解 |
| 📝 图文采集 | x-ingest |
X / Twitter | 推文 / 图片 / 视频 |
| 🧠 内容加工 | content-enrich |
所有来源 | 摘要 / 要点 / 标签 / 价值判断 |
| 🗄️ 知识库 | knowledge-base-management |
Obsidian vault | 索引 / 搜索 / MCP / 健康检查 |
| 🔍 工作流 | industry-intelligence-radar |
多源情报 | 行业趋势扫描 + 简报 |
| 📚 工作流 | learning-notes-automation |
学习内容 | 笔记 / 闪卡 / 知识图谱 |
关键技术亮点
- ✅ 字幕优先策略:B站、YouTube 默认走字幕,无字幕才用音频转录 → 彻底免 GPU
- ✅ 统一输出协议:所有 Skill 输出带
schema v1frontmatter 的 Markdown(含run_id/source_hash/captured_at/assets) - ✅ 轻量模式默认:默认
semantic-lite语义检索,无需 GPU;可选 OpenAI / 本地sentence-transformers - ✅ 失败分型 + fallback:每个平台都有清晰 fallback 策略(如 X / 小红书的
--fallback-text) - ✅ MCP Server 集成:通过
search_vault/semantic_search_vault/read_kb_note/reindex_vault让 Agent 直接调用
🏗️ 三层架构总览
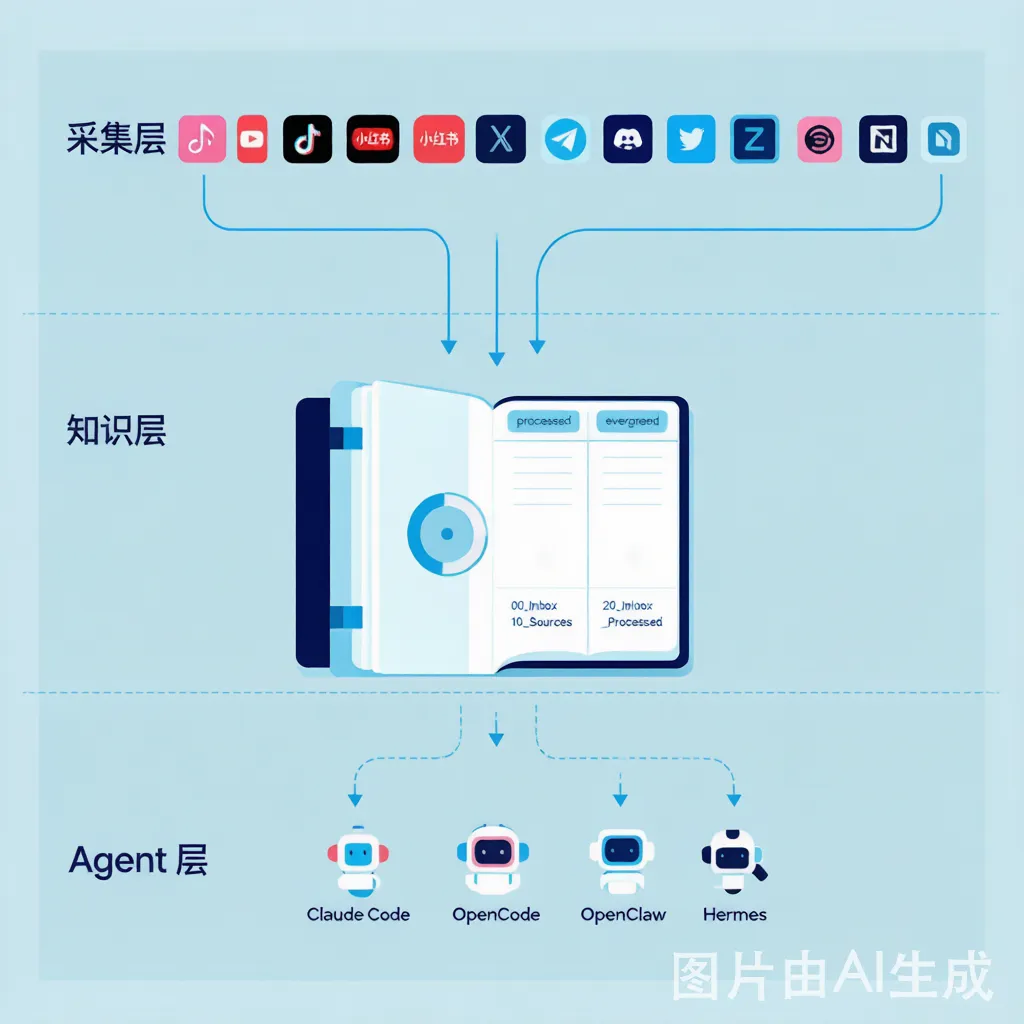
整个仓库按 采集层 → 知识层 → Agent 层 三层组织:
- 采集层(13 个 Skill):把异构内容统一转 Markdown
- 知识层(vault + 索引):标准化 Obsidian 目录 + SQLite 全文/语义索引
- Agent 层(5 个 Agent + MCP):Claude Code / Codex / OpenCode / OpenClaw / Hermes 直接消费 vault
这是 13 个 Skill + 5 个 Agent 沿"采集→入库→消费"主线衔接的全链路,从刷到好内容到 Agent 调用一气呵成。
🛠️ 5 分钟快速上手
一键安装
git clone https://github.com/chubbyguan/chubbyskills.git
cd chubbyskills

# 默认轻量模式(无需 GPU)
bash setup.sh

# 视频转录重依赖(whisper / faster-whisper)
bash setup.sh video

# 播客转录重依赖
bash setup.sh podcast

# 公众号/PDF 处理重依赖
bash setup.sh wechat

# 全部依赖
bash setup.sh all
第一次采集一条 B站视频
python3 tools/chubby_ingest.py "https://www.bilibili.com/video/BVxxxx" -o output/
输出 output/<video_id>.md,结构如下:
---
source: bilibili
url: https://www.bilibili.com/video/BVxxxx
title: 一个改变我看 AI 方式的视频
captured_at: 2026-07-02T18:00:00
run_id: 2026-07-02T_bilibili_BVxxxx
source_hash: sha256:xxxxx
schema_v: 1
content_type: video_transcript
tags: [processed, bilibili, ai-agent]
assets:
  cover: https://xxx.jpg
  subtitle_lang: zh-CN
---

# 一个改变我看 AI 方式的视频

[00:00:00] 大家好,今天聊一下 AI Agent 到底改变了什么...
[00:01:23] 我认为最核心的是从对话到执行的范式转变...
注意:schema v1 元数据是关键 — 让 Agent 能用结构化方式读你的 vault,而不只是字符串。
💡 三大适用场景
场景一:内容创作者把爆款变选题库
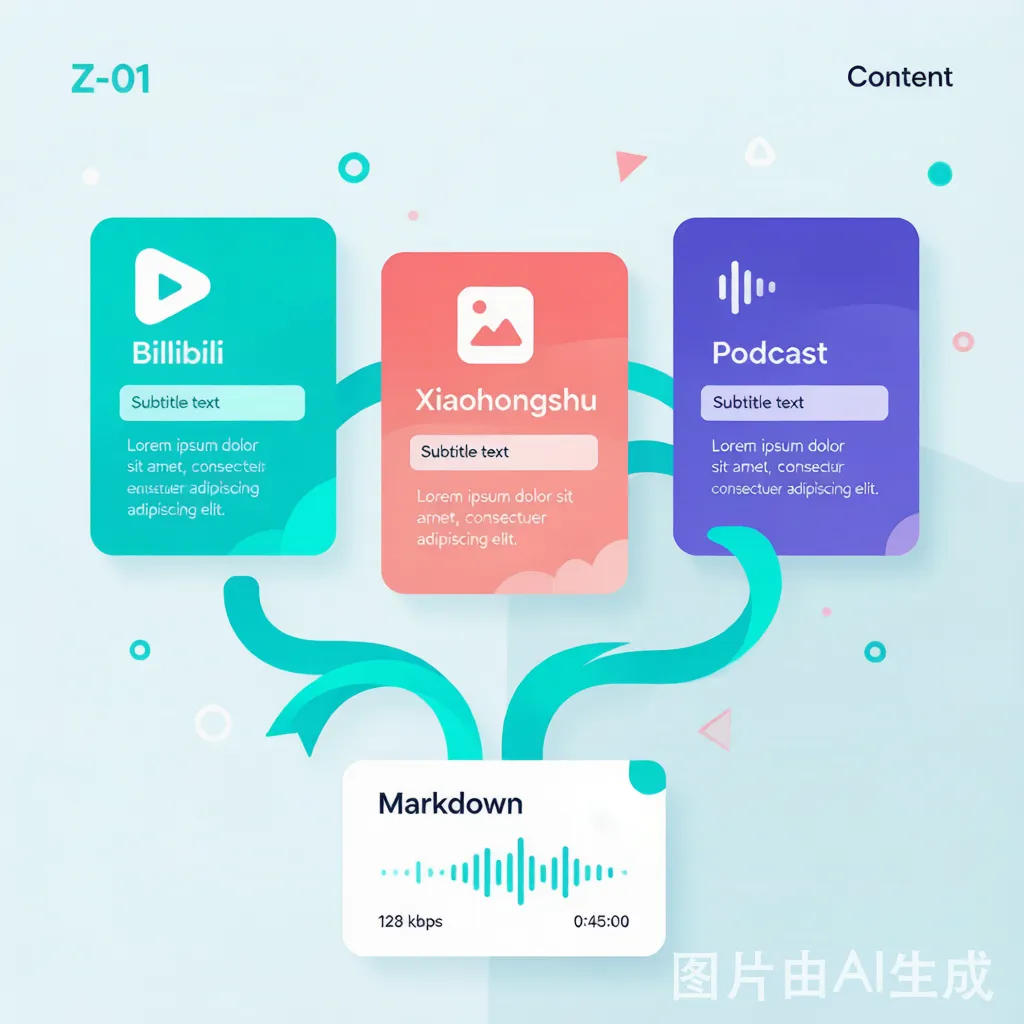
功能说明:每天刷 B站、抖音、小红书的爆款笔记很容易忘记。Chubby Skills 一键把这些内容全部转 Markdown 入库到 10_Sources/<platform>/ 目录,按平台和标签归档。
输入要求:一条视频/图文链接(任何受支持平台)
输出效果:统一格式的 Markdown 文件,含原始字幕、frontmatter 元数据、来源 URL
适用场景:
- ✅ 内容创作者:把竞品爆款拆解成选题库
- ✅ 营销人员:监控竞品在各平台的内容策略
- ✅ 知识工作者:把零散信息沉淀为可检索资产
场景二:DeepSeek 自动加工生成知识卡片
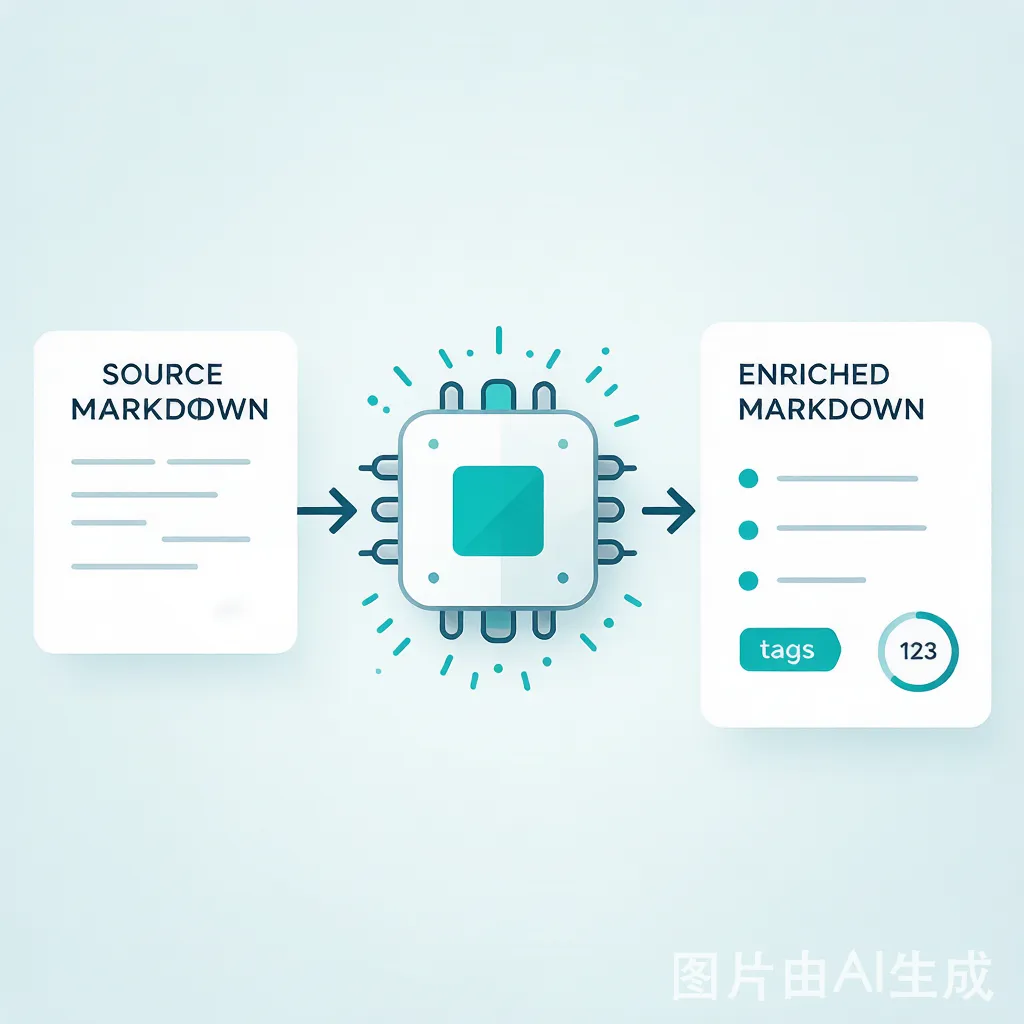
功能说明:content-enrich Skill 自动调用 DeepSeek API,给每条入库内容补充摘要、要点、标签、价值判断四件套,让 vault 里每条笔记都自带"目录信息"。
输入要求:配置 DEEPSEEK_API_KEY,启用 --enrich 标志
输出效果:原 Markdown 头部追加新的 frontmatter 字段:
---
enrich_summary: 本视频核心观点是 AI Agent 的范式转变...
enrich_keypoints:
  - 从对话到执行的转变
  - 多智能体协作的兴起
  - 工具调用能力的突破
enrich_tags: [paradigm-shift, multi-agent, tool-use]
enrich_value: high  # high / medium / low
---
适用场景:
- ✅ 学习者:把 1 小时视频浓缩成 5 分钟要点
- ✅ 研究者:快速判断一篇文章是否值得精读
- ✅ 内容运营:自动给笔记打标签,免手动整理
场景三:Claude Code 直接消费 vault
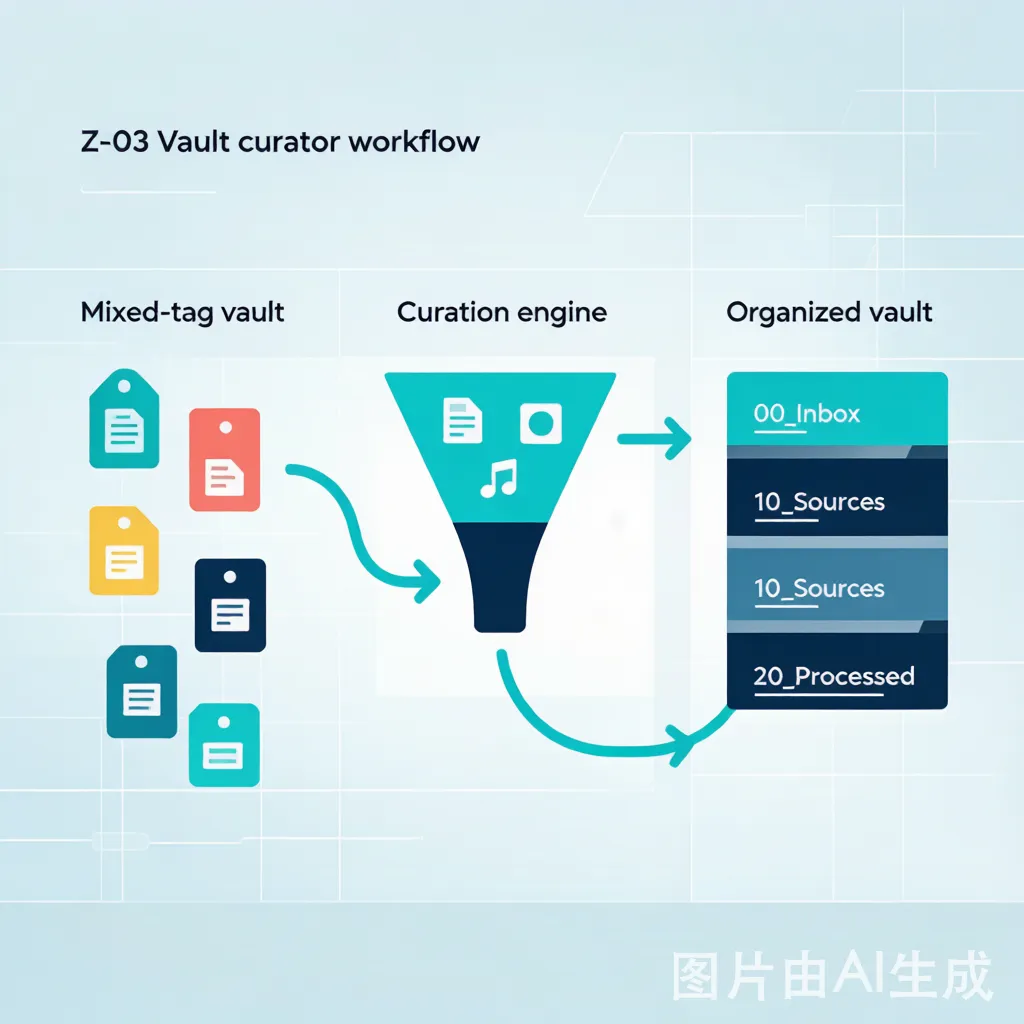
功能说明:knowledge-base-management 自带 MCP Server,让 Claude Code / Codex / OpenCode / OpenClaw / Hermes 通过 search_vault / semantic_search_vault / read_kb_note / reindex_vault 四个工具直接读你的 vault。
输入要求:启动 python3 knowledge-base-management/scripts/mcp_server.py
输出效果:在 Claude Code 中直接问:
请在我的 vault 里搜索关于 "AI Agent 长任务协作" 的所有笔记,整理成一份研究简报。
Claude Code 会自动调用 MCP 工具,跨笔记检索、总结、引用原文。
适用场景:
- ✅ Agent 开发者:让 Agent 拥有"长期记忆"和"知识检索"能力
- ✅ 知识管理者:把 vault 变成可对话的"第二大脑"
- ✅ 团队协作:把分散的笔记变成团队可消费的知识资产
用户群体总结
- ✅ 内容创作者:把每天刷到的爆款笔记沉淀成选题库
- ✅ 学习者:把视频和播客转成文字 + 自动生成闪卡
- ✅ 研究者:搭一个能被 Agent 检索的本地资料库
- ✅ Agent 开发者:让 Claude Code / Codex 直接调用 vault
- ❌ 不适合:需要实时同步云端笔记的团队(vault 是本地的)
📊 与竞品对比
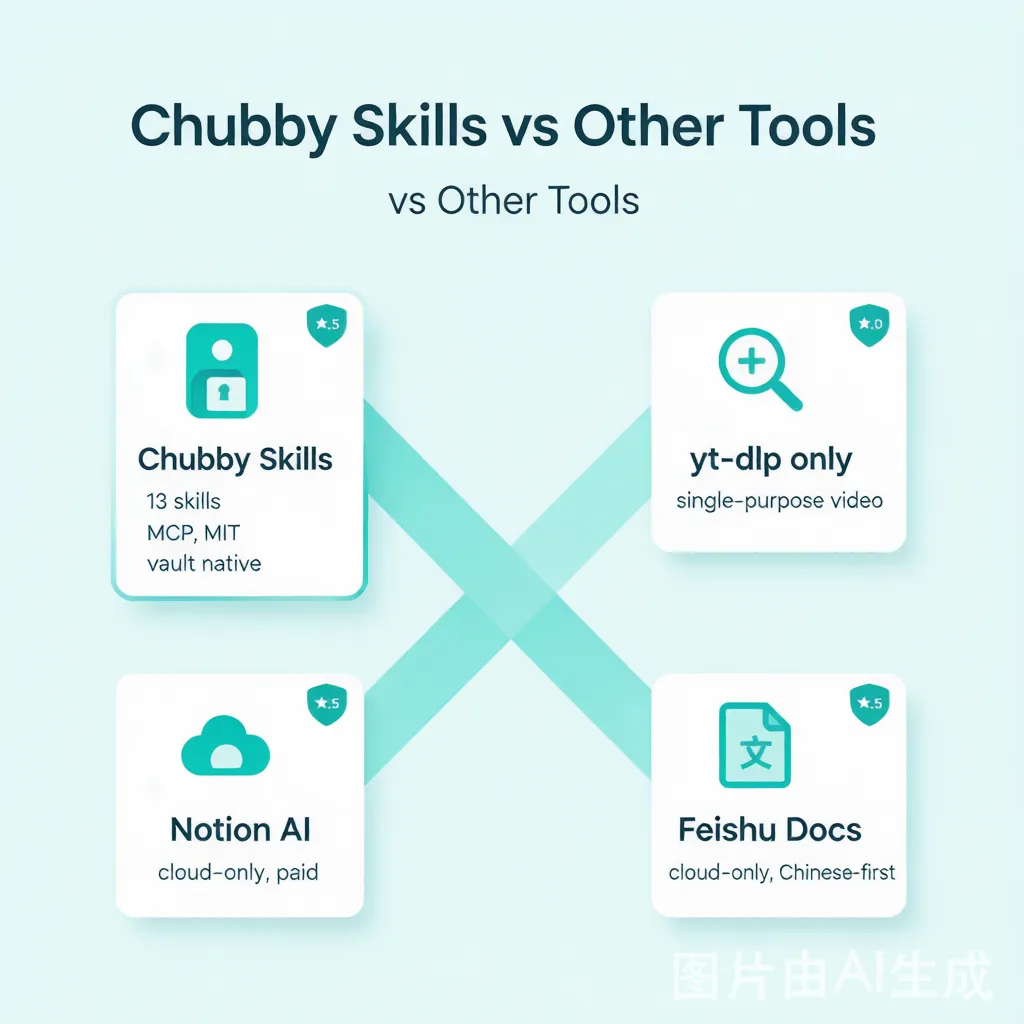
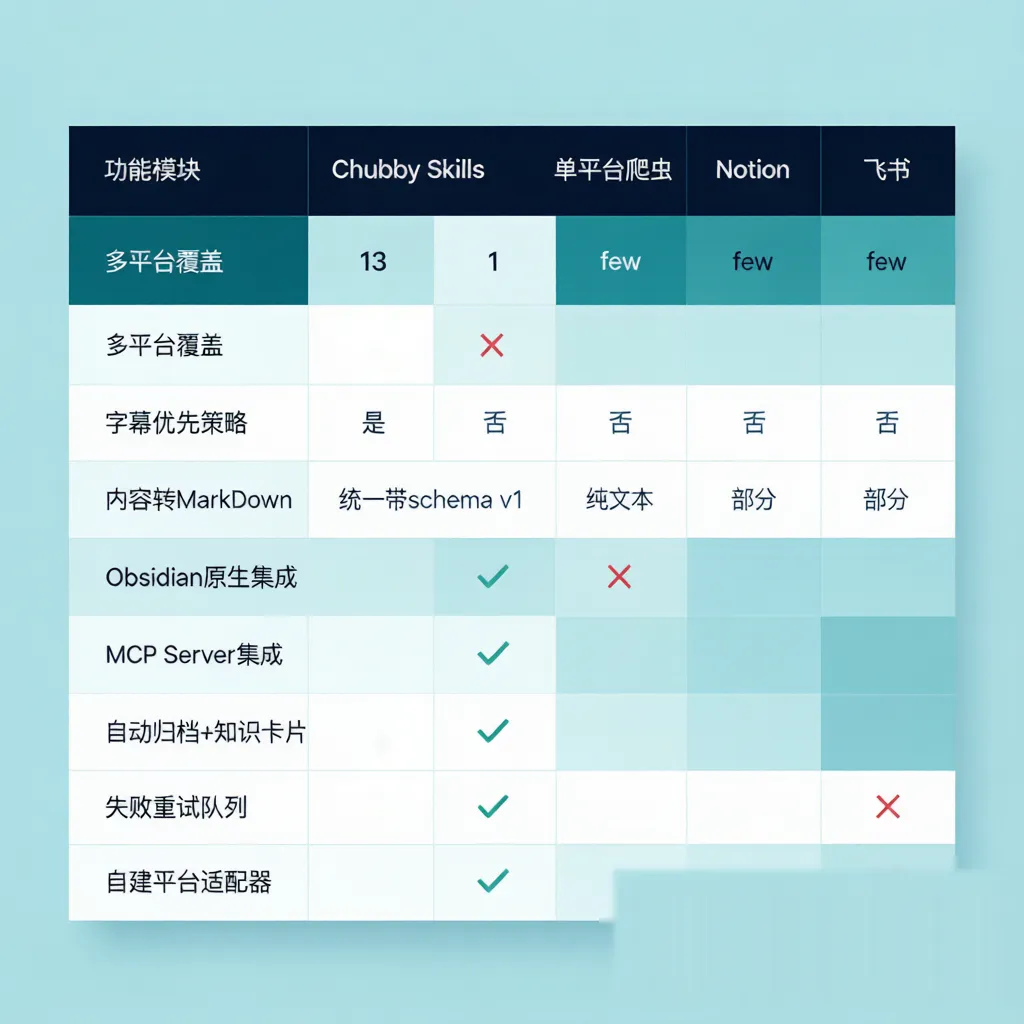
| 维度 | Chubby Skills | yt-dlp 单平台 | Notion AI | 飞书知识库 |
|---|---|---|---|---|
| 多平台覆盖 | 13 个中文平台 | 1 个(视频) | 浏览器扩展 | 浏览器扩展 |
| 字幕优先策略 | ✅ 是 | ❌ 否 | ❌ 否 | ❌ 否 |
| 统一 schema 输出 | ✅ schema v1 | ❌ 纯文本 | ❌ Notion 原生 | ❌ 飞书原生 |
| Obsidian 原生集成 | ✅ 标准 vault 模板 | ❌ 无 | ❌ 云端为主 | ❌ 云端为主 |
| MCP Server 集成 | ✅ 自带 | ❌ 无 | ❌ 无 | ❌ 无 |
| 自动归档 + 知识卡片 | ✅ vault_curator |
❌ 无 | ⚠️ 部分 | ⚠️ 部分 |
| 失败重试队列 | ✅ chubby.py run |
❌ 无 | ❌ 无 | ❌ 无 |
| 自建平台适配器 | ✅ platform_adapter |
❌ 无 | ❌ 无 | ❌ 无 |
| 开源 | ✅ MIT | ✅ GPL | ❌ 闭源 | ❌ 闭源 |
| 本地优先 | ✅ vault 在本地 | ✅ 本地 | ❌ 云端强制 | ❌ 云端强制 |
Chubby Skills 是少数同时覆盖「13 个中文平台 + 本地 Obsidian vault + Agent MCP 调用 + 字幕优先免 GPU」的开源方案。
💰 定价方案
完全开源、MIT 协议、可商用。
核心依赖成本:
yt-dlp:免费开源(视频下载)FunAudioLLM/SenseVoice/faster-whisper:免费开源(音频转录)microsoft/markitdown/PyMuPDF:免费开源(PDF 处理)DeepSeekAPI:按 token 计费(可选,仅content-enrich时用)Obsidian:个人使用免费(商业版 $50/年,可选)
GPU 要求:
- 默认
semantic-lite模式:无需 GPU - 启用本地 embedding(
sentence-transformers):普通 CPU 即可 - 启用音频转录(
faster-whisper):建议 8GB+ 内存,无需 GPU
开源协议: MIT
💡 新用户福利:默认安装即用,0 元成本跑通全流程;DeepSeek API 月费通常不到 ¥10 就能加工 1000+ 条笔记。
🎯 总结
Chubby Skills 是 2026 年中文创作者最值得装进工具箱的"个人知识库操作系统"——把 13 个零散平台的内容源收编进统一管线,让 Obsidian vault 不再是孤岛,被 AI Agent 真正消费起来。
核心价值:
- 🎯 13 个 Skill = 覆盖你日常 95% 的中文内容消费
- 🧠 1 套 schema v1 = 让每条笔记都自带结构化元数据
- 🔌 1 个 MCP Server = 让 Claude Code / Codex 直接调用 vault
- 💾 本地优先 = 数据完全在你自己的硬盘上
推荐指数: ⭐⭐⭐⭐⭐(满分 5 星)
适合人群: 内容创作者 / 学习者 / 研究者 / Agent 开发者 / 知识工作者
立即体验:
- 📦 GitHub 仓库:chubbyguan/chubbyskills
- 📚 文档入口:
docs/quickstart.md - 🛠️ 工具入口:
tools/chubby.py
GitHub 仓库: chubbyguan/chubbyskills
数据截至 2026-07-02,最新信息请以 GitHub 仓库为准。