Browser Use
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../browseruse-recommend.pptx../../browseruse-recommend.mp4本文目录
📌 核心价值:用一句自然语言让 AI 替你操作浏览器——点按钮、填表单、抓数据,全自动。
还在为写 XPath、维护一碰就碎的爬虫脚本熬夜?Browser Use 让大模型像人一样"看"网页、"动手"操作,你只管说需求,剩下的交给 Agent。
🚀 什么是 Browser Use?
Browser Use 是一个 Python 开源库,定位是"Make websites accessible for AI agents"——让 AI 智能体像人类一样使用浏览器。它把当前页面的截图 + DOM 结构 + 可交互元素一起喂给大模型,模型判断"该点哪、填什么",再由底层的 Playwright 驱动真实 Chromium 执行,循环往复直到任务完成。
核心定位:它把"网站可访问性"做成了 AI 的原生能力,而不是再给开发者一套更底层的 API。
传统爬虫/自动化最大的痛点是"脆弱":网站改个 CSS 类名,XPath 就失效,脚本全盘崩。Browser Use 用 LLM 理解页面语义,具备官方所称的 self-healing(自愈) 能力——页面结构微调,只要功能没变,AI 照样能找到正确元素。


- Star: 110,024 ⭐ | Fork: 12,092 | 协议: MIT | 语言: Python
- 最新版本: 0.13.8(搭配 Browser Harness 0.1.9,2026-08 发布)
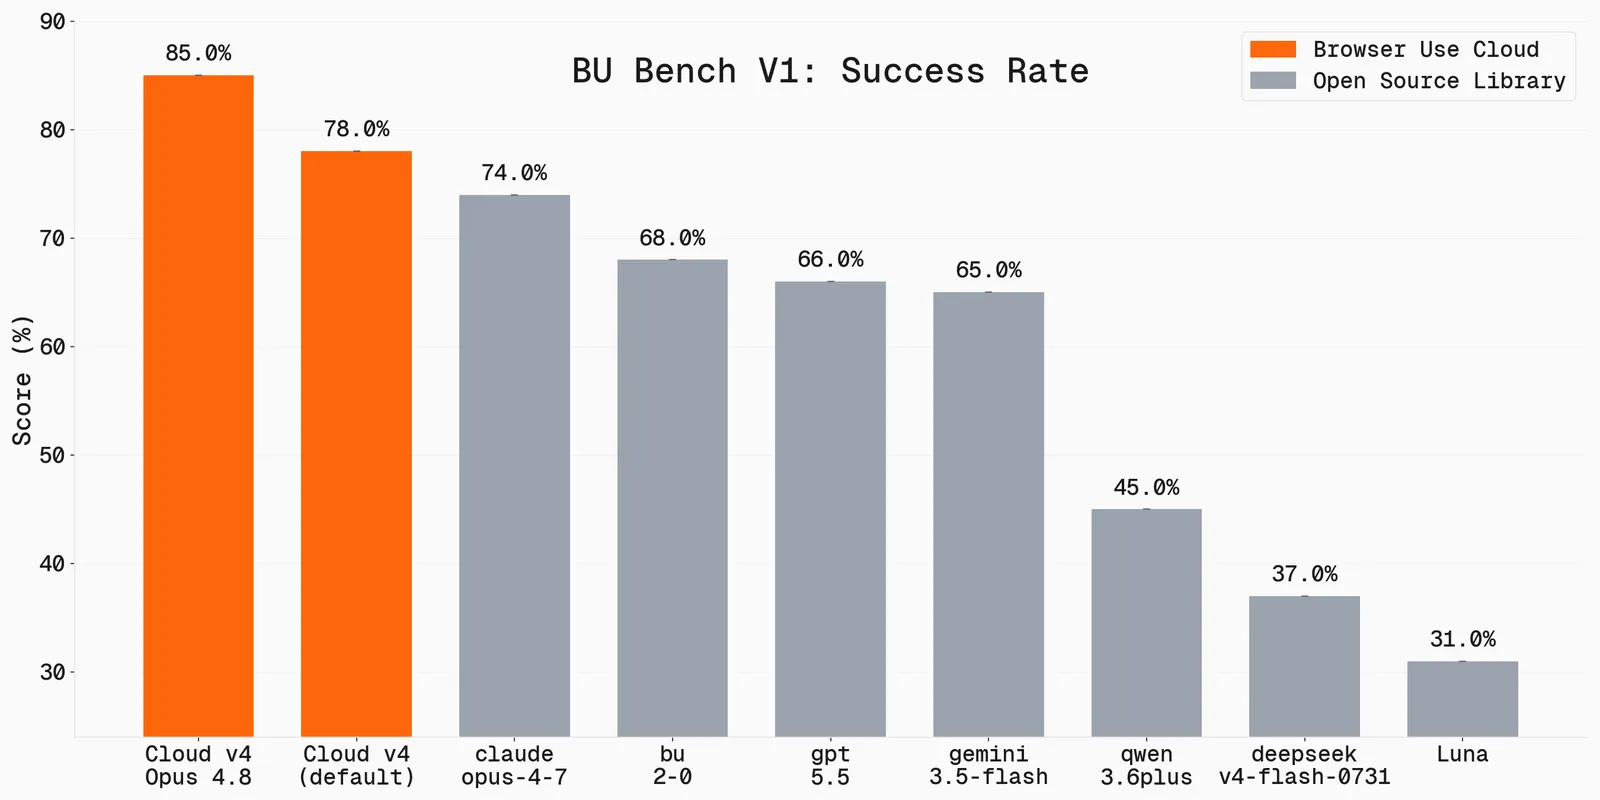
- 基准表现: 官方 Odyssey 排行榜平均 87.4%,同类排名第一
✨ 核心功能一览
Browser Use 在多项能力上和传统自动化工具拉开差距:AI 意图理解、自然语言控制、多步任务规划是它独占的优势,而自动等待、网络 Mock、多 Context 等现代能力也与 Playwright 并列领先。
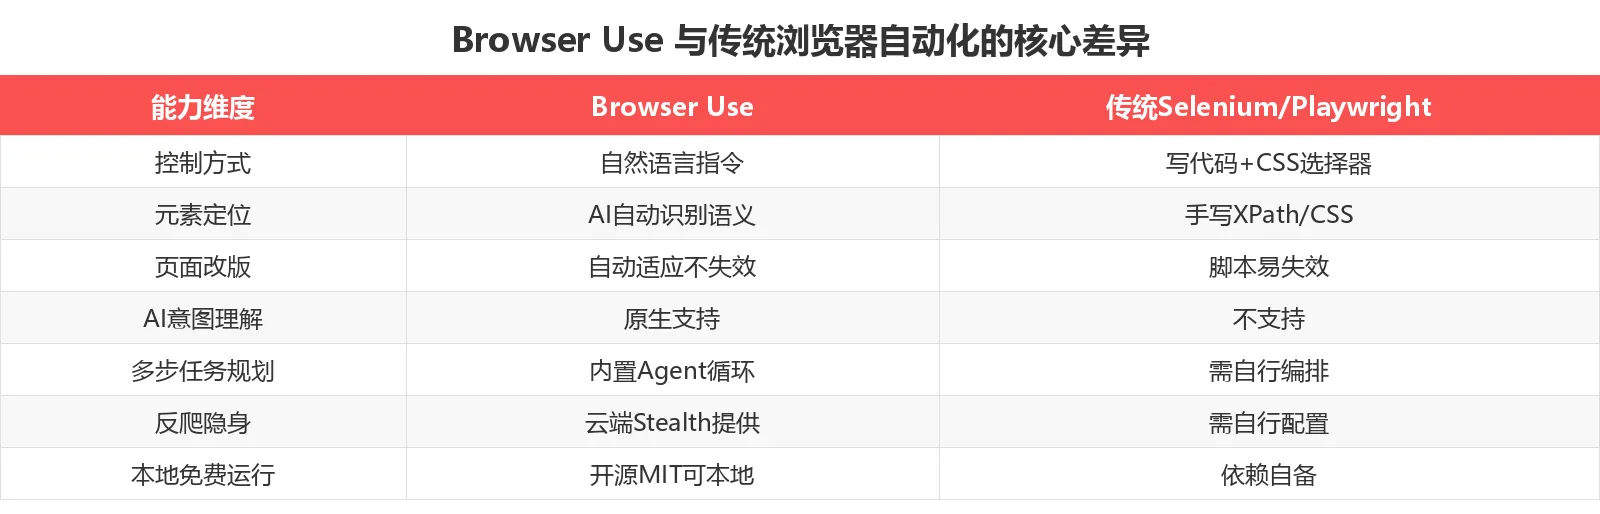
关键能力拆解:
- 📋 自然语言控制:
task="帮我把这份简历填进求职申请表",AI 自动拆步骤执行。 - 🍎 结构化数据提取:
"抓取我粉丝的数据并导出 CSV",直接返回 Markdown 表格。 - 🔧 自定义工具:用
@tools.action装饰器把你的 Python 函数注册成 Agent 可调用的工具(查天气、调内部 API 都行)。 - 🔌 MCP 兼容:可接入 Model Context Protocol 服务器,融入更大的 Agent 生态。
- 🛡️ 云端隐身:Cloud 版提供 Stealth 指纹伪装 + 代理轮换 + 验证码处理。
🛠️ 快速上手:5 分钟跑通
安装
# 推荐用 uv(也可 pip)
uv add browser-use
# 或
pip install browser-use

# 安装 Playwright 浏览器引擎(首次自动下载 Chromium)
playwright install chromium
核心代码示例(官方 Run your first agent)
import asyncio

from browser_use import Agent, ChatBrowserUse

async def main():
    agent = Agent(
        task="Find the number of stars of the browser-use repo",
        llm=ChatBrowserUse(model='openai/gpt-5.5'),
        # llm=ChatBrowserUse(model='bu-2-0-mini-preview'),  # 官方优化模型,更快更省
        # llm=ChatAnthropic(model='claude-opus-4-8'),       # 也支持 Claude
    )
    history = await agent.run()

if __name__ == "__main__":
    asyncio.run(main())
注意:本地开源版完全免费,但每一步都调用 LLM,高频批量任务要注意 API 成本;追求速度与性价比优先用官方 ChatBrowserUse 默认模型(官方称比通用模型快 3-5 倍)。
三种使用形态:
- Python 库——把浏览器 Agent 嵌入你自己的产品、做定时/并行任务。
- CLI Skill——已装有 Claude Code / Codex / Cursor 等 Agent 时,
browser-use skill install注册后即可让它帮你操作浏览器。 - Cloud API——
curl -X POST https://api.browser-use.com/api/v4/runs一行发起云端任务,免去本地浏览器管理。
📊 与竞品对比
除了功能维度,模型准确率也是硬指标。下图是官方公布的各模型在浏览器任务上的准确率表现(来自 GitHub README static/ 目录真实图表)。
把 Browser Use 和三大传统框架放在一起看,差异一目了然:
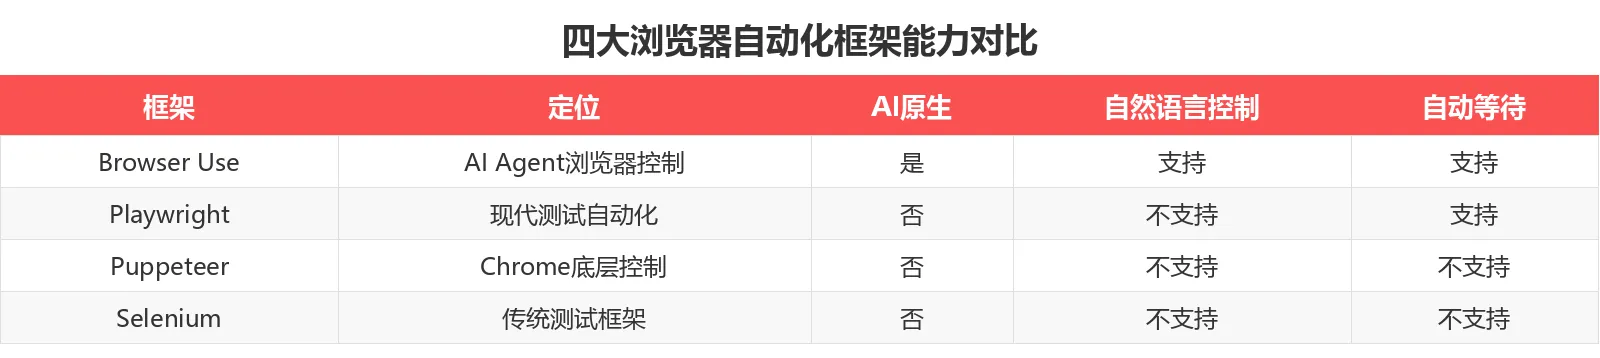
选型建议:
- 新项目做 AI Agent 浏览器控制 → Browser Use 是首选。
- 只需要纯脚本测试、且站点稳定有 API → Playwright 更轻。
- Selenium / Puppeteer → 维护遗留代码时保留,新项目几乎不再推荐。
💡 适用场景
场景 1:网页数据采集(告别脆弱爬虫)
功能说明:让 Agent 打开目标站点、滚动加载、定位元素、提取结构化数据并导出表格。 输入要求:一句自然语言任务描述(如"抓取 Hacker News 今天最热的 20 条帖子和点赞数")。 输出效果:干净的 Markdown / CSV / JSON,无需手写解析正则。 适用场景:竞品价格监控、社媒数据归档、研究资料收集。
场景 2:自动化填表与流程(像人一样操作)
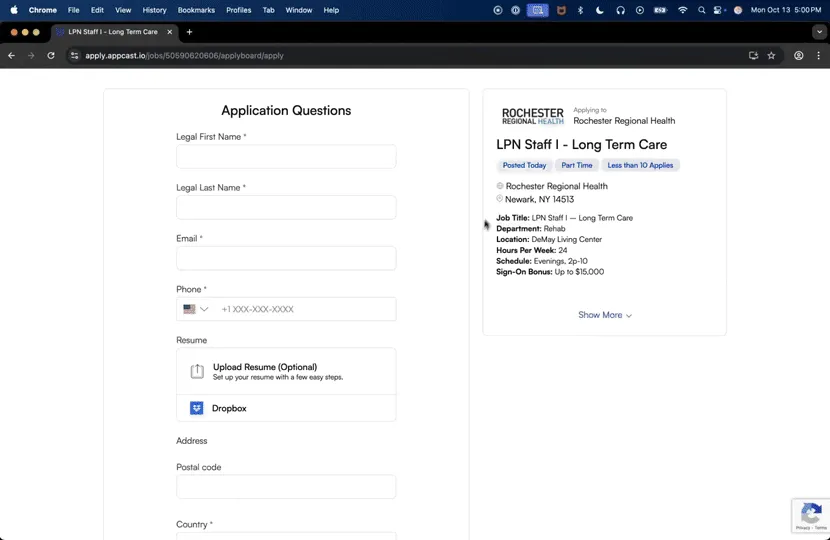
功能说明:多步表单填写、登录态保持、跨页面跳转,全部由 Agent 自主完成。
输入要求:清晰的任务指令 + 必要的凭据(可用本地已登录 Chrome 复用会话)。
输出效果:任务完成后的结果摘要,支持 --session 多实例并行互不干扰。
适用场景:批量报表提交、求职申请自动填、后台系统巡检。
用户群体总结
- ✅ 开发者 / 独立黑客:把重复网页操作自动化,省下写脚本的时间。
- ✅ 数据团队:构建 RAG 数据管道、实时网页监控,无需维护爬虫。
- ✅ AI Agent 构建者:作为"手和眼"嵌入自己的 Agent 产品。
- ❌ 不适合:目标站点已有稳定官方 API(直接调 API 更快更省);需要像素级精准截图(用 Puppeteer 更合适)。
💰 定价方案
- 开源版(MIT):永久免费,可完全本地运行,仅需自备 LLM API Key(OpenAI / Anthropic / Google / DeepSeek / 本地 Ollama 均可)。
- Cloud 版:托管浏览器基础设施——弹性集群、代理轮换、Stealth 指纹、验证码处理、高并发。新用户送 $10 起步额度。
💡 新用户福利:开源 MIT 永久免费,云端注册即送 $10 额度,先免费用透再决定是否付费。
开源协议: MIT
🎯 总结
Browser Use 把"AI 操作浏览器"从炫技变成了可落地的工程能力:自然语言驱动、自愈抗改版、模型无关、开源免费。在 AI Agent 成为浏览器"操作系统"的今天,它是每个想把网页任务自动化的开发者都值得装进工具箱的项目。
推荐指数: ⭐⭐⭐⭐⭐(满分 5 星)
适合人群: 开发者、数据工程师、AI Agent 产品团队
立即体验: Browser Use 官网
GitHub 仓库: browser-use/browser-use
数据截至 2026-08-22,最新信息请以官网为准。