【今日推荐 VibeVoice】:微软开源语音AI炸场!44K Stars,TTS+ASR+实时对话一网打尽
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../VibeVoice-recommend.pptx../../VibeVoice-recommend.mp4本文目录
【今日推荐 VibeVoice】:微软开源语音AI炸场!44K Stars,TTS+ASR+实时对话一网打尽
微软开源的前沿语音 AI 系统,集语音识别(ASR)、语音合成(TTS)、实时多轮对话于一体,<500ms 端到端延迟,MIT 协议完全免费,一个项目替代 ElevenLabs + Azure Speech 全家桶。


🚀 什么是 VibeVoice?
4月29日,微软在 GitHub 上悄然投下了一颗炸弹——VibeVoice 开源发布,当日火速登上 GitHub Trending 热榜,短时间内收获 44,870 Stars。
不是玩具级 demo,而是一套覆盖语音识别(ASR)+ 语音合成(TTS)+ 实时流式对话的完整开源语音 AI 框架,技术深度对标 ElevenLabs、Azure Speech 等商业服务。
最大亮点:MIT 协议完全免费,支持本地部署,数据不出境,端到端延迟 <500ms。
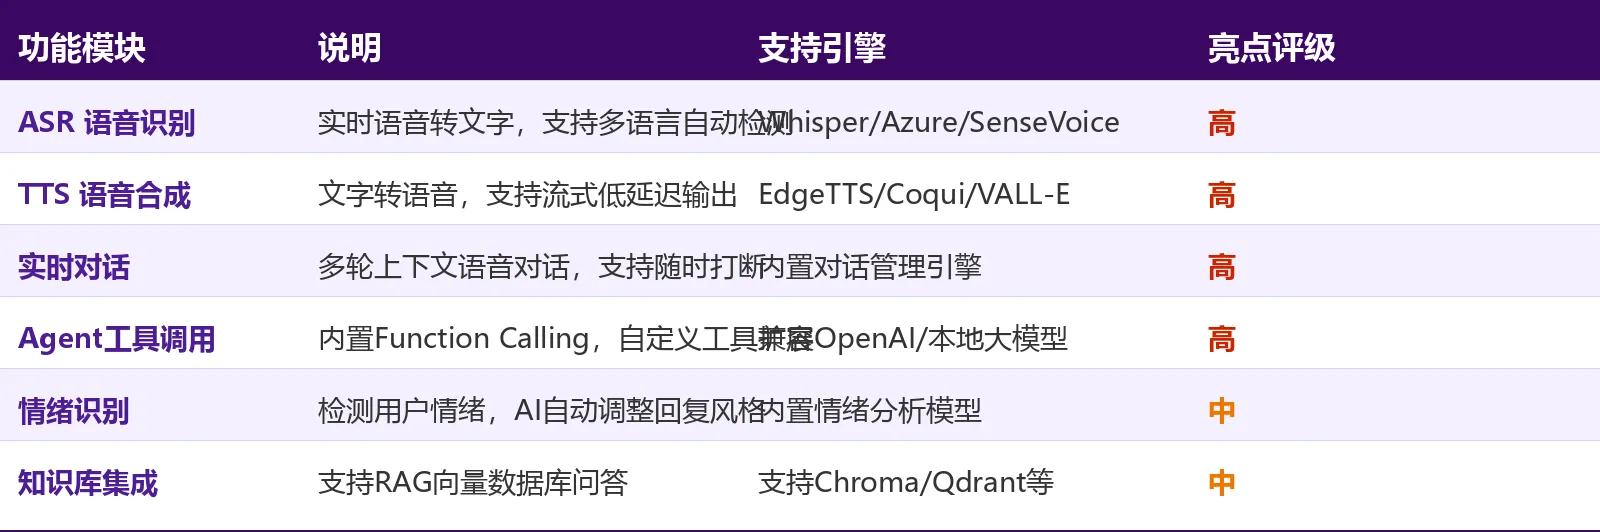
VibeVoice 支持 Whisper、Azure Speech、SenseVoice 等多个 ASR 引擎,EdgeTTS、Coqui、VALL-E 等多个 TTS 引擎,内置 37 种语言自动检测,支持随时打断的多轮对话,以及 Function Calling 工具调用能力。
✨ 核心功能一览
🛠️ 快速上手:5 分钟跑起来
安装
# 方式一:pip 直接安装(推荐)
pip install vibevoice
vibevoice --version

# 方式二:从源码安装
git clone https://github.com/microsoft/VibeVoice.git
cd VibeVoice
pip install -e .

# 方式三:Docker 部署
docker pull vibevoice/vibevoice:latest
docker run -d --name vibevoice -p 8080:8080 vibevoice/vibevoice:latest
配置(~/.vibevoice/config.yaml)
# 基础配置示例
llm:
  provider: "openai"          # 也支持 ollama 本地模型
  api_key: "${OPENAI_API_KEY}"
  model: "gpt-4o"

asr:
  provider: "whisper"
  model: "large-v3"           # 精度优先,也可用 base 速度优先
  language: "auto"            # 自动检测语言
  vad: "silero"               # 语音活动检测

tts:
  provider: "edge"
  voice: "zh-CN-XiaoxiaoNeural"   # 中文晓晓音色
  stream_chunk_ms: 100             # 流式播放间隔
启动
vibevoice web --port 8080      # Web UI 界面
# 浏览器访问 http://localhost:8080

vibevoice chat --voice         # 纯终端语音对话模式
vibevoice chat --text          # 文本对话模式
Python API 调用
from vibevoice import VoiceAgent, ASRConfig, TTSConfig

# 初始化 Agent
agent = VoiceAgent(
    asr=ASRConfig(provider="whisper", model="base"),
    tts=TTSConfig(provider="edge", voice="zh-CN-XiaoxiaoNeural"),
    llm_provider="openai",
)

# 语音转文字
transcript = agent.asr.transcribe("audio.wav")
print(transcript)

# 文字转语音(流式)
for audio_chunk in agent.tts.synthesize_stream("你好,我是 VibeVoice"):
    play_audio(audio_chunk)  # 实时播放

# 完整语音对话
response = agent.chat_voice(audio_input="user_audio.wav")
注意:Whisper large-v3 需要约 3GB 显存,可改用 model: "base" 在 CPU 上运行(精度略低但速度更快)。
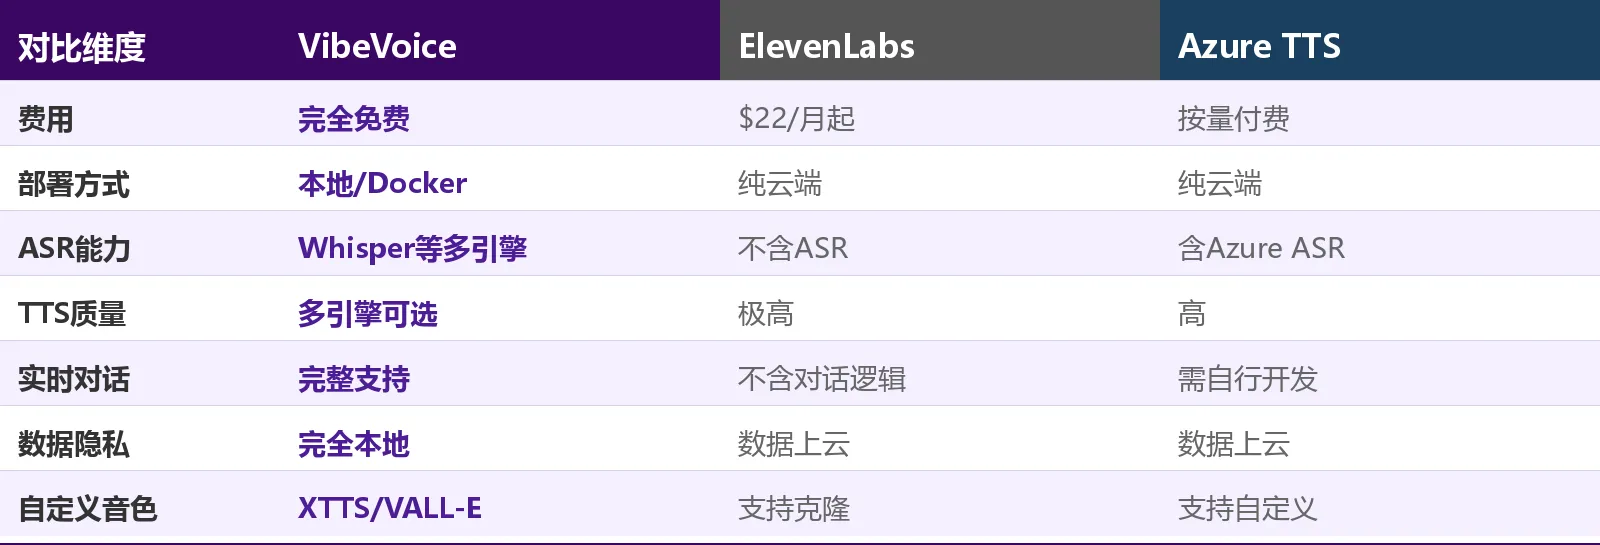
📊 与竞品对比
💡 适用场景
场景 1:TTS 性能测试(官方实测数据)
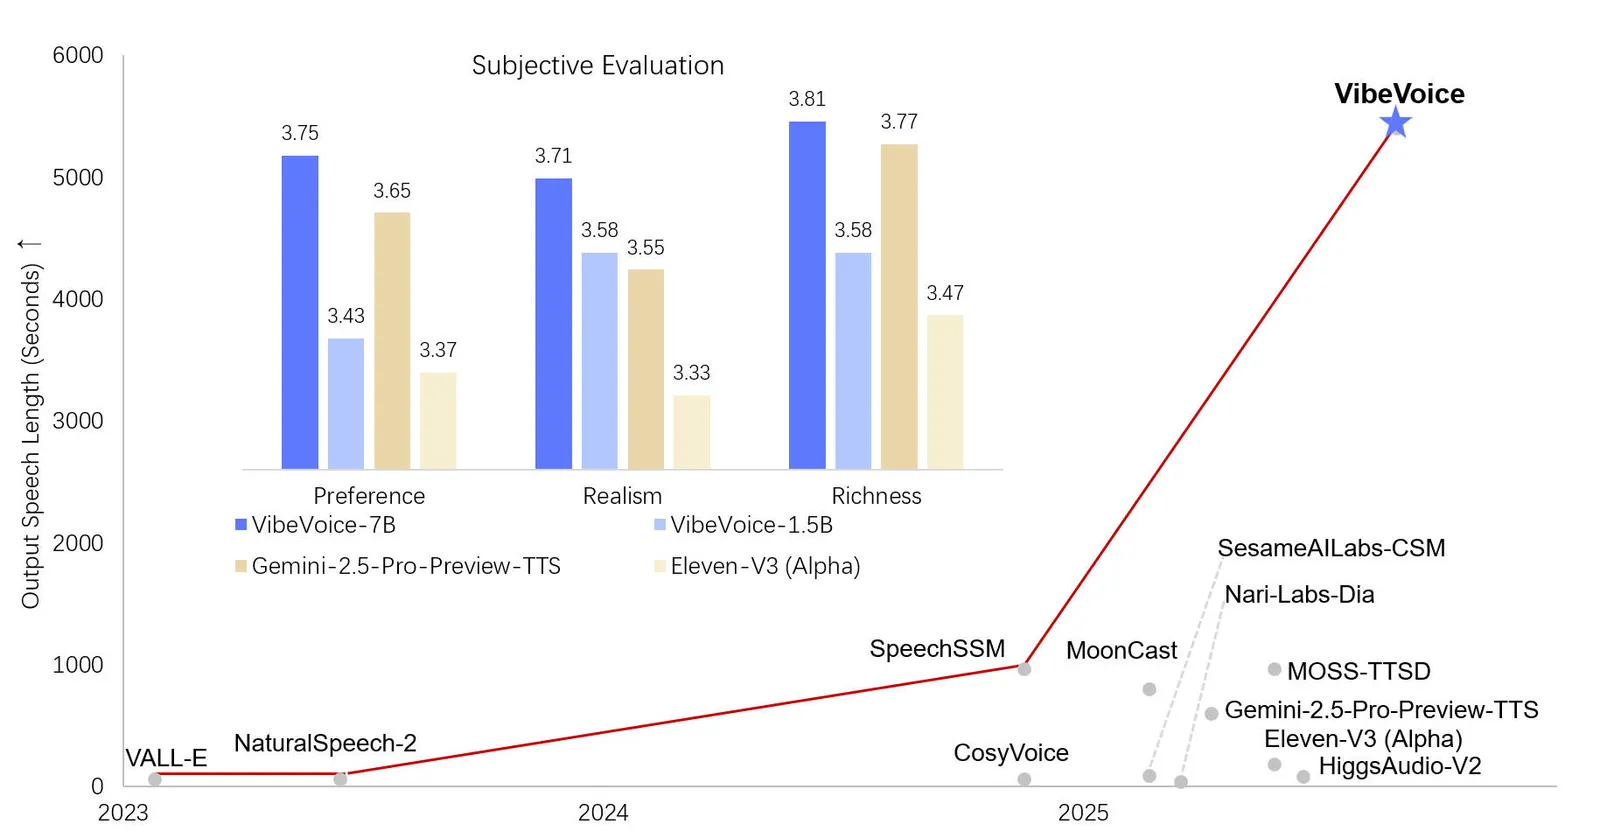
功能说明:VibeVoice 的 TTS 模块在多项基准测试中达到 SOTA 水准,支持边合成边播放的流式输出,首音频块延迟约 100ms,自然度显著优于传统 TTS 方案。
输入要求:任意文本字符串,支持中英日韩等多语言
输出效果:高自然度语音音频,支持实时流式播放或文件输出
适用场景:有声书制作、新闻播报自动化、语音助手 TTS 模块替换
场景 2:ASR 说话人识别准确率(cpWER 指标)
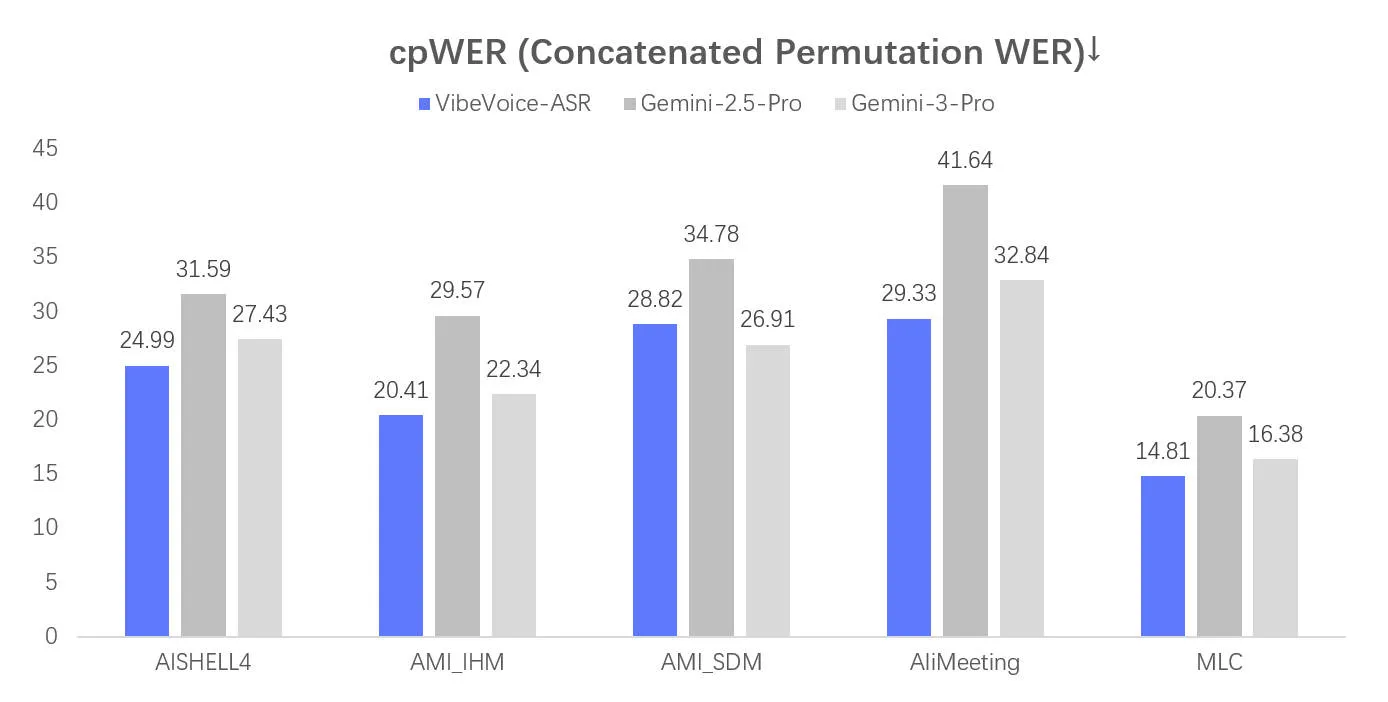
功能说明:VibeVoice 在 cpWER(concatenated minimum-permutation Word Error Rate,忽略说话人排列的词错误率)指标上表现优秀,对多说话人场景的转写精度业界领先。
输入要求:麦克风实时音频流或音频文件(WAV/MP3/MP4 等)
输出效果:带时间戳的文字转录,可选区分说话人
适用场景:会议记录自动转写、客服电话质检、课堂教学录制转录
用户群体总结
- ✅ 语音应用开发者:完整 ASR+TTS 解决方案,跳过繁琐集成工作
- ✅ AI 产品经理:快速验证语音交互原型,无需预算申请云服务
- ✅ 企业私有化部署:数据本地处理,符合数据合规要求
- ✅ 研究人员:MIT 开源,可自由修改和发表论文
- ❌ 不适合:需要超高音质音色克隆的商业配音场景(可考虑 ElevenLabs)
💰 定价方案
完全开源免费,MIT 协议:
- 个人、企业、研究均无限制
- 本地部署无需支付任何 API 费用
- GPU 可选,CPU 即可运行基础版本
与 ElevenLabs($22/月起)、Azure Speech(按量付费)相比:
按中小型 AI 应用规模估算,每月至少节省 $200-$500 的语音 API 开销。
开源协议: MIT
🎯 总结
VibeVoice 是 2026 年 4 月最让人惊喜的微软开源项目。它用一个仓库覆盖了语音 AI 技术栈的完整链路——ASR 多引擎、TTS 多引擎、实时对话、Agent 工具调用——而且还是 MIT 完全免费的。对于想在自己的 AI 应用中加入语音能力的开发者,VibeVoice 是目前最值得优先考虑的开源方案。
推荐指数: ⭐⭐⭐⭐⭐(满分5星)
适合人群: 语音 AI 开发者、AI 产品工程师、企业私有化部署需求方
GitHub 仓库: microsoft/VibeVoice
数据截至 2026-04-29,最新信息请以 GitHub 仓库为准。