VGGT-Omega
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../VGGT-Omega-recommend.pptx../../VGGT-Omega-recommend.mp4本文目录
🔥 VGGT-Omega:CVPR 2026 Oral 收录,Meta联手牛津打造下一代3D重建基础模型
单向前向传播即可输出高精度3D场景,显存仅需前代30%——3D重建从此告别迭代优化
🚀 什么是 VGGT-Omega?
VGGT-Omega 是由牛津大学视觉几何组(VGG)与 Meta AI联合开发的新一代多视图视觉理解模型。作为 VGGT 的进化版本,它在 CVPR 2026 Oral 论文中展示了革命性的架构设计与性能突破。
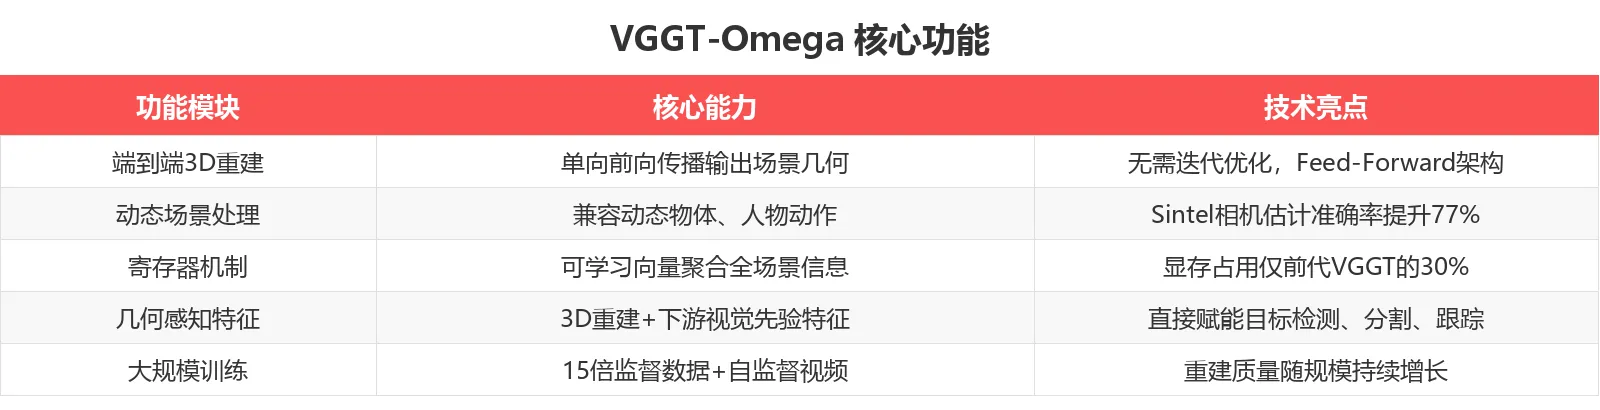
该模型的核心能力是:给定一组同一场景的多张图像,通过单向前向传播(Feed-Forward),直接输出相机位姿、深度图、3D点云和几何感知特征。整个过程无需任何迭代优化,从分钟级压缩到毫秒级。
核心定位:首个支持动态场景的Feed-Forward 3D重建模型,显存效率提升3倍


✨ 核心功能一览
🛠️ 快速上手:5 分钟跑通示例
安装 / 注册
# 1. 克隆仓库
git clone https://github.com/facebookresearch/vggt-omega.git
cd vggt-omega

# 2. 安装依赖
pip install -r requirements.txt
pip install -e .

# 3. 下载预训练模型 (两种版本)
# VGGT-Omega-1B-512: 高分辨率,无文本对齐
# VGGT-Omega-1B-256-Text-Alignment: 低分辨率,支持文本对齐
模型权重托管在 HuggingFace
核心代码示例
import torch
from vggt_omega.models import VGGTOmega
from vggt_omega.utils.load_fn import load_and_preprocess_images
from vggt_omega.utils.pose_enc import encoding_to_camera

# 加载模型
checkpoint_path = "checkpoints/VGGT-Omega-1B-512/model.pt"
image_names = ["imageA.png", "imageB.png", "imageC.png"]

model = VGGTOmega().to("cuda").eval()
model.load_state_dict(torch.load(checkpoint_path, map_location="cpu"))

# 预处理多视图图像
images = load_and_preprocess_images(image_names, image_resolution=512).to("cuda")

# 前向传播 — 一次推理,全部输出
with torch.inference_mode():
    predictions = model(images)

# 解码结果
extrinsics, intrinsics = encoding_to_camera(
    predictions["pose_enc"],
    predictions["images"].shape[-2:],
)
depth = predictions["depth"]
depth_conf = predictions["depth_conf"]
注意:使用文本对齐版本时需设置 VGGTOmega(enable_alignment=True),分辨率改为256
交互式 Gradio Demo
# 安装演示依赖
pip install -r requirements_demo.txt

# 启动 Demo 服务
python demo_gradio.py \
  --checkpoint checkpoints/VGGT-Omega-1B-512/model.pt \
  --image-resolution 512
Demo 支持上传单图/多图/视频,自动渲染深度反投影点云和GLB 3D场景中的相机轨迹。
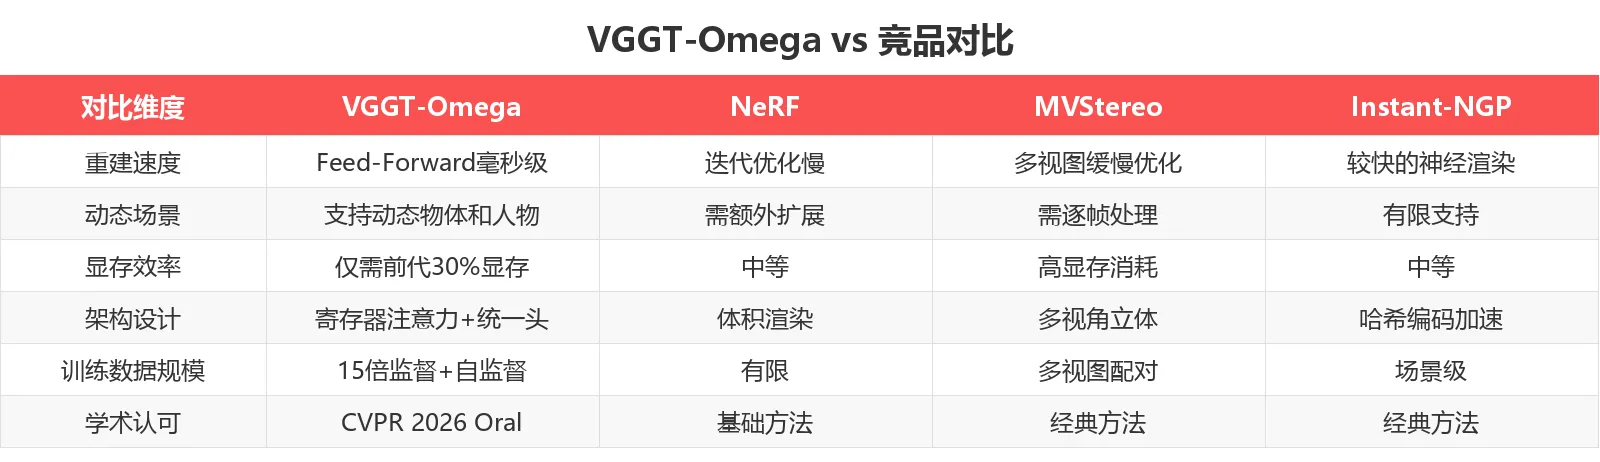
📊 与竞品对比
💡 适用场景
端到端3D重建工作流
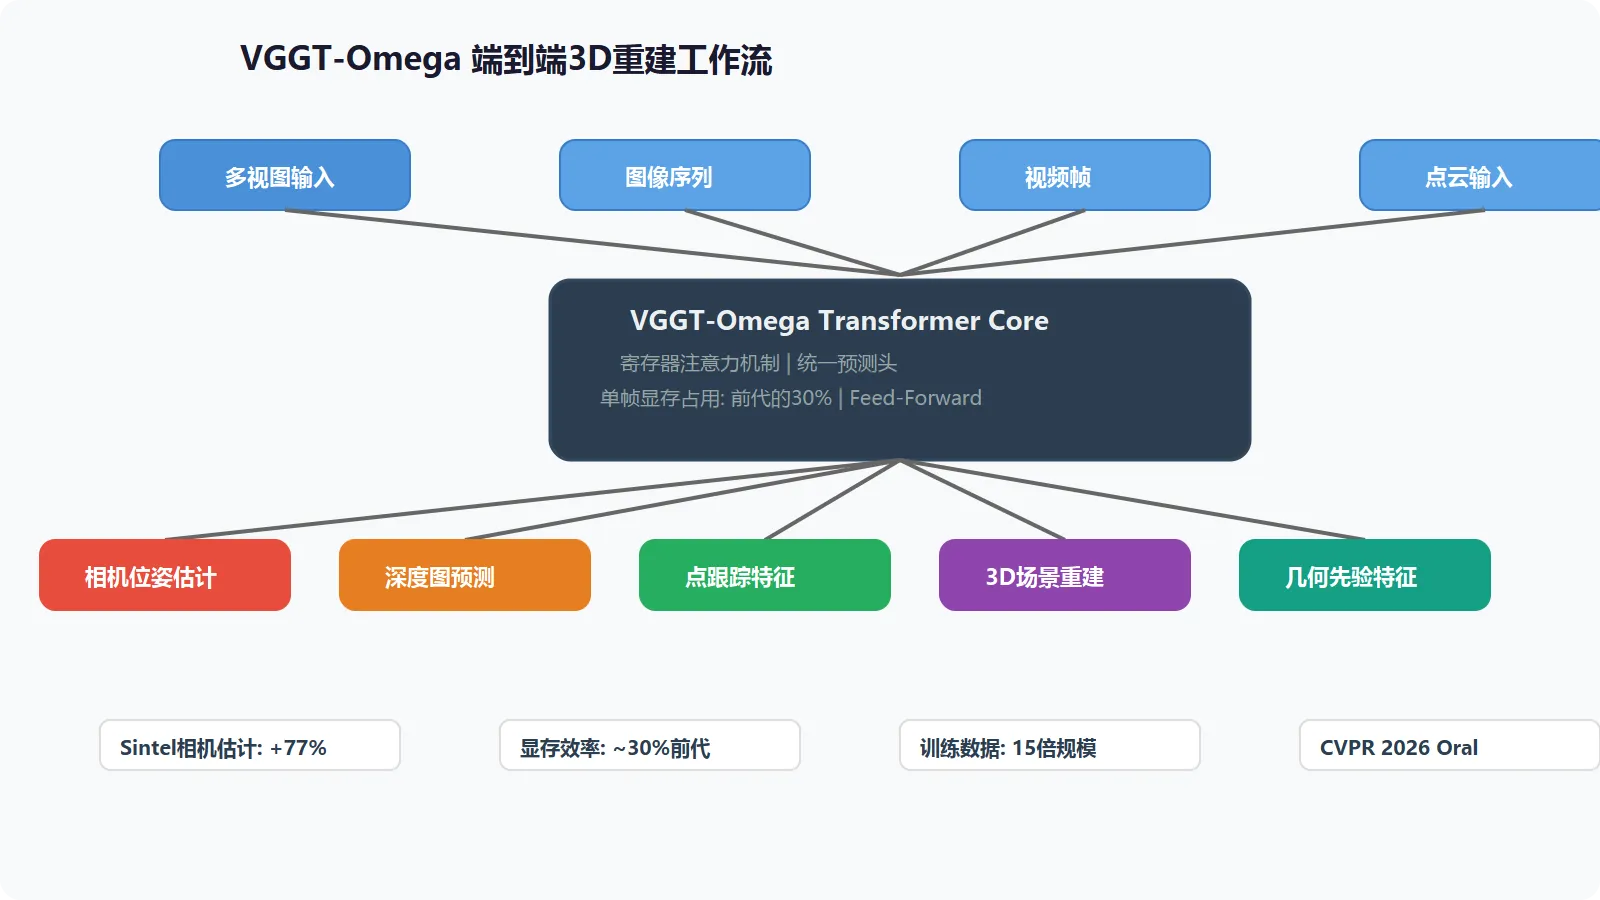
功能说明:VGGT-Omega 将多视图图像处理、相机位姿估计、深度预测整合到统一的Transformer架构中。输入一组图像或视频帧,输出完整的3D场景信息——包括相机内外参、逐像素深度图、3D点坐标和几何感知特征。整个过程是单向前向传播,无需传统的bundle adjustment或梯度下降优化。
输入要求:同一场景的多张图像(≥2帧)或视频序列,图像分辨率最高512×512
输出效果:相机位姿、深度图、深度置信度、点跟踪特征表、3D重建点云
适用场景:数字孪生建模、影视后期3D场景重建、自动驾驶仿真环境生成
寄存器注意力机制
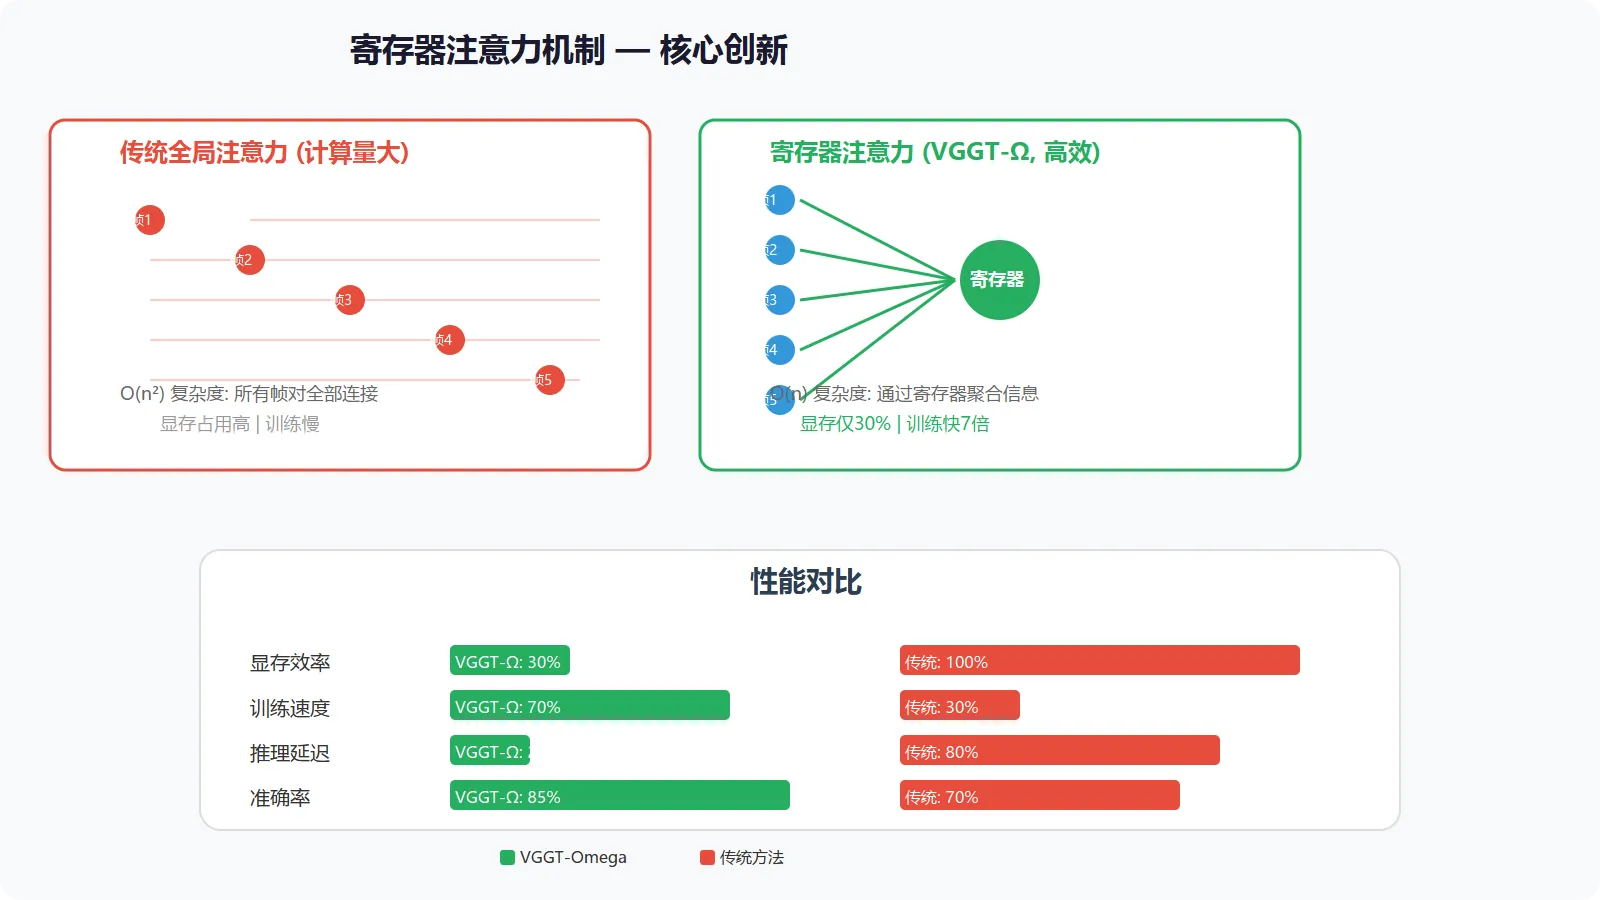
功能说明:这是VGGT-Omega最核心的技术创新。传统Transformer在多视图处理中使用全局注意力,每帧之间的注意力计算复杂度为O(n²)。VGGT-Omega引入了可学习的寄存器向量,将全场景信息聚合到一个紧凑表示中。寄存器作为"信息中介",大幅降低了帧间注意力计算量,使显存占用仅为前代VGGT的约30%,同时训练速度提升7倍。
输入要求:模型权重文件,CUDA支持GPU
输出效果:显著降低训练/推理显存开销,支持更大规模数据训练
适用场景:大规模视频数据集训练、长序列图像处理、实时3D重建推理
四大核心应用场景
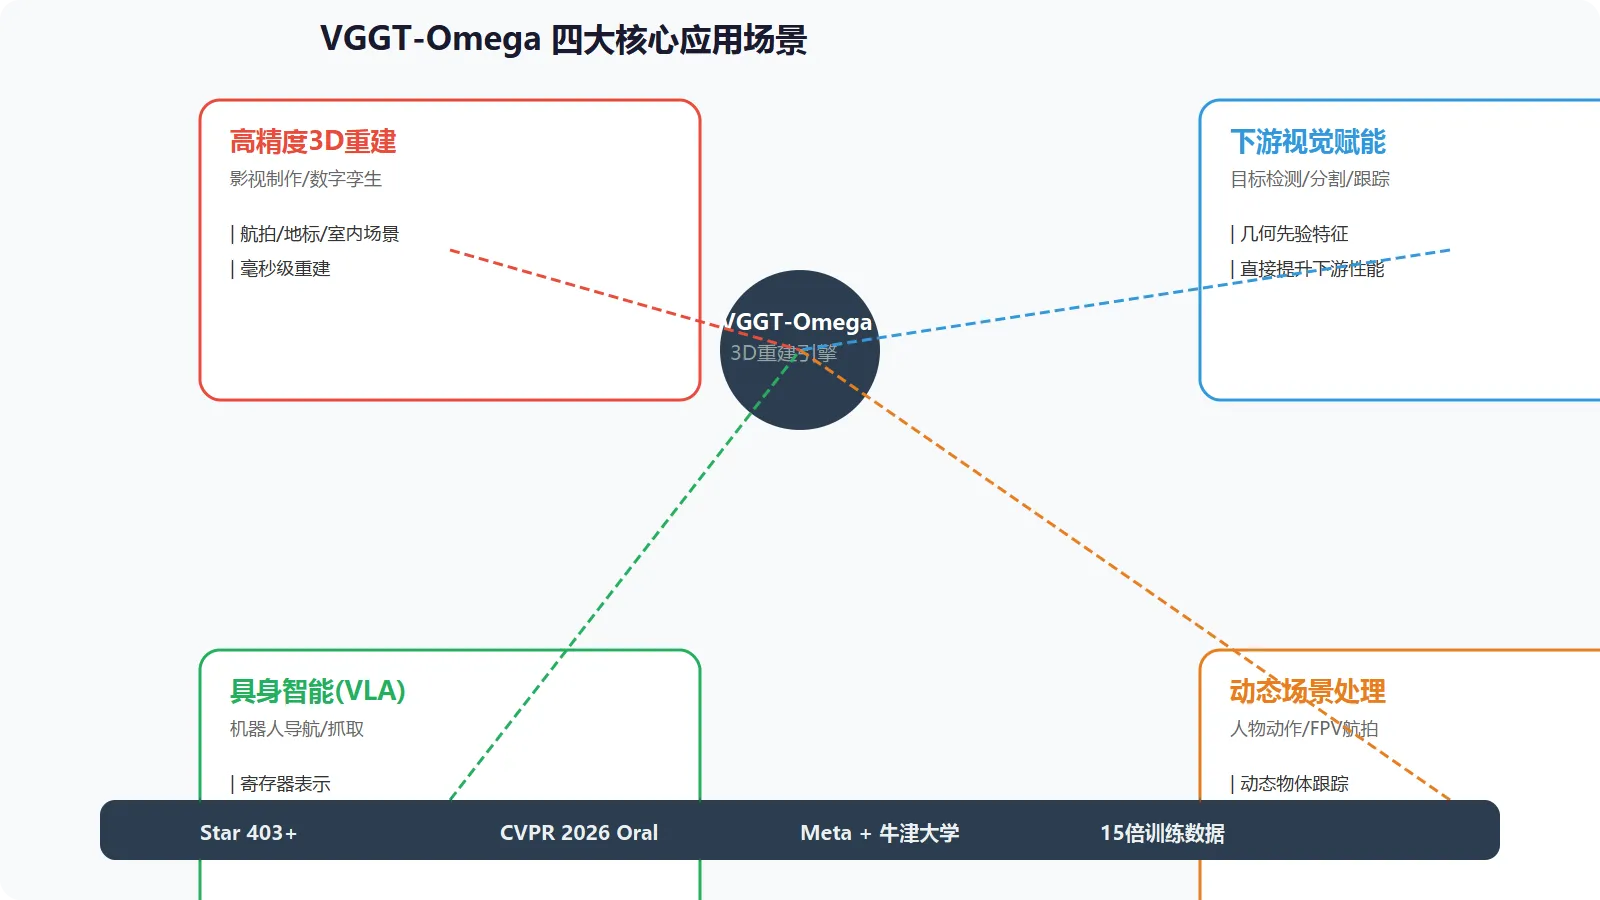
功能说明:VGGT-Omega的几何感知特征输出为下游视觉任务提供了强大的空间先验。除了3D重建本身,模型还可用于目标检测、语义分割、多目标跟踪等任务。寄存器表示可直接输入到视觉-语言-动作(VLA)模型中,提升机器人的空间理解能力。
输入要求:预训练权重,下游任务微调数据
输出效果:下游任务性能提升,机器人导航/抓取精度改善
适用场景:
- 影视制作:从实拍素材快速提取3D场景,加速后期制作
- 机器人具身智能:提供3D几何先验,提升导航和抓取精度
- 自动驾驶:实时从车载摄像头重建周围动态场景
- 电商:商品3D化展示、虚拟试穿
用户群体总结
- ✅ 3D视觉研究者:寄存器机制提供全新研究方向,OpenSource可复现
- ✅ 计算机视觉工程师:直接集成到现有 pipeline,减少迭代优化环节
- ✅ 自动驾驶/机器人开发者:动态场景重建能力填补空白
- ✅ 影视/数字孪生从业者:快速从实拍素材生成3D资产
- ❌ 纯2D视觉任务:如果不需要3D信息,不必使用此模型
💰 定价方案
开源协议: 详见 LICENSE (Meta Research 研究许可)
预训练模型下载:
| 模型版本 | 输入分辨率 | 文本对齐 | 下载入口 |
|---|---|---|---|
| VGGT-Omega-1B-512 | 512×512 | 否 | HuggingFace |
| VGGT-Omega-1B-256-Text-Alignment | 256×256 | 是 | HuggingFace |
免费使用:研究许可协议,免费用于学术研究和开发
本地部署要求: GPU显存≥24GB(推荐RTX 3090/4090)
🎯 总结
VGGT-Omega 是目前最先进的Feed-Forward 3D重建模型。它在多项基准测试上创下了新记录:Sintel数据集相机估计准确率提升77%,显存效率提升3倍,训练规模扩大15倍。寄存器注意力机制是3D视觉领域的重要突破,为下一代空间理解AI奠定了坚实基础。
推荐指数:⭐⭐⭐⭐⭐(满分5星)
适合人群: 3D视觉研究者、自动驾驶开发者、机器人具身智能工程师
在线体验: Project Page
GitHub 仓库: facebookresearch/vggt-omega
论文: arXiv:2605.15195
数据截至 2026-05-17,最新信息请以官网为准。