UniRL
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../UniRL-recommend.pptx../../UniRL-recommend.mp4本文目录
📌 核心价值:一套RL后训练回路打通文本、图像、视频多模态模型
腾讯混元团队开源的统一多模态强化学习框架,支持扩散模型、LLM、统一架构模型,含 Flow-DPPO 与 DRPO 两大自研算法。
🚀 什么是 UniRL?
UniRL(Unified + Ni + RL,意为"统一多模态智能所需的强化学习")是腾讯混元团队开源的分布式强化学习后训练框架。
核心定位: 一套 RL 后训练循环,统一覆盖文本、图像、视频等多模态生成模型的 RL 对齐训练。
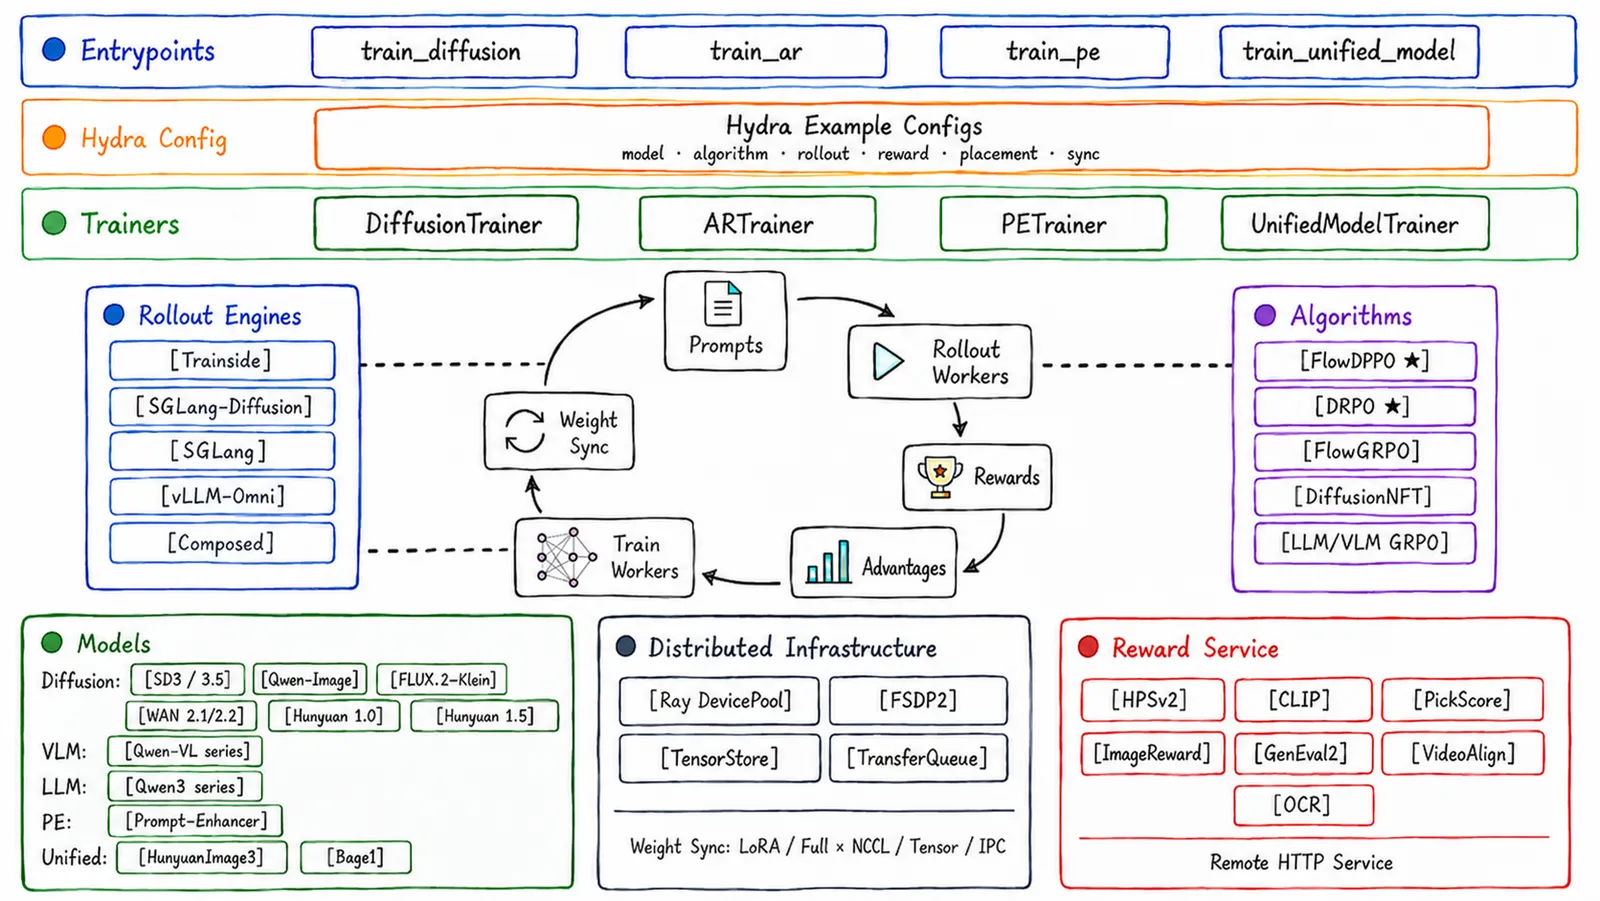
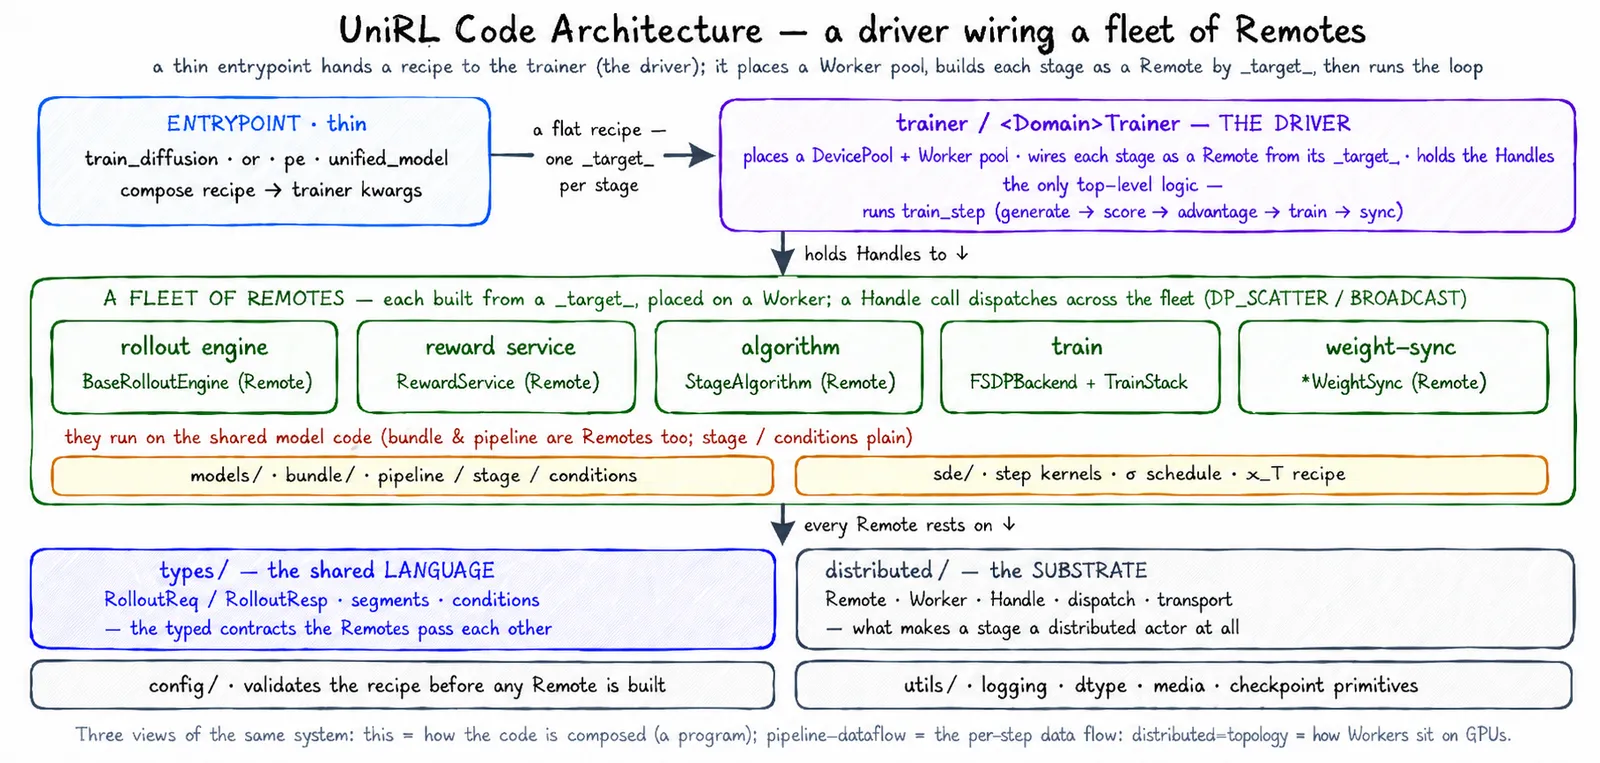
核心理念:UniRL 将强化学习的五个步骤——生成样本、评分打分、计算优势、更新策略、同步权重回滚动工作节点——抽象为一条通用的后训练回路,不绑定单一模态或单一训练栈,以 Ray Worker Group + Hydra Flat Recipe + 可组合训练后端 + 可插拔 Rollout Engine 为骨架,实现不同模态模型的统一 RL 训练。**
GitHub: Tencent-Hunyuan/UniRL ⭐ Stars: 581+ | 🍴 Forks: 32+ | 📅 发布时间:2026年5月
✨ 核心功能一览
一、两大自研 RL 算法
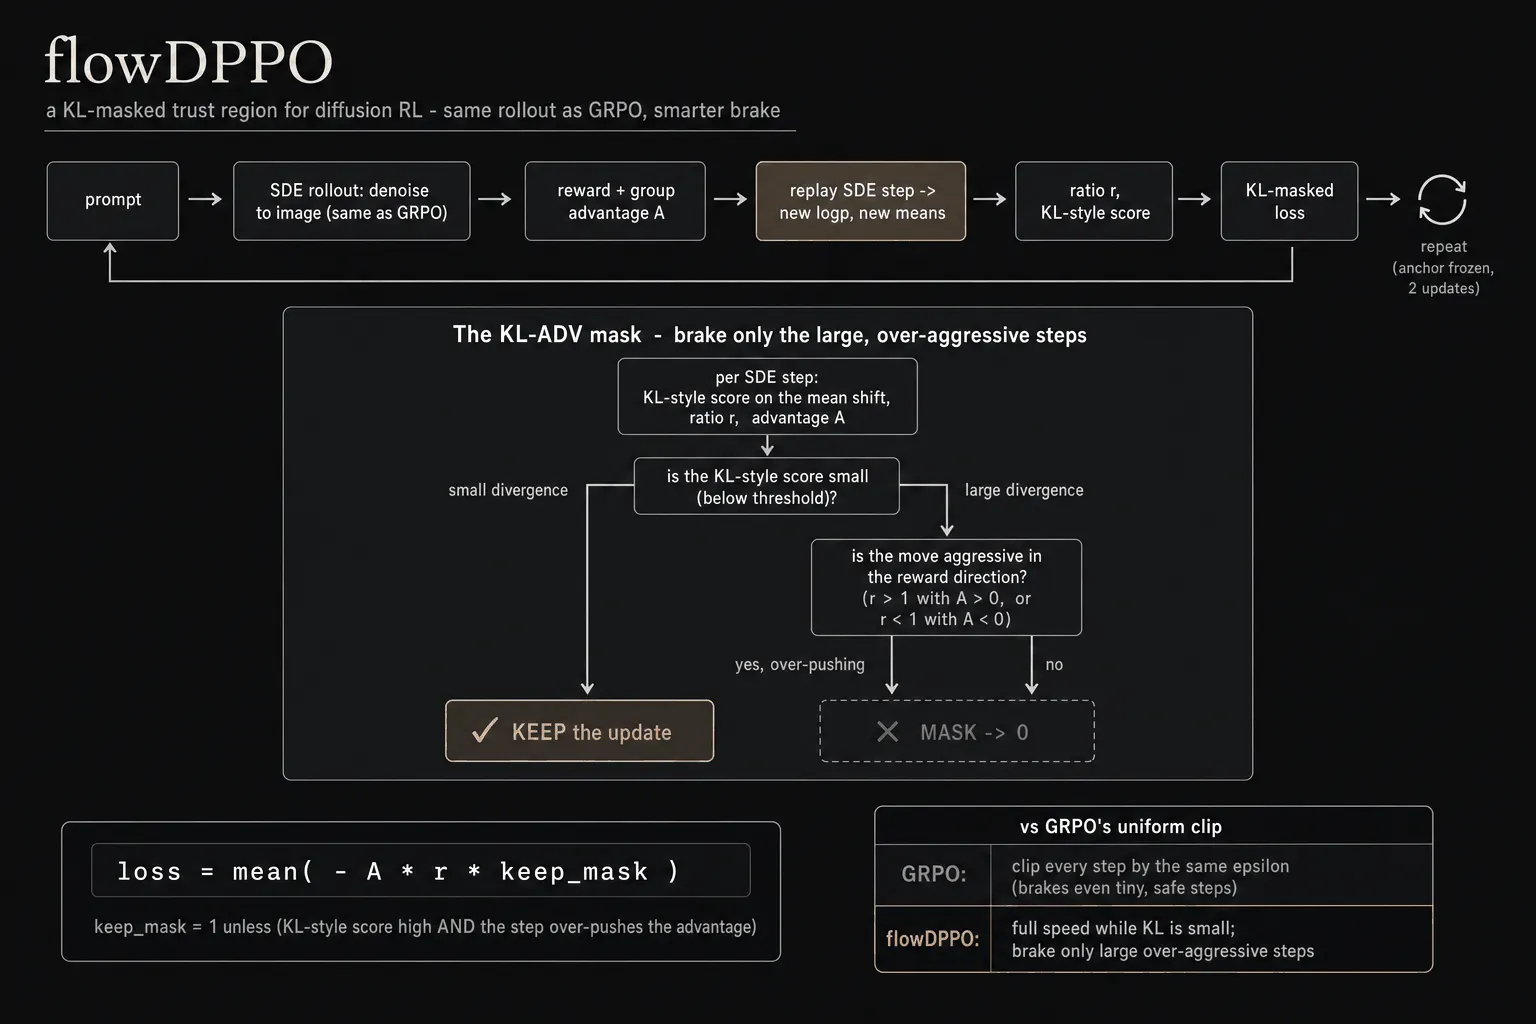
1. Flow-DPPO:扩散模型的信赖域 RL
论文:FlowDPPO: Divergence Proximal Policy Optimization for Flow Matching Models
- 专为扩散模型/流匹配模型设计的 RL 算法
- 使用基于准确散度的信赖域掩码(exact divergence-based trust region mask)
- 防止扩散模型 RL 训练中的策略崩溃和模式退化
2. DRPO:LLM RL 的正则化新思路
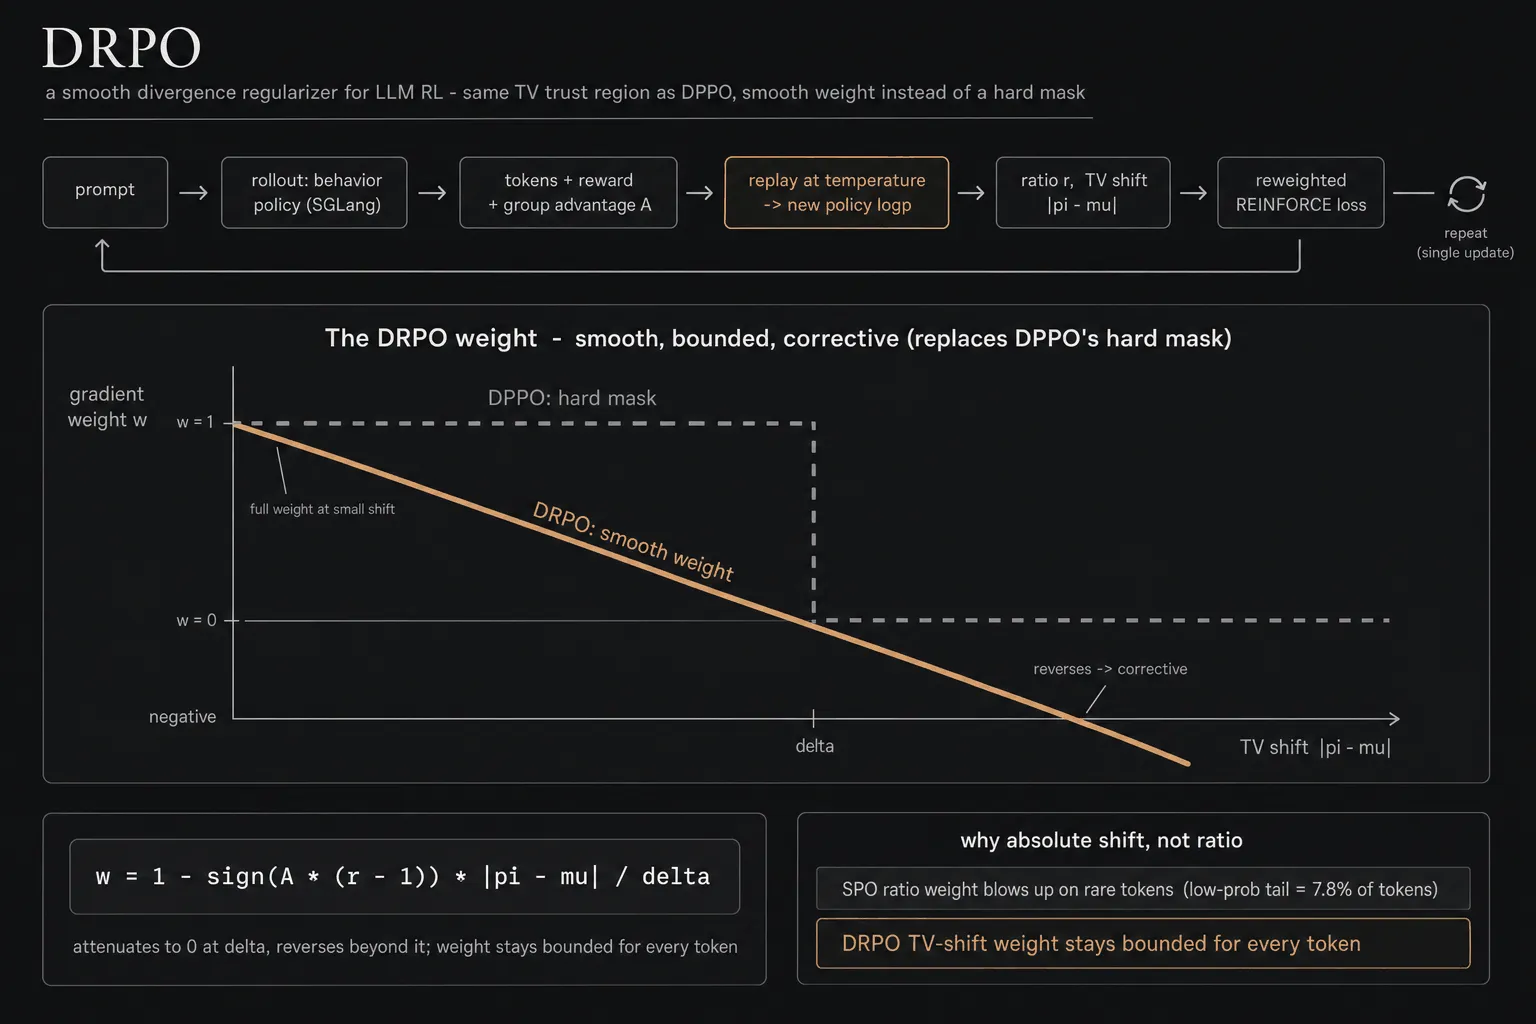
论文:Rethinking the Divergence Regularization in LLM RL
- 针对大语言模型 RL 后训练的分层 KL 散度正则化方法
- 在 Token 级别采用平滑优势加权二次正则化项
- 缓解 GRPO/PPO 中常见的策略崩溃问题
二、广泛的多模态模型支持
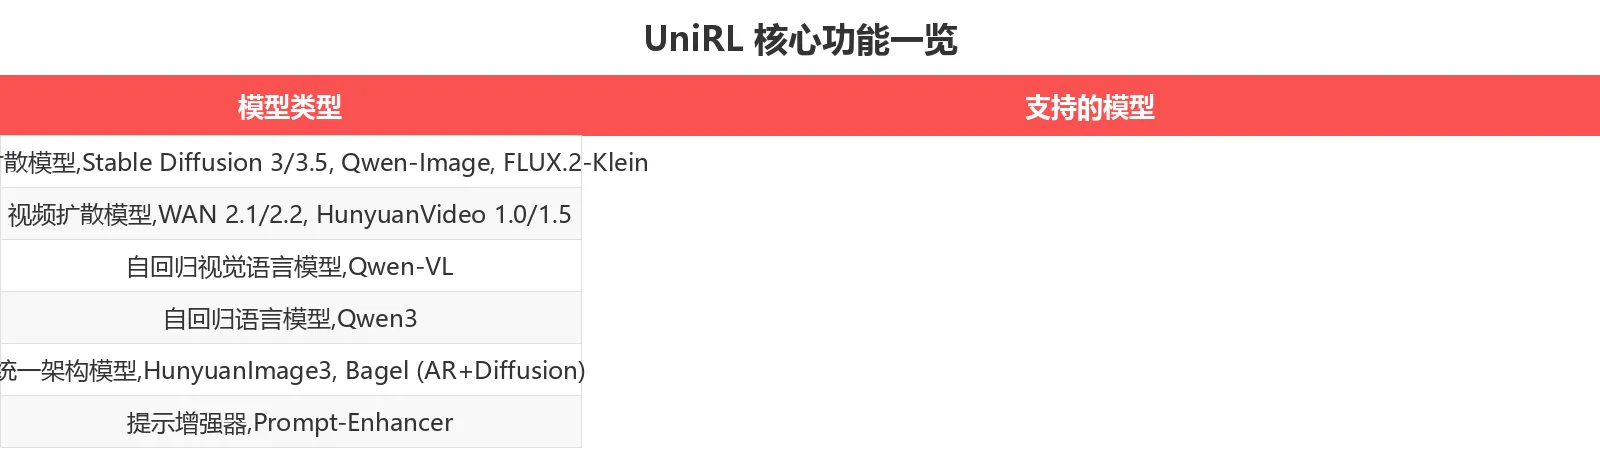
| 模型类型 | 支持的模型 |
|---|---|
| 图像扩散模型 | Stable Diffusion 3/3.5, Qwen-Image, FLUX.2-Klein |
| 视频扩散模型 | WAN 2.1/2.2, HunyuanVideo 1.0/1.5 |
| 自回归视觉语言模型 | Qwen-VL |
| 自回归语言模型 | Qwen3 |
| 统一架构模型 | HunyuanImage3, Bagel (AR + Diffusion) |
| 提示增强器 | Prompt-Enhancer |
三、模块化架构设计
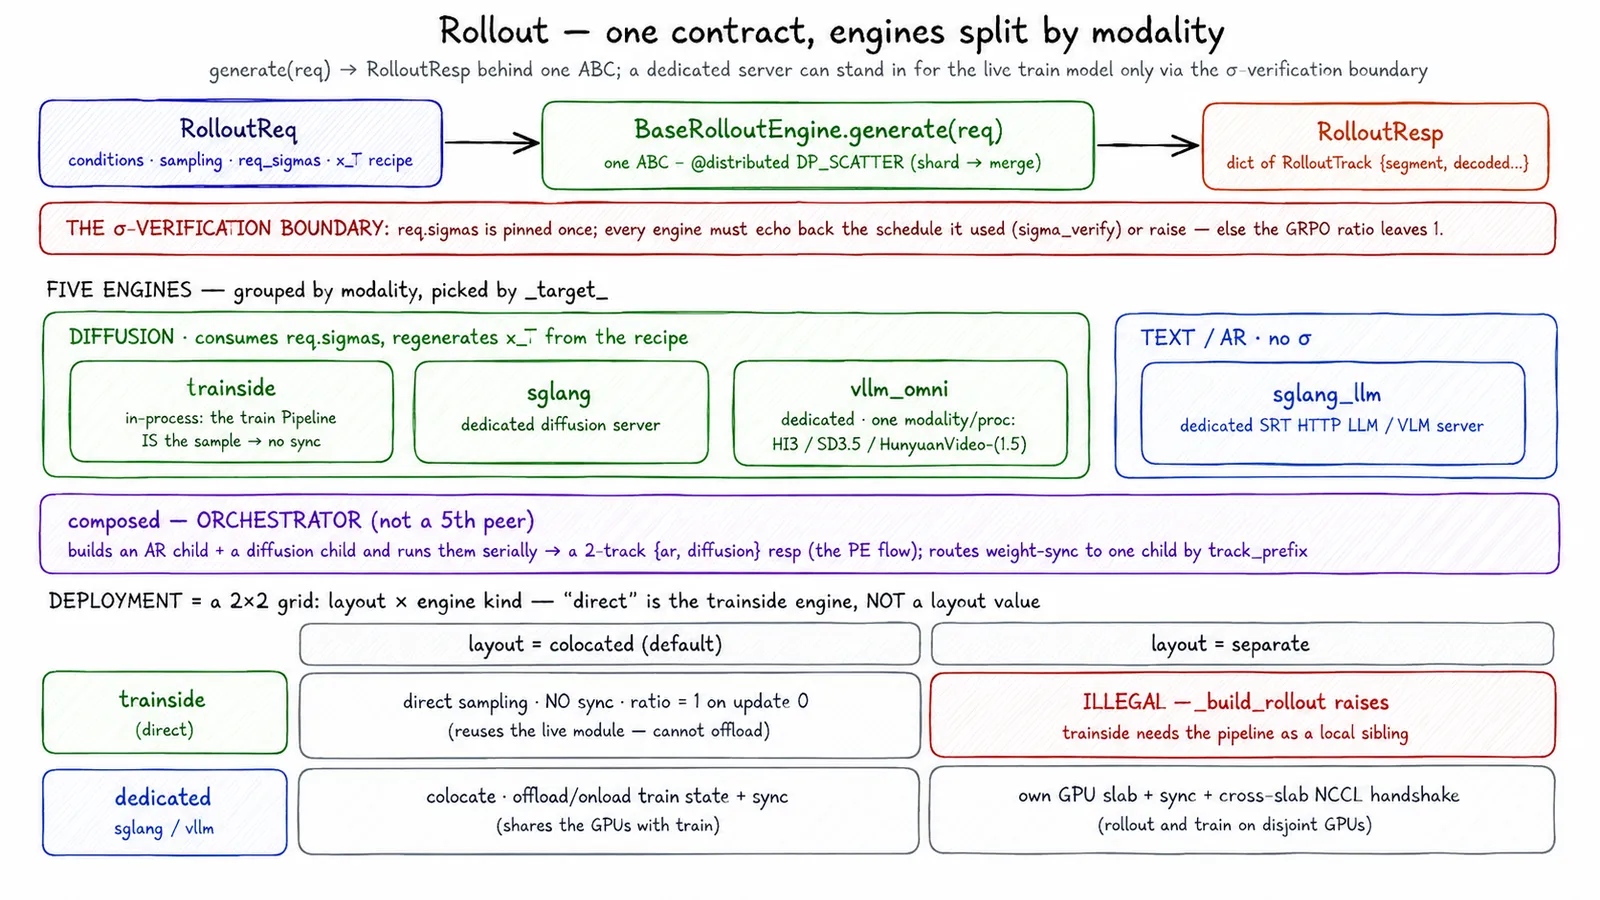
- 可插拔 Rollout Engine:vLLM / SGLang 自由切换
- 可插拔 Algorithm:Flow-DPPO / DRPO / GRPO / DiffusionNFT / DanceGRPO / MixGRPO
- 可插拔 Reward Service:不同模态的奖励计算解耦
- 可插拔 Model Bundle:新模型接入只需注册
🛠️ 快速上手:5 分钟跑通示例
安装
# 克隆仓库
git clone https://github.com/Tencent-Hunyuan/UniRL.git
cd UniRL

# 安装依赖
pip install -e .

# 检查配置是否正确
python -m unirl.train_diffusion --config-name=diffusion/sd3_trainside --cfg job --resolve
运行扩散模型 RL 训练
# 使用 SGLang rollout 在 SD3 上运行示例
bash examples/run_experiment_single_node.sh diffusion/sd3_sglang_rollout_colocate
运行 LLM RL 训练
# Qwen3 + DRPO + SGLang Rollout
bash examples/run_experiment_single_node.sh ar/qwen3_drpo_4b_base_dapo_sglang
运行 VLM RL 训练
# Qwen-VL + GRPO + Geo3K 数据集
bash examples/run_experiment_single_node.sh ar/qwen_vl_grpo_geo3k_mc_4x8
注意:UniRL 为分布式框架,推荐在多 GPU 服务器上运行,需配置 Ray Worker Group。
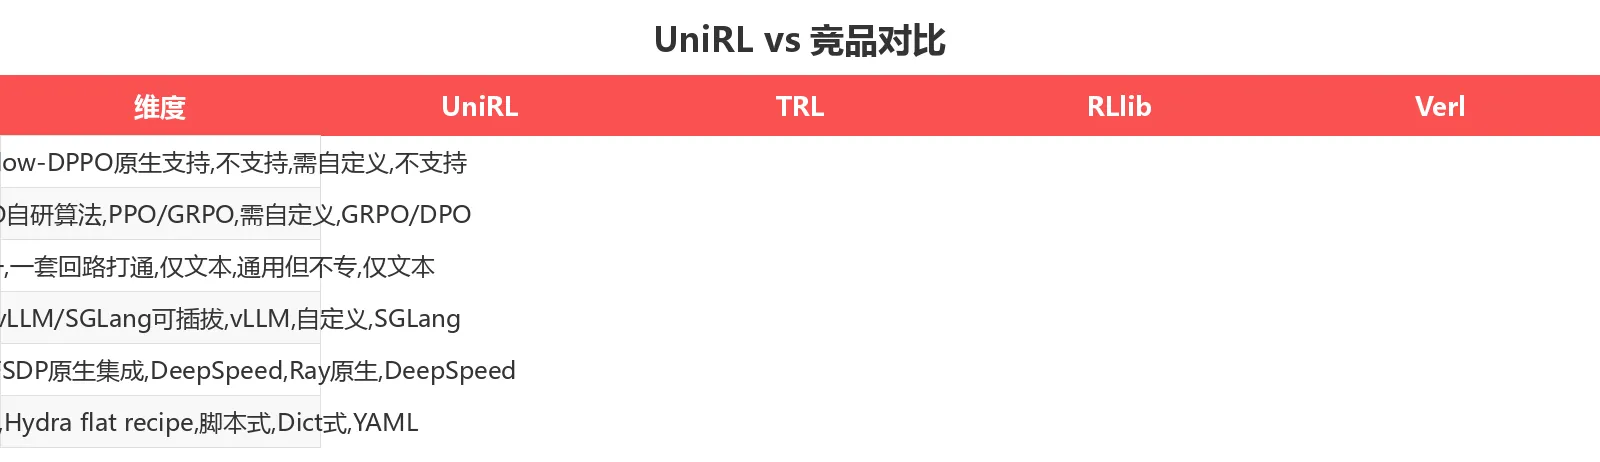
📊 与竞品对比
💡 适用场景
场景 1:多模态大模型 RL 对齐训练
如果你有多个不同模态的模型需要统一 RL 后训练,UniRL 提供了标准化的 RL 回路和算法实现,无需从零搭建。
输入:预训练的扩散模型/LLM/VLM + 奖励模型 输出:RL 对齐后的多模态模型权重
适用:AI Lab、大模型研究团队
场景 2:扩散模型 RL 算法研究和实验
Flow-DPPO 的信赖域掩码机制为扩散模型 RL 提供了新的正则化思路。
输入:扩散模型基座 + 自定义奖励函数 输出:Flow-DPPO 训练曲线 + 对齐后模型
适用:扩散模型研究人员、RL 算法研究员
场景 3:LLM RL 后训练工程化
DRPO 算法针对 LLM RL 中的策略崩溃问题,提出了 Token 级别的正则化方案。结合 SGLang/vLLM 的高效 rollout,可实现大规模 LLM RL 训练。
输入:Qwen3 等开源 LLM + 人类偏好数据 输出:RL 对齐后的对齐模型
适用:LLM 厂商、大模型对齐团队
💰 定价方案
完全开源免费,Apache License 2.0 协议。
无需 API Key,无需付费,在本地 GPU 集群上即可运行。
💡 亮点:作为一个来自大厂的高质量开源 RL 框架,UniRL 免费提供所有算法实现和分布式基础设施,大幅降低多模态 RL 训练的研究门槛。**
🎯 总结
UniRL 是目前业界唯一一个将扩散模型、视频模型、LLM、统一架构模型统一在一条 RL 后训练回路中的开源框架。腾讯混元团队在扩散模型 RL(Flow-DPPO)和 LLM RL(DRPO)两个方向上的原创贡献,使它在多模态 RL 领域占据了独特的生态位。
推荐指数: ⭐⭐⭐⭐⭐(满分5星)
适合人群: 大模型研究者、RL 算法工程师、多模态 AI 研发团队
GitHub 仓库: Tencent-Hunyuan/UniRL
数据截至 2026年06月14日,最新信息请以官网为准。