🔥 【今日推荐 TimesFM】:Google 开源的时间序列预测基础模型,零样本直接用!
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../TimesFM-recommend.pptx../../TimesFM-recommend.mp4本文目录
🔥 【今日推荐 TimesFM】:Google 开源的时间序列预测基础模型,零样本直接用!
Google Research 打造的时间序列"大模型",在 1000 亿真实世界时间点上预训练,无需重新训练即可应用于股票预测、销量预测、能源负荷预测等场景,ICML 2024 论文,GitHub 已获 15,000+ Stars。


🚀 什么是 TimesFM?
时间序列预测是数据分析中最核心的任务之一——从销量预测到股价走势,从能源消耗到流量监控,几乎所有行业都离不开它。然而传统方法(ARIMA、LSTM、Prophet)有一个共同的痛点:必须针对每个业务场景重新收集数据、训练模型,周期长、门槛高。
TimesFM(Time Series Foundation Model)是 Google Research 于 2024 年推出的时间序列基础模型,发表于 ICML 2024 顶会。它的核心思路和 GPT 一样:先用海量数据预训练一个通用模型,然后"零样本"直接用于新任务,不需要针对特定领域重新训练。
核心突破:TimesFM 是全球首批在真实基准上达到 SOTA 的时间序列基础模型之一,在多项公开测试集上,零样本效果甚至超过了专门为该数据集训练的有监督模型!
最新版本 TimesFM 2.5(2025 年 9 月发布)将参数量压缩到 200M,上下文长度提升到 16K,并支持连续分位数预测——既轻量又强大,还进入了 Google BigQuery 官方产品,用云服务直接调用。
项目信息:
- GitHub:https://github.com/google-research/timesfm
- HuggingFace:https://huggingface.co/collections/google/timesfm-release-66e4be5fdb56e960c1e482a6
- 论文:A decoder-only foundation model for time-series forecasting(ICML 2024)
- 开源协议:Apache License 2.0
- 当前版本:TimesFM 2.5(200M 参数,16K 上下文)
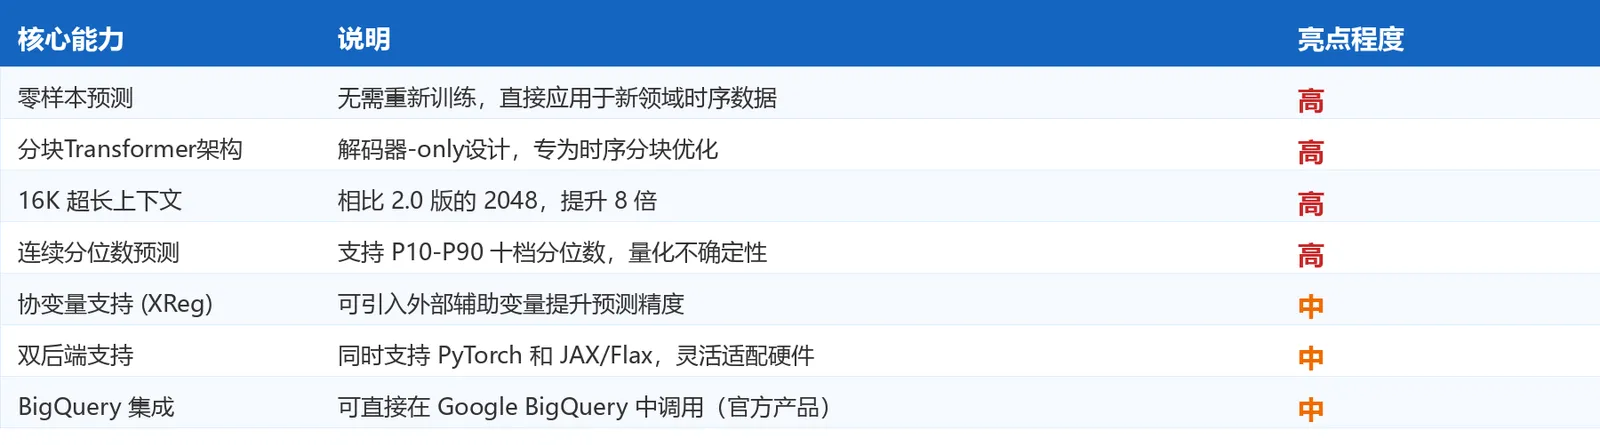
✨ 核心功能一览
🏗️ 技术架构
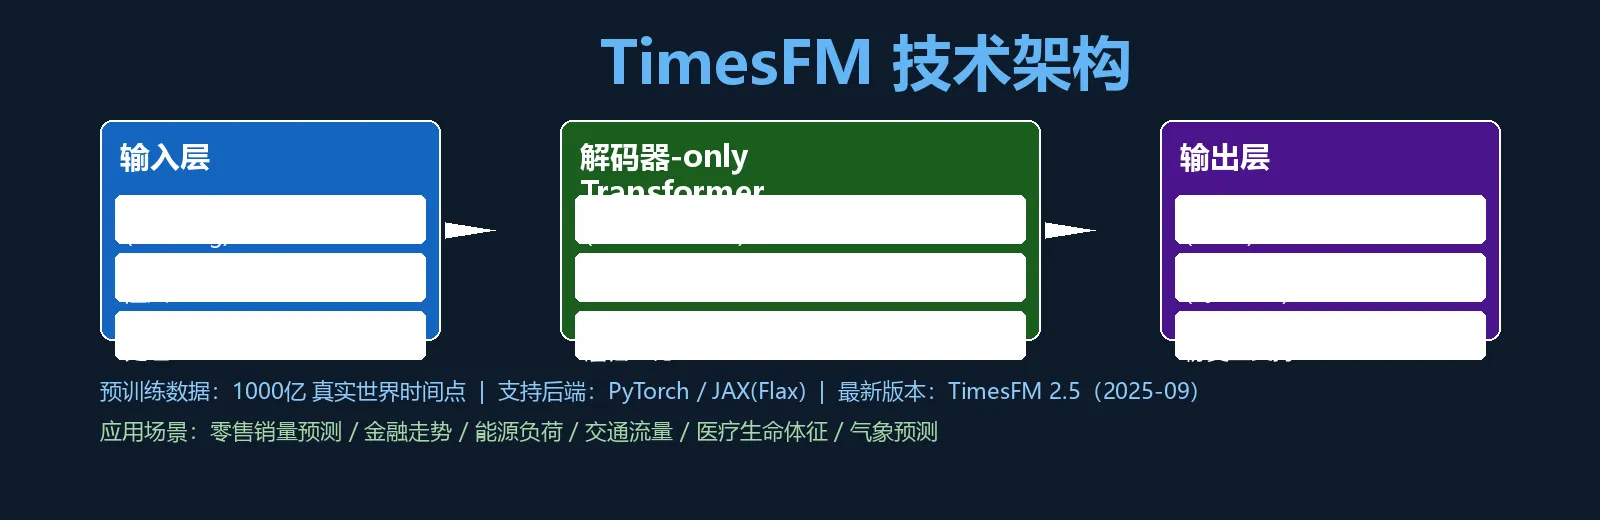
TimesFM 采用 解码器-only(Decoder-only)Transformer 架构,和 GPT 系列是同一类设计,只是把"词"换成了"时间步分块":
- 输入层:将时间序列切分成固定大小的"块"(Patch),注入位置编码,并对缺失段进行掩码填充
- 解码器 Transformer:堆叠多层自注意力 + 前馈层,学习时间序列的内在规律(趋势、季节性、周期性)
- 输出层:同时输出点预测(均值)和分位数预测(P10~P90),可选接入 XReg 协变量模块
🛠️ 快速上手:5 分钟跑通预测
安装
# 方式一:直接 pip 安装(推荐,最快)
pip install timesfm

# 方式二:源码安装(支持最新功能)
git clone https://github.com/google-research/timesfm.git
cd timesfm

# 安装 PyTorch 版
uv pip install -e ".[torch]"

# 或安装 JAX/Flax 版(TPU 用户推荐)
uv pip install -e ".[flax]"

# 需要协变量支持时
uv pip install -e ".[xreg]"
注意:TimesFM 2.5 需要 Python 3.10+,PyTorch 版要求 PyTorch >= 2.0,JAX 版要求 JAX >= 0.4.25
最简代码示例(3 行核心代码)
import torch
import numpy as np
import timesfm

# 1. 设置精度(可选,提升推理速度)
torch.set_float32_matmul_precision("high")

# 2. 加载预训练模型(自动从 HuggingFace 下载)
model = timesfm.TimesFM_2p5_200M_torch.from_pretrained(
    "google/timesfm-2.5-200m-pytorch"
)

# 3. 配置预测参数
model.compile(
    timesfm.ForecastConfig(
        max_context=1024,          # 输入上下文长度
        max_horizon=256,           # 最大预测步数
        normalize_inputs=True,     # 自动归一化输入
        use_continuous_quantile_head=True,  # 启用分位数预测
        force_flip_invariance=True,
        infer_is_positive=True,    # 推断序列是否为正值(如销量)
        fix_quantile_crossing=True # 修正分位数交叉问题
    )
)

# 4. 执行预测(支持批量输入)
point_forecast, quantile_forecast = model.forecast(
    horizon=12,   # 预测未来 12 步
    inputs=[
        np.linspace(0, 1, 100),              # 输入序列 1
        np.sin(np.linspace(0, 20, 67)),      # 输入序列 2(不同长度)
    ],
)

print("点预测结果形状:", point_forecast.shape)      # (2, 12)
print("分位数预测形状:", quantile_forecast.shape)   # (2, 12, 10) → P10~P90
带协变量的高级用法
import pandas as pd
import timesfm
from timesfm.xreg_lib import TimesFMWithXReg

# 1. 准备时序数据和协变量(如日期特征)
df = pd.read_csv('sales_data.csv')  # 包含 date, sales, promo, holiday 列
ts = df['sales'].values
covariates = df[['promo', 'holiday']].values  # 外部特征

# 2. 使用 XReg 版本(带协变量)
model_xreg = TimesFMWithXReg.from_pretrained(
    "google/timesfm-2.5-200m-pytorch"
)

# 3. 执行带协变量的预测
forecasts = model_xreg.forecast_with_covariates(
    inputs=[ts],
    dynamic_numerical_covariates={"promo": [covariates[:, 0]]},
    dynamic_boolean_covariates={"holiday": [covariates[:, 1]]},
    horizon=30
)

print("带协变量的预测结果:", forecasts[0].shape)  # (1, 30)
XReg(协变量支持)是 TimesFM 2.5 于 2025 年 10 月新增的重量级功能,适合需要将促销活动、节假日等外部因素纳入预测的场景。
💡 适用场景
场景一:零售 & 电商销量预测
功能说明:基于历史销售数据,结合节假日、促销活动等协变量,预测未来 7/30/90 天的商品销量。TimesFM 的零样本能力意味着新品上市时即使没有历史数据也可直接预测。
输入要求:
- 历史销量时间序列(建议至少 100 个时间步)
- 可选:促销标记、节假日标记等布尔/数值协变量
输出效果:
- 点预测(均值)
- P10~P90 十档分位数区间,直观展示预测不确定性
适用场景:
- ✅ 新品上市销量预估(无历史数据也可用)
- ✅ 大促备货量规划(结合促销活动协变量)
- ✅ 多 SKU 批量预测(批量输入效率高)
场景二:金融 & 风险管理
功能说明:金融时序数据具有强噪声、非平稳等特点,传统模型泛化性差。TimesFM 的分位数预测头可以输出置信区间,量化预测风险,辅助风控决策。
输入要求:
- 股价/汇率/利率历史数据(日频/小时频)
- 可选:宏观经济指标等外部协变量
输出效果:
- 多步超前预测 + 区间估计
- 10 个分位数档位(P10/P20/.../P90)定量刻画不确定性
适用场景:
- ✅ 量化交易信号生成(结合分位数区间设置止损)
- ✅ 外汇/商品价格风险暴露估算
- ✅ 违约概率预测的时序特征提取
场景三:能源 & 工业物联网
功能说明:电力负荷、太阳能发电量、工厂设备运行数据等具有明显的周期性规律,非常适合 TimesFM 的 Patch Transformer 捕捉。配合 BigQuery ML 集成,可直接在云端无代码调用。
输入要求:
- 电力/能源/设备传感器历史数据(分钟/小时频)
- 上下文长度最长 16K,支持超长历史记录
输出效果:
- 高精度的短中长期预测
- 支持多序列批量并行预测,适合大规模传感器网络
适用场景:
- ✅ 电网负荷预测与调度优化
- ✅ 设备预测性维护(异常模式提前检测)
- ✅ 光伏/风能发电量日前预测
用户群体总结
- ✅ 数据科学家:快速建立预测基线,替代繁琐的特征工程
- ✅ 算法工程师:零样本直接用,迁移到新业务场景无需重训
- ✅ 业务分析师:结合 BigQuery 集成,无需部署即可云端预测
- ✅ AI 研究者:研究时序基础模型、迁移学习、不确定性估计的理想基准
- ❌ 不适合:需要极低延迟实时预测(推理有一定延迟)、或纯粹追求轻量边缘部署的场景
📊 与竞品对比
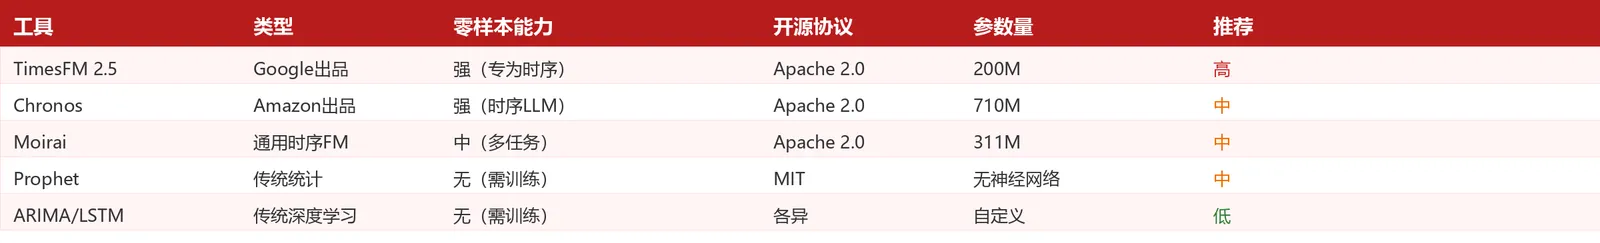
对比说明:
- TimesFM vs Chronos:TimesFM 2.5 参数更轻量(200M vs 710M),上下文更长(16K vs 512),且已原生支持协变量;Chronos 基于 T5 架构,在某些短序列基准上更有优势
- TimesFM vs Moirai:Moirai 支持多变量预测,适合多传感器联合建模;TimesFM 主打单变量零样本,简单易用
- TimesFM vs Prophet:Prophet 是经典统计工具,可解释性强但需要人工调参,无法处理复杂模式;TimesFM 零样本直接用,精度更高
- TimesFM vs 传统深度学习:LSTM/Informer 需要大量领域数据训练,TimesFM 直接跳过这一步
💰 定价方案
| 部署方式 | 费用 | 说明 |
|---|---|---|
| 本地部署(开源) | 免费 | Clone 仓库,pip install 即可用 |
| HuggingFace 在线 API | 免费(有限额) | 调用 HuggingFace Inference API |
| Google BigQuery ML | 按量付费 | 官方企业级产品,开箱即用 |
| Google Cloud Vertex AI | 按量付费 | 生产级 MLOps 平台 |
开源完全免费!Apache 2.0 协议,可商用。本地部署只需 GPU 内存 4GB+ 即可运行 200M 版本。
开源协议:Apache License 2.0
🎯 总结
TimesFM 代表了时间序列分析进入"基础模型时代"的里程碑。如果你过去在时序预测上耗费大量精力于数据收集、特征工程和模型调参,TimesFM 给你一个全新的选择:直接用预训练好的大模型,零样本启动,轻量部署。
TimesFM 2.5 在参数效率、上下文长度、分位数预测三个维度都完成了重大升级,同时进入 BigQuery 成为 Google 官方产品,可信度有保障。无论是工业 AI 落地还是数据科学研究,都是 2026 年值得重点关注的开源工具之一。
推荐指数: ⭐⭐⭐⭐⭐(满分 5 星)
适合人群: 数据科学家、AI 工程师、业务分析师、时序预测研究者
立即体验:
- 📦 GitHub 仓库:https://github.com/google-research/timesfm
- 🤗 HuggingFace 模型:https://huggingface.co/google/timesfm-2.5-200m-pytorch
- 📄 ICML 2024 论文:https://arxiv.org/abs/2310.10688
- ☁️ Google BigQuery 集成:https://cloud.google.com/bigquery/docs/timesfm-model
本文由 AI 辅助生成,数据截至 2026 年 4 月 8 日,最新信息请以 GitHub 仓库和官网为准。