一、为什么需要「研发自动化」
配套媒体
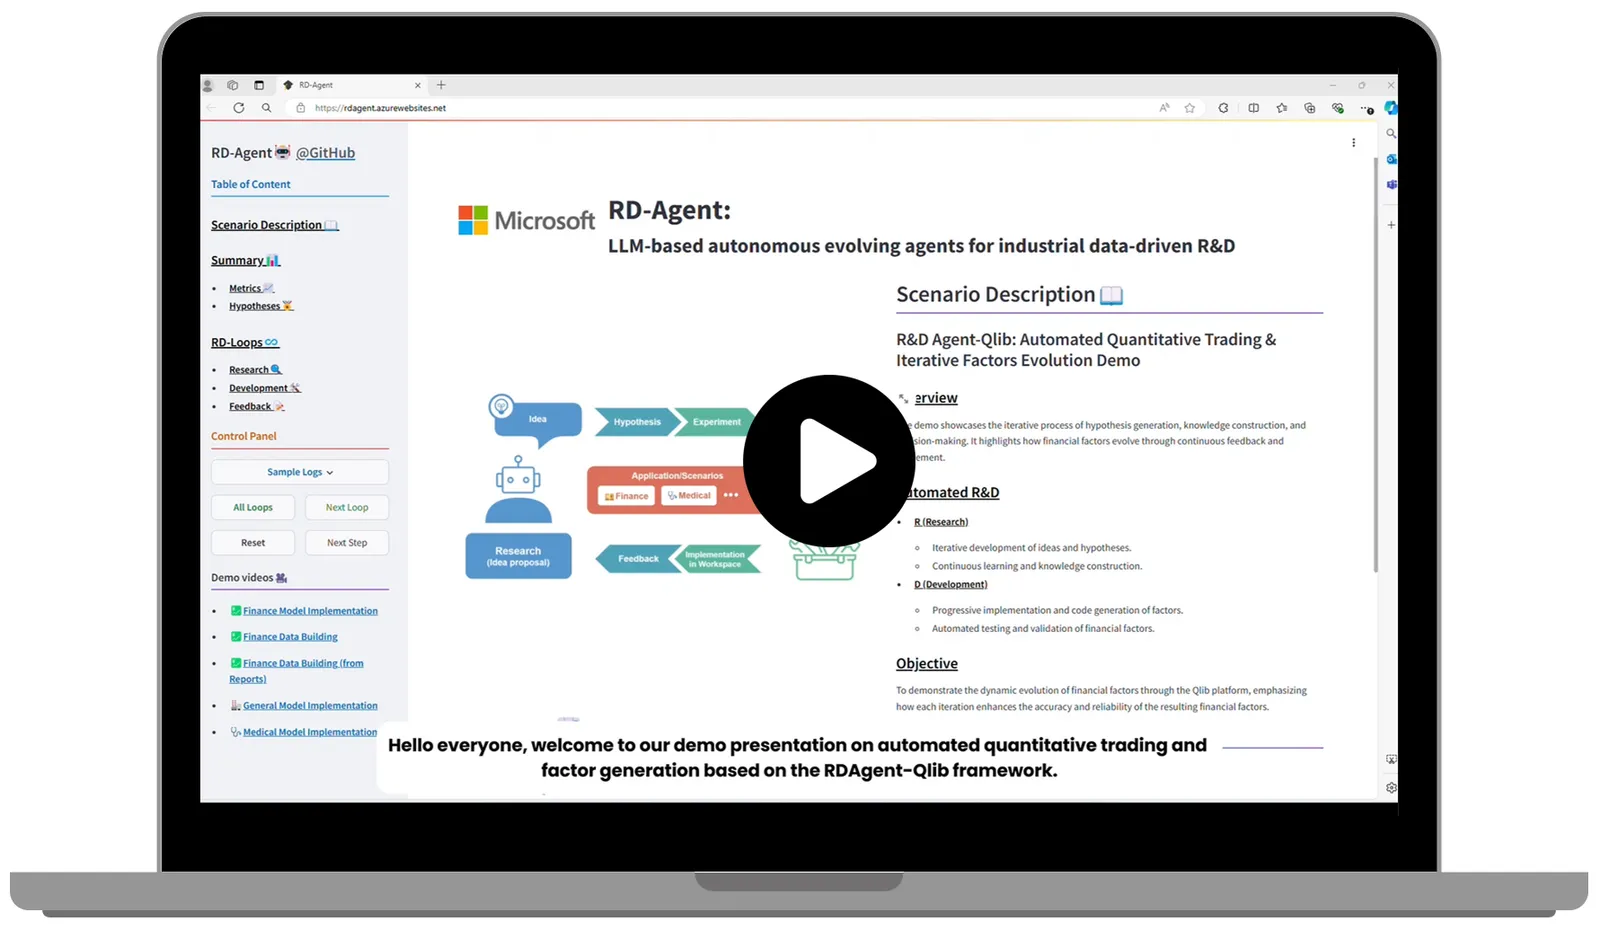
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../RD-Agent-recommend.pptx../../RD-Agent-recommend.mp4本文仅作技术交流,不构成投资建议。股市有风险,投资需谨慎。
📌 核心价值:用多智能体把「提出假设 → 写代码 → 回测 → 迭代」的量化研发链路自动化
微软开源的 RD-Agent,把研究员最重的「想因子、写实现、跑验证」循环,交给 LLM 驱动的 Agent 闭环去完成。
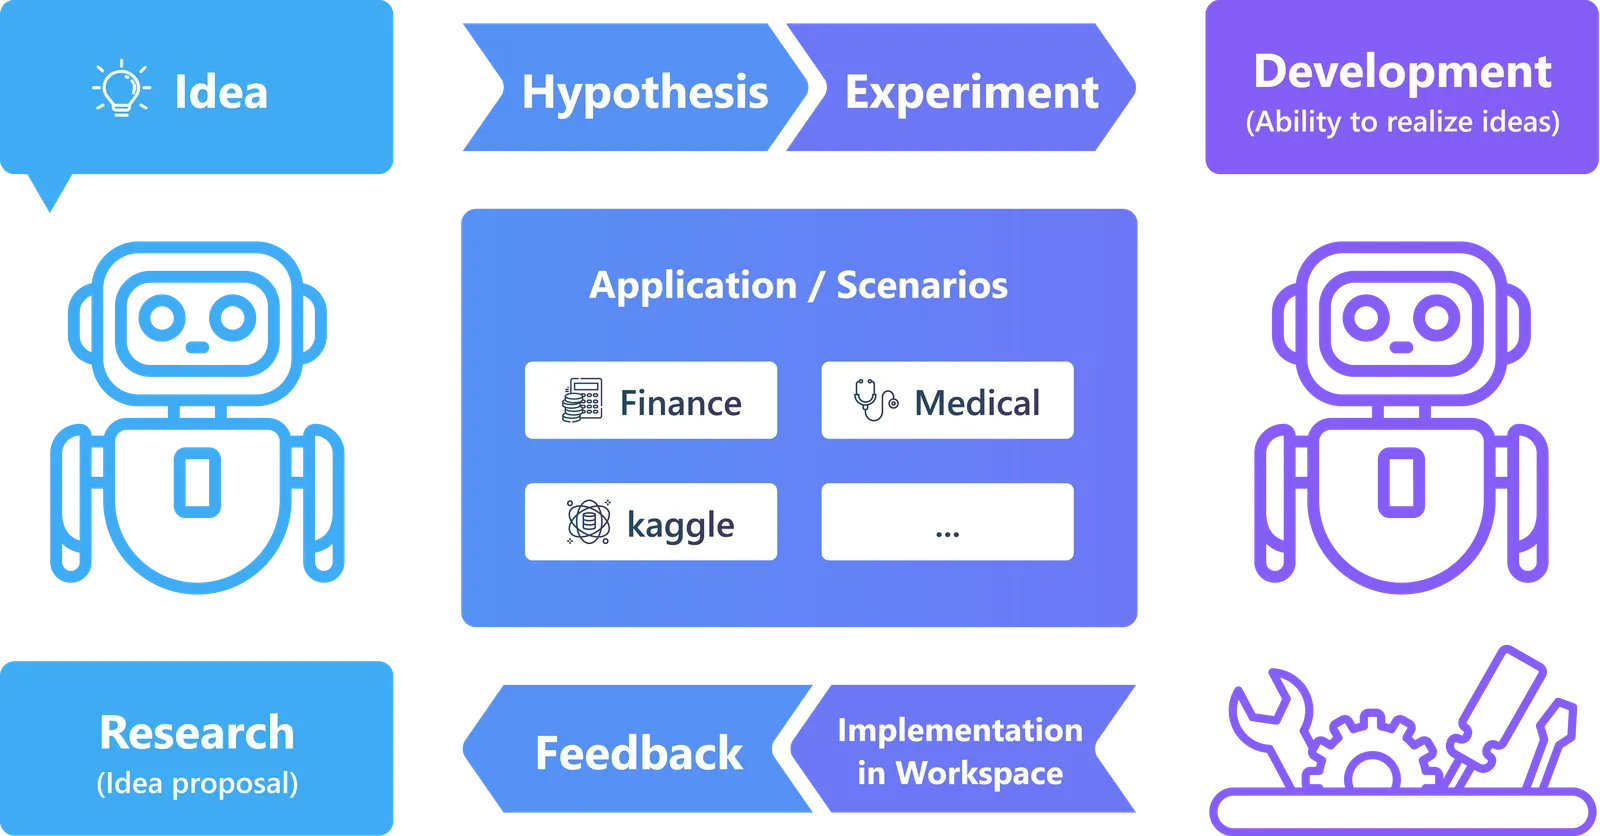
做量化研究,最重的永远是两件事:想因子、写实现。前者靠经验与灵感,后者靠工程与调参,二者循环往复。微软开源的 RD-Agent 想解决的,正是把这条研发链路用多智能体系统尽可能自动化。它不是一个「给买卖点」的工具,而是一套 R&D 自动化引擎:R 负责提出并演化研究想法,D 负责把想法落成可运行代码,二者在反馈中持续进化。
在量化金融场景里,它被命名为 RD-Agent(Q),定位为「数据驱动的量化多智能体框架」,也是业界首个以数据为中心、自动化因子与模型联合优化的多智能体研发框架。
核心定位:让 AI 接管量化研发中最有价值的环节——数据构建与模型迭代,而不是替代人的投资决策。
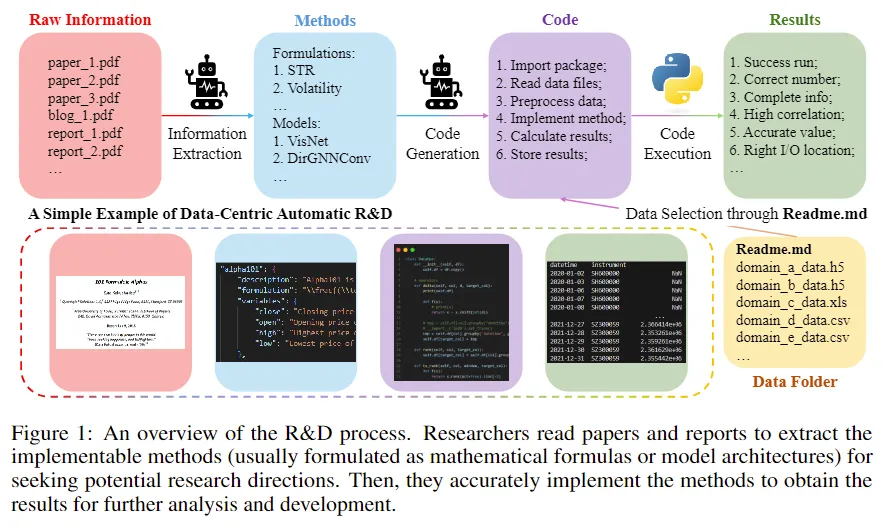
传统量化策略研发高度人工:研究员读论文、看财报,手动构造因子,再写回测脚本验证,效果不好就推倒重来。整个过程知识密集、重复劳动多、可复现性差。
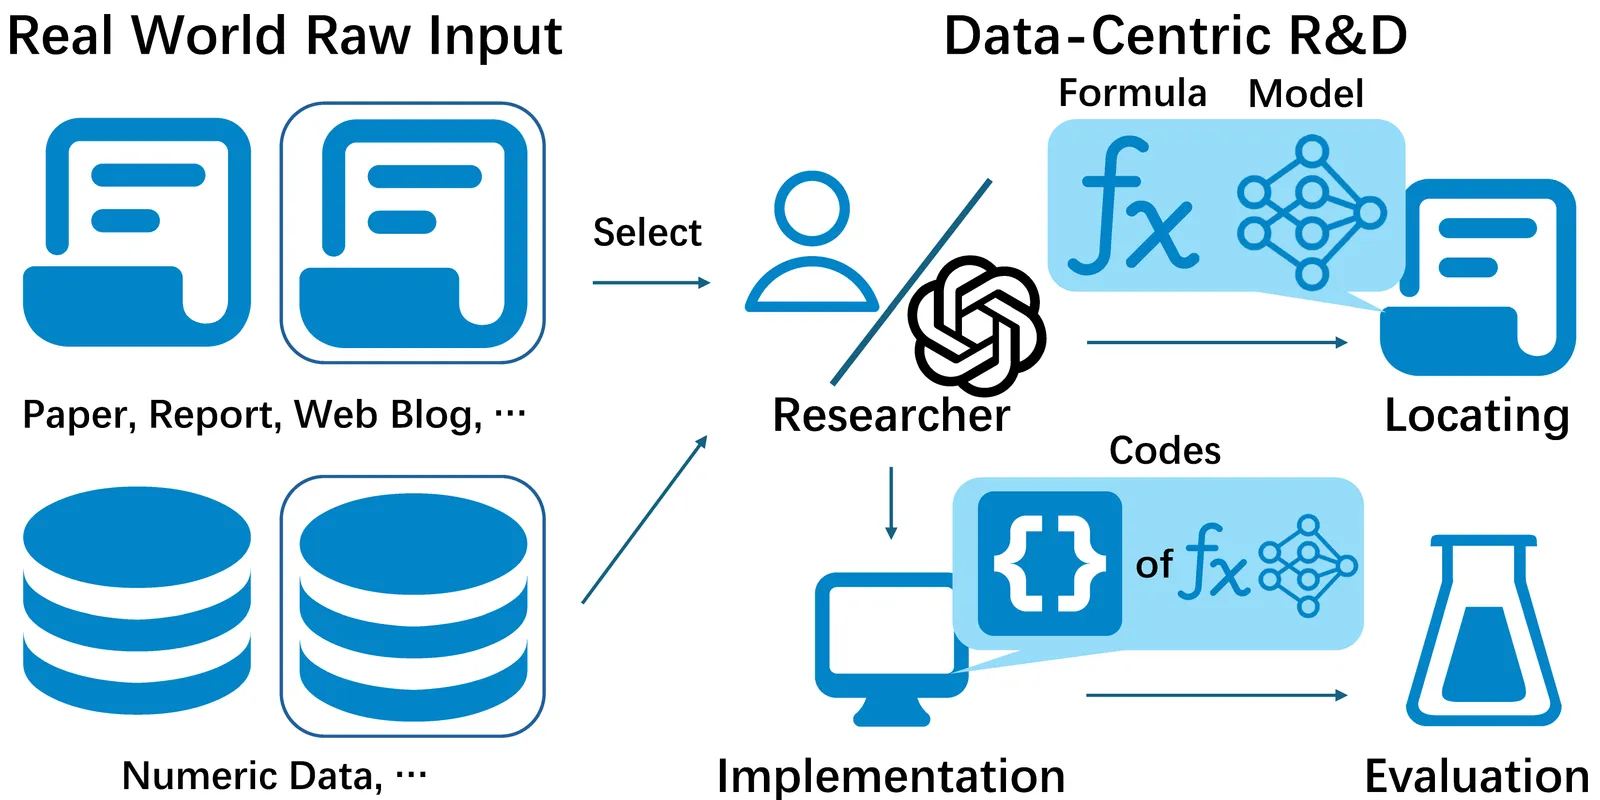
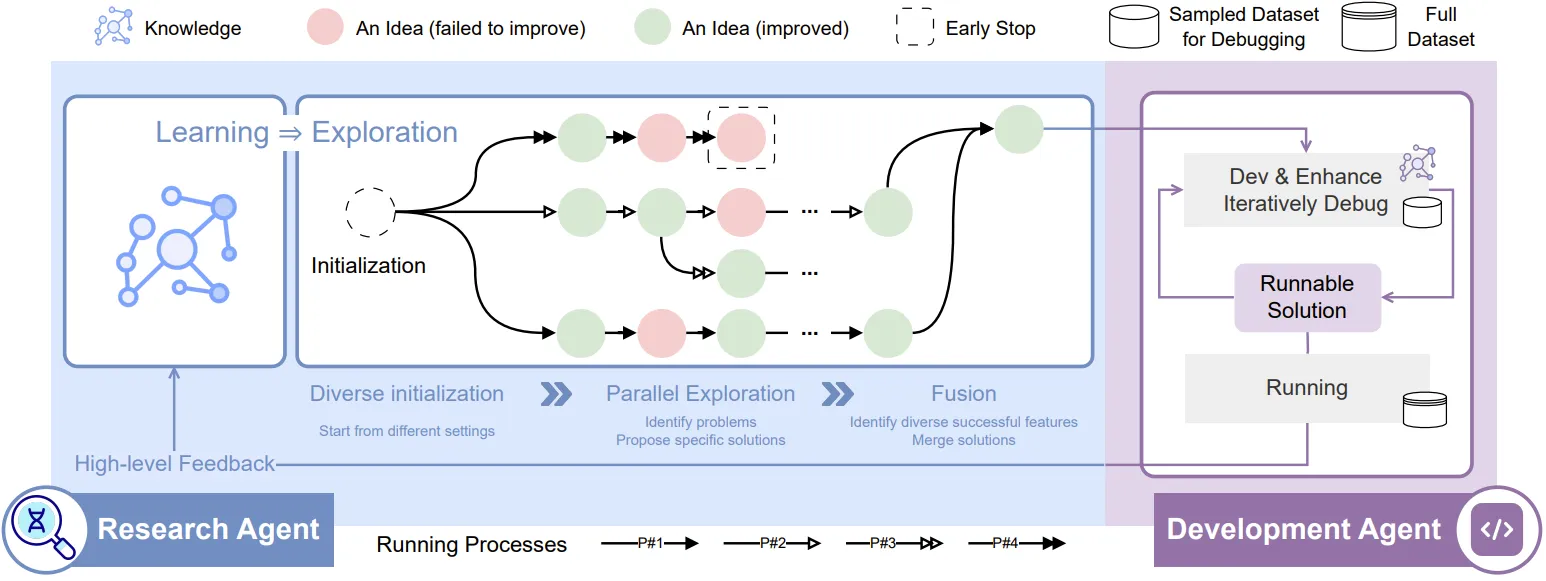
RD-Agent 的核心假设是:研发中最有价值的环节(因子构建与模型迭代)可以被 AI Agent 接管。它把「研究者」拆成两个角色——
- Research Agent(R):基于历史结果和外部材料,提出新的研究假设(新因子、新模型结构);
- Development Agent(D):把假设实现成代码、跑实验、产出结构化反馈。
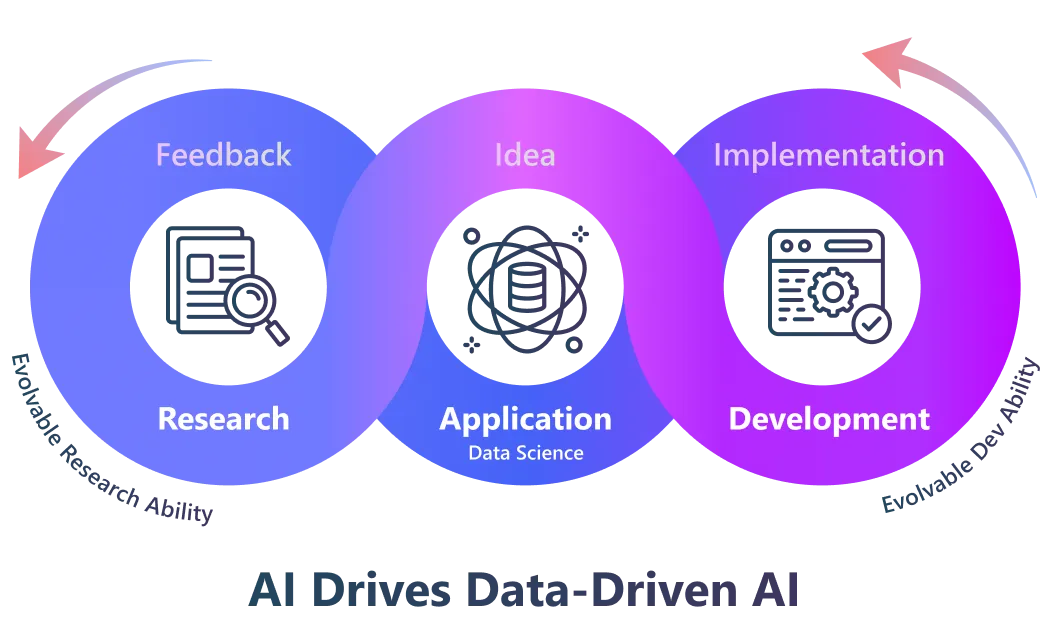
两者构成闭环,每一轮都基于上一轮的实证结果做调整,而不是凭空拍脑袋。在量化场景下,RD-Agent(Q) 进一步把因子与模型拆成两条可独立、也可协同演化的回路。
二、RD-Agent(Q):因子与模型的协同优化
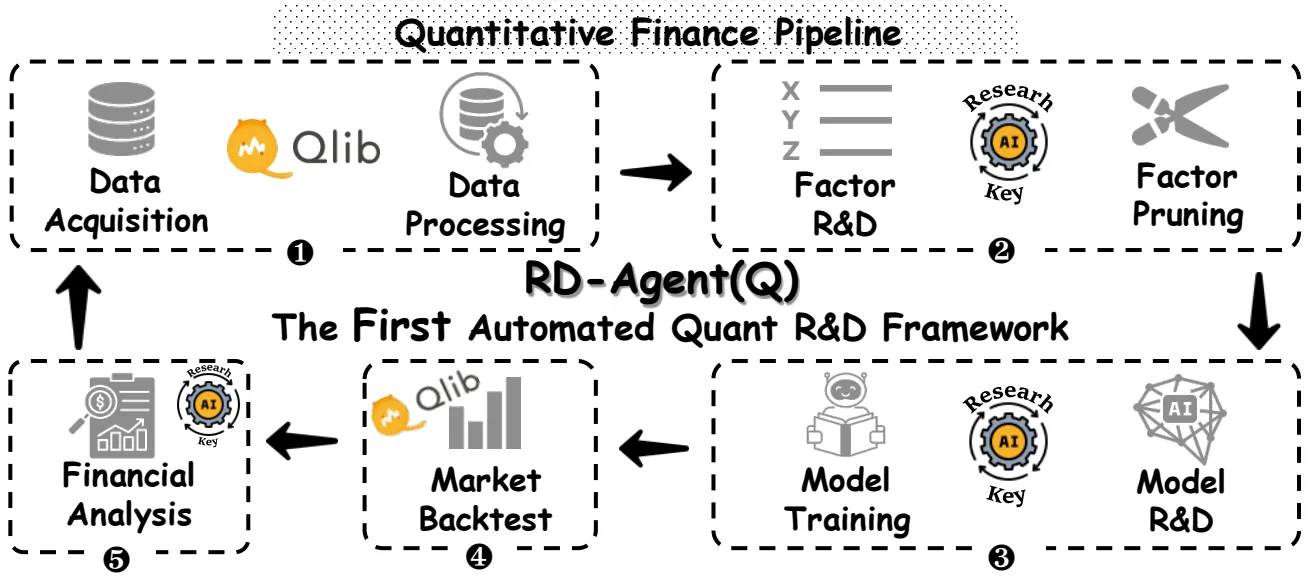
RD-Agent(Q) 的关键机制是 因子–模型交替优化(alternating factor–model optimization)。它提供三种粒度,让你按需选择:
rdagent fin_quant     # 因子与模型联合演化(量化研发全栈自动化)
rdagent fin_factor    # 仅迭代因子演化
rdagent fin_model     # 仅迭代模型演化
也就是说,你可以让它只挖因子、只调模型,或者让二者互相驱动、共同进化。框架还支持 人在回路(human-in-the-loop):可以喂入真实财报研报,让 Agent 自动读取并提取成可实现的因子。
# 从财报研报批量提取并实现因子
wget https://github.com/SunsetWolf/rdagent_resource/releases/download/reports/all_reports.zip
unzip all_reports.zip -d git_ignore_folder/reports
rdagent fin_factor_report --report-folder=git_ignore_folder/reports
论文(NeurIPS 2025,arXiv 2505.15155)在真实市场做了实证:相比经典因子库 Alpha158,RD-Agent(Q) 在更少因子的前提下,年化回报约为其 2 倍,因子用量减少 70% 以上,且单次完整研发成本可控制在 10 美元以内。这里强调的是「研发效率」与「可解释性」,而非任何形式的确定性预测。
三、技术架构:R 与 D 如何协作
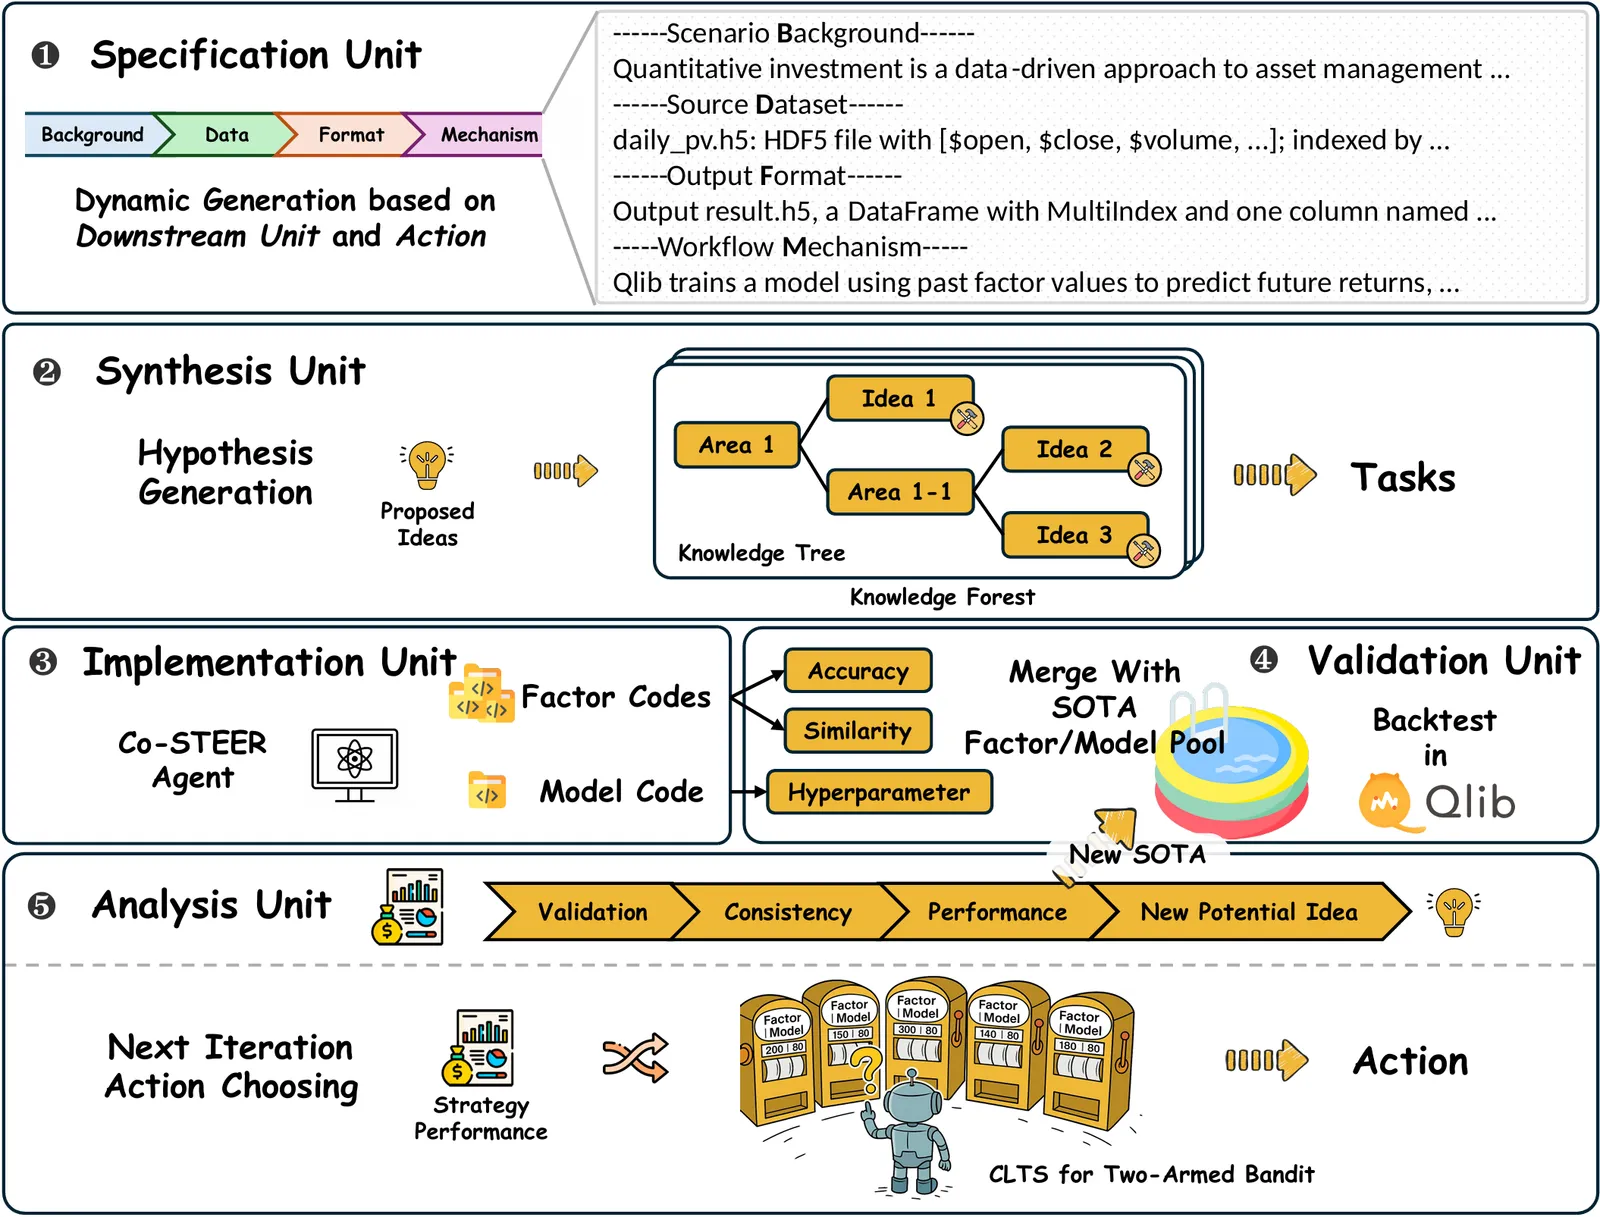
在量化场景下,RD-Agent(Q) 把研发拆成五个紧密耦合的功能单元,在统一接口下持续迭代:
- Specification(规范单元):统一数据接口、输出格式与回测环境(基于 Qlib),降低歧义;
- Synthesis(综合单元):维护「想法森林」,基于历史实验持续生成新假设;
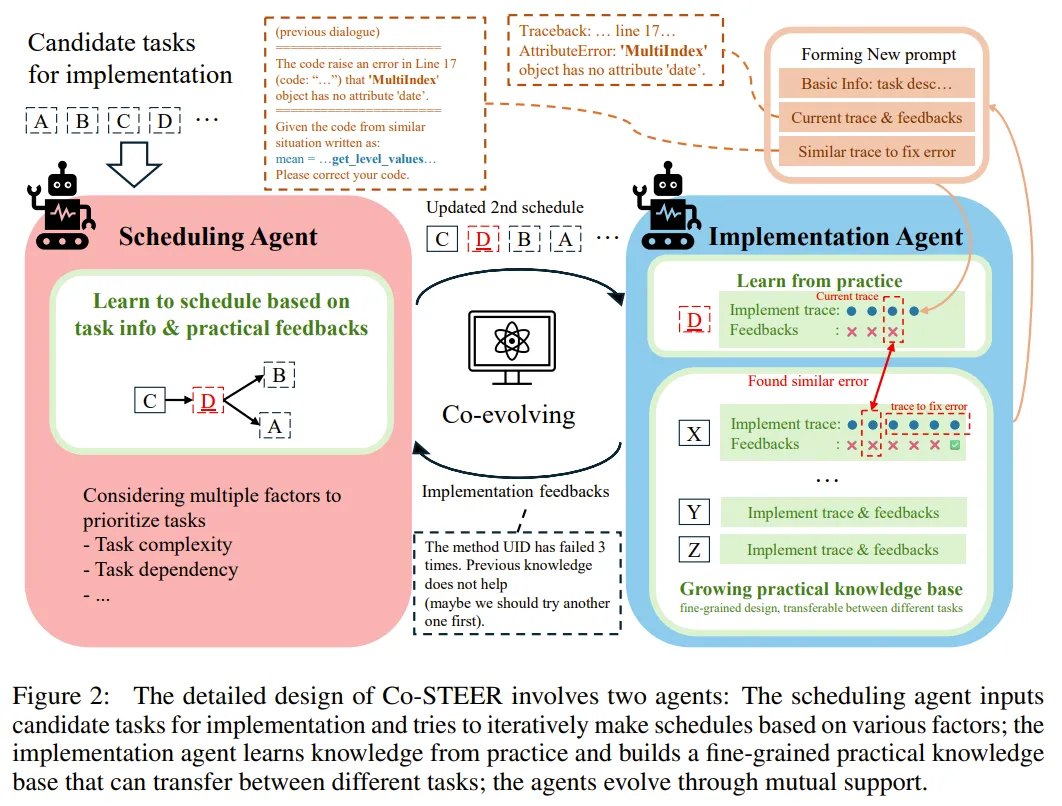
- Implementation(实现单元):由代码生成代理 Co-STEER 把假设翻译成可执行 Python;
- Validation(验证单元):在 Qlib 中做真实市场回测,过滤高信号、低冗余的因子;
- Analysis(分析单元):用多臂老虎机(Thompson 采样)自适应决定下一步优先优化因子还是模型。
几个工程要点值得关注:
- 统一 LLM 后端:基于 LiteLLM,可接入 GPT、Claude、Gemini、DeepSeek、Qwen 等多家模型,不绑定单一供应商;
- 场景化封装:把通用 R&D 循环沉淀为量化金融、Kaggle 数据科学、LLM 微调、强化学习后训练等多个「Scenario」,开箱即用;
- 可观测:提供
rdagent ui监控面板与rdagent server_uiWeb 界面,实时查看每一轮 Agent 的思考轨迹与实验日志; - 可复现:每一轮假设、代码、指标都被记录,便于回溯与审计。
四、快速上手
安装与配置
# 建议使用独立 conda 环境
conda create -n rdagent python=3.10
conda activate rdagent

# 安装
pip install rdagent
RD-Agent 需要配置一个 LLM 后端(它自己不产生推理能力)。在 .env 中通过 LiteLLM 指定即可:
# .env 示例(仅配置其一)
OPENAI_API_KEY=sk-xxx
# 或使用兼容端点
LITELLM_BASE_URL=https://your-proxy/v1
LITELLM_API_KEY=sk-xxx
LITELLM_MODEL=gpt-4o
注意:RD-Agent 是研发辅助框架,需自备 LLM API Key 并自行承担调用成本;它不直接执行实盘交易,也不提供任何买卖建议。
跑通一个量化场景
# 启动量化全栈研发(因子+模型联合演化)
rdagent fin_quant
底层回测由 Qlib 驱动,关键配置(CSI300 为例)长这样:
# qlib 回测配置节选
provider_uri: ~/.qlib/qlib_data/cn_data   # A股数据
market: csi300
benchmark: SH000300
strategy:
  class: TopkDropoutStrategy
  kwargs:
    topk: 50
    n_drop: 5
metric:   # 评估指标
  - IC
  - ICIR
  - ARR        # 年化回报
  - MDD        # 最大回撤
回测区间通常按时间切分以防数据泄漏:训练 2008–2014、验证 2015–2016、测试 2017–2020-08。数据区域默认支持 cn(沪深300、中证500),论文中还做了跨市场的纳斯达克100对照实验。
五、与主流量化框架的差别
很多同学会把 RD-Agent 和 Qlib、FinRL、TradingAgents 混为一谈。一句话区分:Qlib 是「零件箱」(数据+回测),RD-Agent 是「自动化产线」(基于 Qlib 自动造零件并验证)。
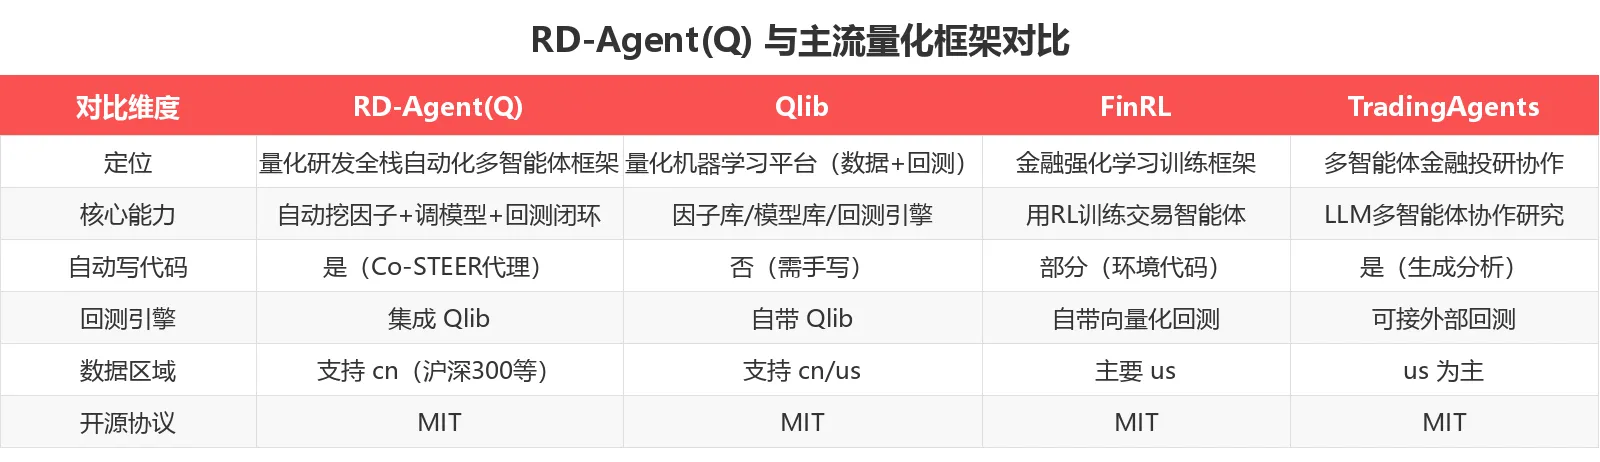
- Qlib:微软自家的量化机器学习平台,提供数据管理、因子库、模型库与回测引擎,但因子与模型仍需人工编写;
- FinRL:金融强化学习框架,用 RL 训练交易智能体,偏「端到端信号」;
- TradingAgents:多智能体金融投研协作,侧重研究与观点生成;
- RD-Agent(Q):在它们之上做「全栈自动化」——自动写因子代码、自动调模型、自动回测、自动迭代,并把知识沉淀为可复用的「想法森林」。
六、适用人群与边界
适合:
- ✅ 量化研究员:把繁琐的因子实现与调参交给 Agent,自己专注假设与风控;
- ✅ 个人开发者:用 MIT 协议免费自托管,接自己的 LLM 与 A股数据做实验;
- ✅ 教学/科研:可复现、可观测,适合讲清楚「量化研发闭环」到底长什么样。
边界(务必看清):
- ❌ 它不提供任何买卖建议,不预测短期价格方向,也不声称必然盈利;
- ❌ Agent 行为有随机性(LLM 采样),生产环境需做种子控制与人工复核;
- ❌ 回测表现不等于未来表现,任何策略都需经过严谨的停复牌、滑点与成本校验。
七、总结
RD-Agent 的价值不在「帮你赚钱」,而在 把量化研发里最重复、最费人的环节自动化:提假设、写代码、跑回测、看指标、再迭代。它用一套可观测、可复现的多智能体闭环,把研究员从重复劳动里解放出来,让人回到「定义问题」与「把控风险」的位置。
推荐指数: ⭐⭐⭐⭐☆(开源、可自托管、思路清晰;但依赖 LLM 成本与人工把关)
适合人群: 量化研究员、个人开发者、高校教学与科研场景。
GitHub 仓库: microsoft/RD-Agent 技术报告: RD-Agent Tech Report 量化论文: arXiv 2505.15155(NeurIPS 2025)
💡 开源协议:MIT——可免费商用与二次开发,无授权费用。
数据截至 2026-08-24,最新信息请以官网与仓库为准。
本文仅作技术交流,不构成投资建议。股市有风险,投资需谨慎。