PixelRAG
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../PixelRAG-recommend.pptx../../PixelRAG-recommend.mp4本文目录
📌 核心价值:把网页截屏当索引,让 AI 直接"看图说话",表格/图表/排版零丢失
UC Berkeley 开源视觉 RAG 系统,将网页渲染为截图瓦片,用视觉语言模型直接检索图片中的答案。支持 828 万篇 Wikipedia 即时检索,开源 Apache-2.0。
🚀 什么是 PixelRAG?
传统 RAG 管道有这样一条隐形的"信息死亡链":抓取网页 → HTML 解析 → 剥离标签 → 文本分块 → 向量化 → 检索。问题出在第 2 步——HTML-to-text 解析器会丢掉 40% 以上的页面内容。表格变成扁平文本流,图表直接消失,多栏布局被压成线性文字。
PixelRAG 来自 UC Berkeley 的 SkyLab、BAIR 和 Berkeley NLP 实验室(指导教授包括 Apache Spark 创始人 Matei Zaharia),它完全跳过了"解析"这一步:
- 用
pixelshot将网页渲染为截屏瓦片 - 用视觉语言模型嵌入图像
- 在图像向量空间中检索
- 将相关截屏瓦片喂给 VLM 直接"看图答题"
核心创新:不再把网页转成文本再索引,而是把网页截屏当索引,保留所有视觉结构


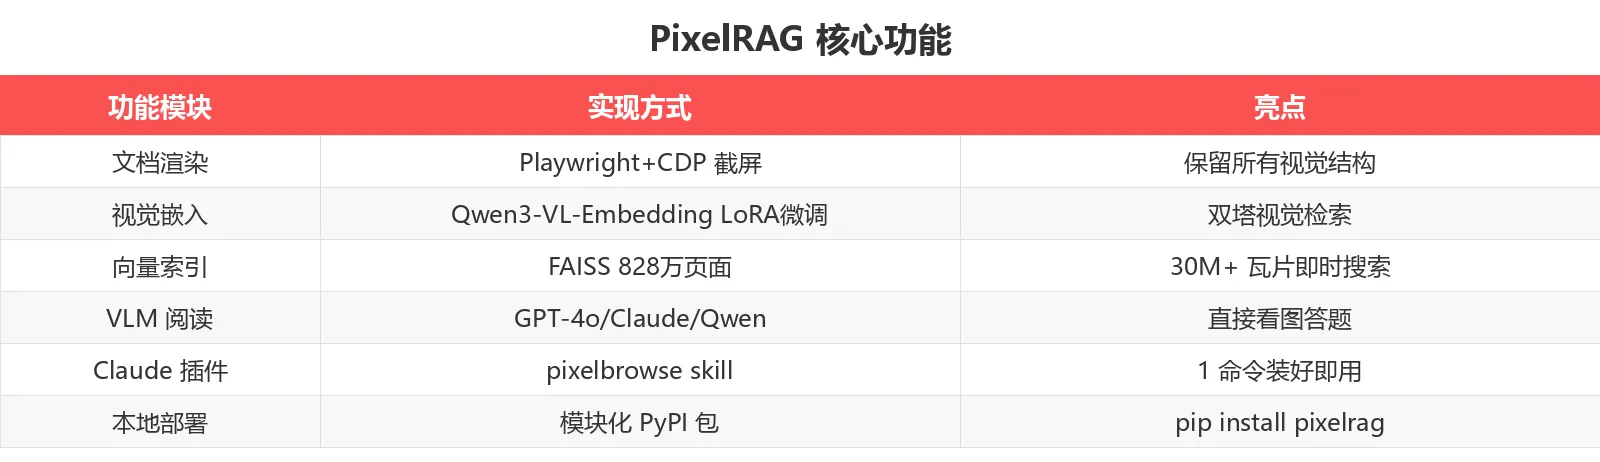
✨ 核心功能一览
🛠️ 5 分钟上手:零配置体验
方案 A:直接调用云端 API(无需安装)
Berkeley 团队托管了 828 万篇 Wikipedia 的预构建像素索引,连 API Key 都不需要:
curl -X POST https://api.pixelrag.ai/search \
  -H "Content-Type: application/json" \
  -d '{"queries": [{"text": "What is the capital of France?"}], "n_docs": 5}'
返回的是 base64 编码的图像瓦片 + 元数据,直接传给 VLM 即可阅读。
在浏览器中体验:pixelrag.ai
方案 B:本地安装
pip install pixelrag

# 渲染一个网页为截屏瓦片
pixelshot https://en.wikipedia.org/wiki/Python --output ./tiles

# 安装子模块
pip install 'pixelrag[embed]'   # 嵌入 & 构建索引
pip install 'pixelrag[index]'   # 完整管道编排
pip install 'pixelrag[serve]'   # FastAPI 搜索服务
方案 C:给 Claude 装上"眼睛"(pixelbrowse 插件)
这是整个项目里最立竿见影的功能:
pip install pixelrag
claude plugin marketplace add StarTrail-org/PixelRAG
claude plugin install pixelbrowse@pixelrag-plugins
然后在 Claude Code 中:
/screenshot https://news.ycombinator.com
或者命令行:
claude -p "screenshot https://arxiv.org/abs/2404.12387 and explain the key findings"
Claude 会截图页面 → 读取图像 → 看到表格、图表和布局,而不是被剥离的 HTML。
注意:pixelbrowse 不需要构建索引,对单次查看网页的 Agent 任务延迟几乎为零
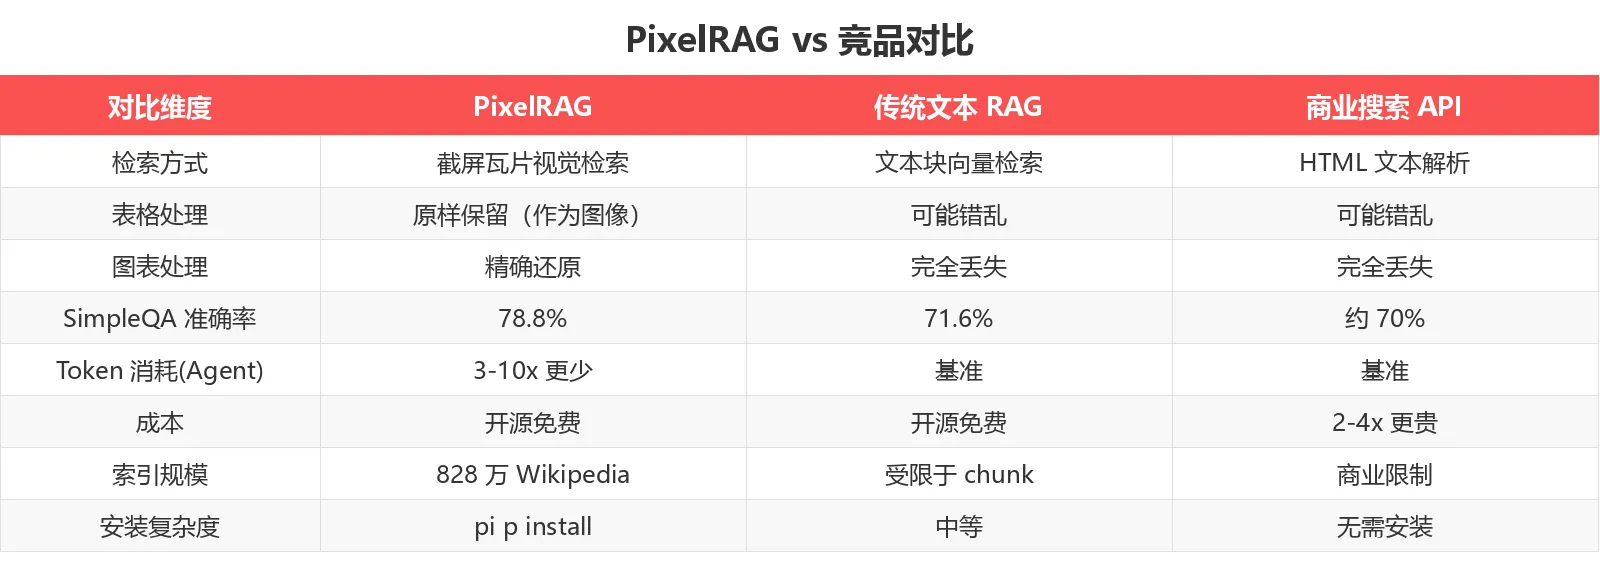
📊 与竞品对比
💡 技术架构深度解析
pipeline:文本 RAG vs 像素 RAG
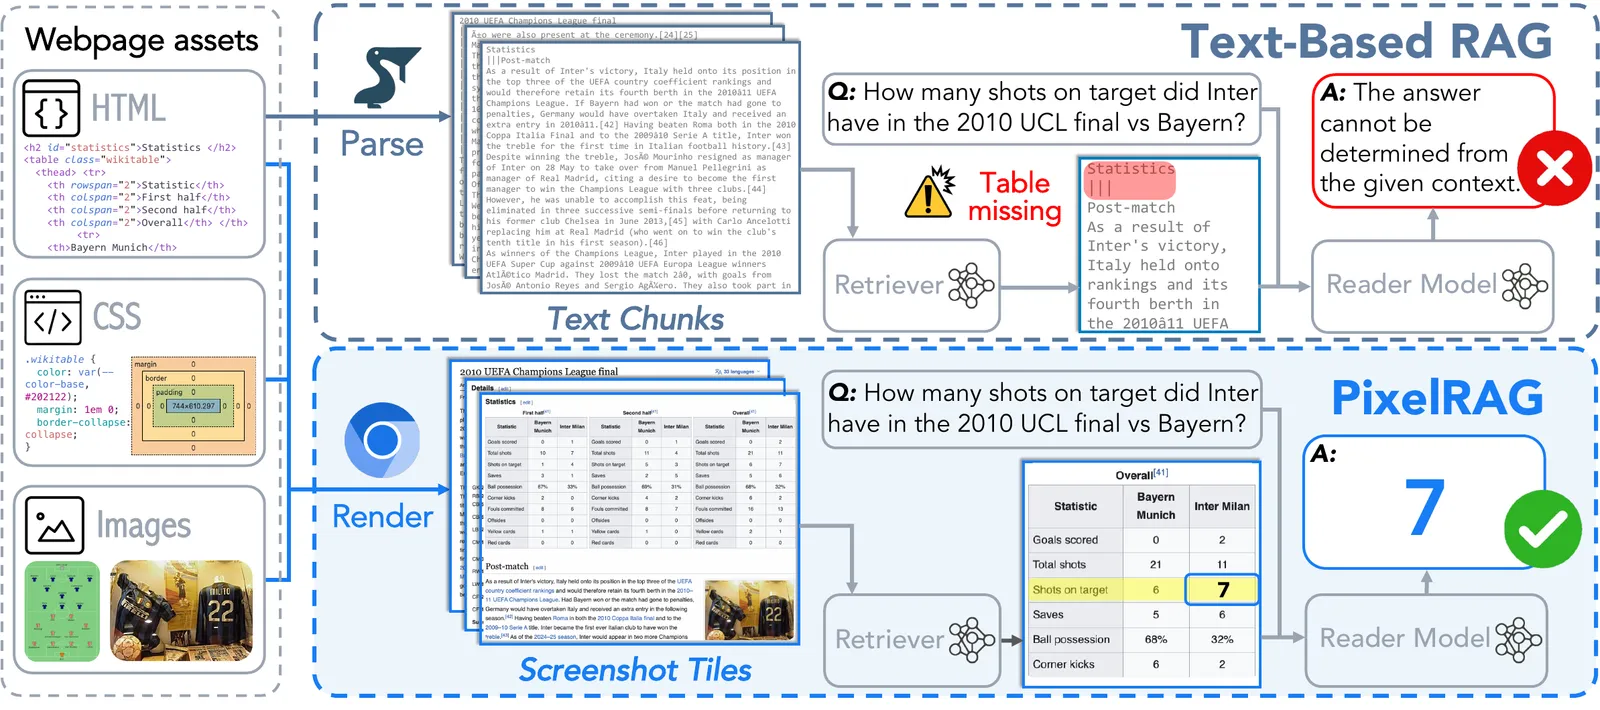
核心差异:
| 维度 | 传统文本 RAG | PixelRAG |
|---|---|---|
| 输入 | HTML → 文本块 | 网页截屏瓦片 |
| 嵌入模型 | 文本 embedding(如 text-embedding-3) | Qwen3-VL-Embedding-2B(LoRA 微调) |
| 检索对象 | 文本块 | 图像瓦片 |
| 阅读模型 | LLM | VLM(GPT-4o/Claude/Qwen) |
| 表格处理 | 容易错乱 | 原样保留 |
| 图表处理 | 完全丢失 | 精确还原 |
技术栈一览
| 组件 | 技术选型 |
|---|---|
| 渲染引擎 | Playwright + Chrome DevTools Protocol (CDP) |
| 嵌入模型 | Qwen3-VL-Embedding-2B(LoRA 微调于截屏数据) |
| 索引引擎 | FAISS(Facebook 向量搜索库) |
| 服务框架 | FastAPI + uvicorn |
| 部署 | PyPI 包分发,支持 GPU 加速 |
训练数据公开可获取
- LoRA 适配器:
Chrisyichuan/wiki-screenshot-embedding-lora - 训练数据集:
Chrisyichuan/screenshot-training-natural-filtered-v2 - Wikipedia 像素索引:
StarTrail-org/pixelrag-faiss-indexes(~217 GB)
💡 适用场景
场景 1:AI Agent 浏览网页
传统 Agent 抓取网页 text 时,表格变成无序文本流,图表消失。PixelRAG 的 pixelbrowse 让 Claude 直接"看"页面。
输入:任意 URL 输出:截屏瓦片 → VLM 理解 → 精确回答 适用:Dashboard 数据解读、论文理解、竞品分析
场景 2:企业内部文档 RAG
财报 PDF、规格书、扫描件——这些 text-based RAG 最容易翻车的地方,正是 PixelRAG 最有优势的地方。
场景 3:Wikipedia 知识问答
828 万篇 Wikipedia 的预构建索引,零配置即用,SimpleQA 准确率 78.8% vs 文本 RAG 71.6%。
场景 4:视觉相似搜索
支持以图搜图,API 可以接受图像作为 query,找到视觉相似的页面。
用户群体总结
- ✅ AI Agent 开发者:想要 Agent 能真正"看懂"网页的人
- ✅ RAG 系统工程师:遇到表格/图表/多栏布局处理瓶颈的团队
- ✅ Claude Code 用户:装一个 pixelbrowse 插件即用
- ✅ 知识库建设者:需要索引 PDF/扫描件/幻灯片等视觉文档
- ❌ 不适合:纯文本场景(博客、新闻、代码文档),文本 RAG 已足够
📦 部署方案
| 方案 | 适用场景 | 成本 |
|---|---|---|
| 云端 API(pixelrag.ai) | 快速验证、Wikipedia 问答 | 免费 |
| 本地构建索引 | 私有文档库 | GPU + 存储 |
| Hugging Face 下载预构建索引 | 大规模部署 | ~217 GB 存储 |
构建自定义索引:
# pixelrag.yaml
source:
  type: local
  path: ./my_docs

embed:
  model: Qwen/Qwen3-VL-Embedding-2B
  device: cuda

output: ./my_index
pixelrag index build
pixelrag serve --index-dir ./my_index --port 30001
🎯 总结
PixelRAG 不是简单地在文本 RAG 上多加了几个百分点——它从根本上重新定义了问题。当整个 RAG 社区在过去两年里疯狂优化文本提取、分块策略、嵌入模型时,没人停下来问:"网页本来就是视觉文档,为什么非要把它们转成文本?"
性能数据:
- 📈 SimpleQA 准确率 +18.1%(78.8% vs 71.6%)
- 📉 Agent 运行 token 消耗 减少 3-10x
- 💰 成本比商业搜索 API 低 2-4 倍
- 📊 表格查询准确率 +6.3 个百分点(48.8% vs 42.5%)
推荐指数: ⭐⭐⭐⭐⭐(满分5星)
适合人群: AI Agent 开发者、RAG 工程师、Claude Code 用户、知识库建设者
立即体验: pixelrag.ai
GitHub 仓库: StarTrail-org/PixelRAG
数据截至 2026-06-23,最新信息请以官网为准。