PageIndex
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../PageIndex-recommend.pptx../../PageIndex-recommend.mp4本文目录
🔥 PageIndex:32.6k Stars!用 AlphaGo 的思路重新设计 RAG,彻底告别向量数据库
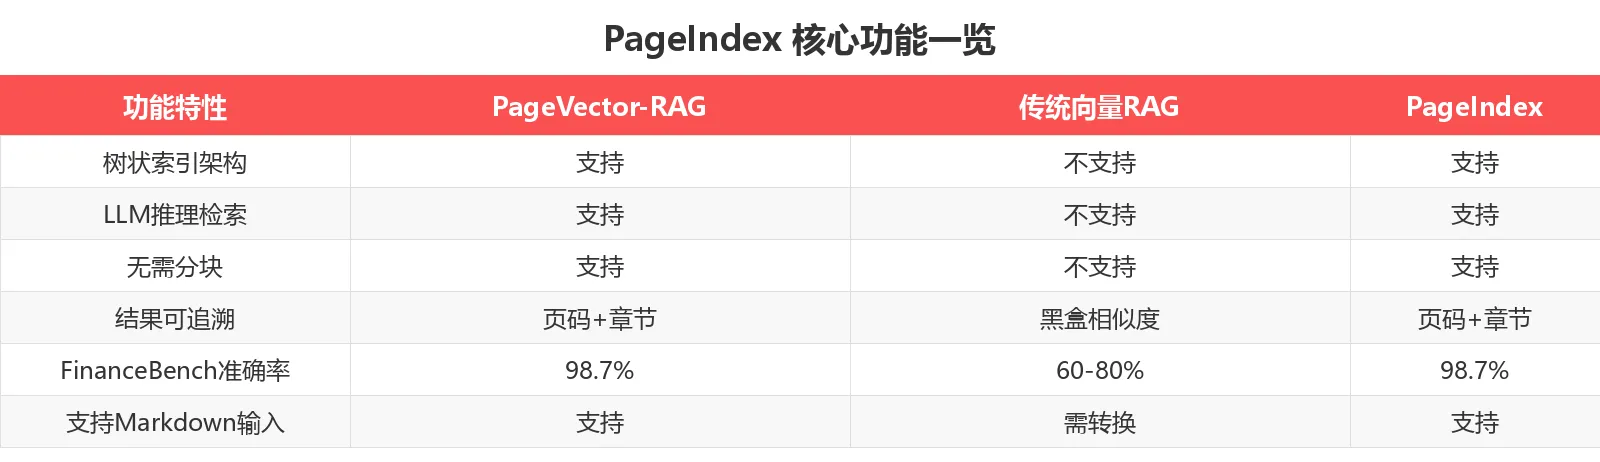
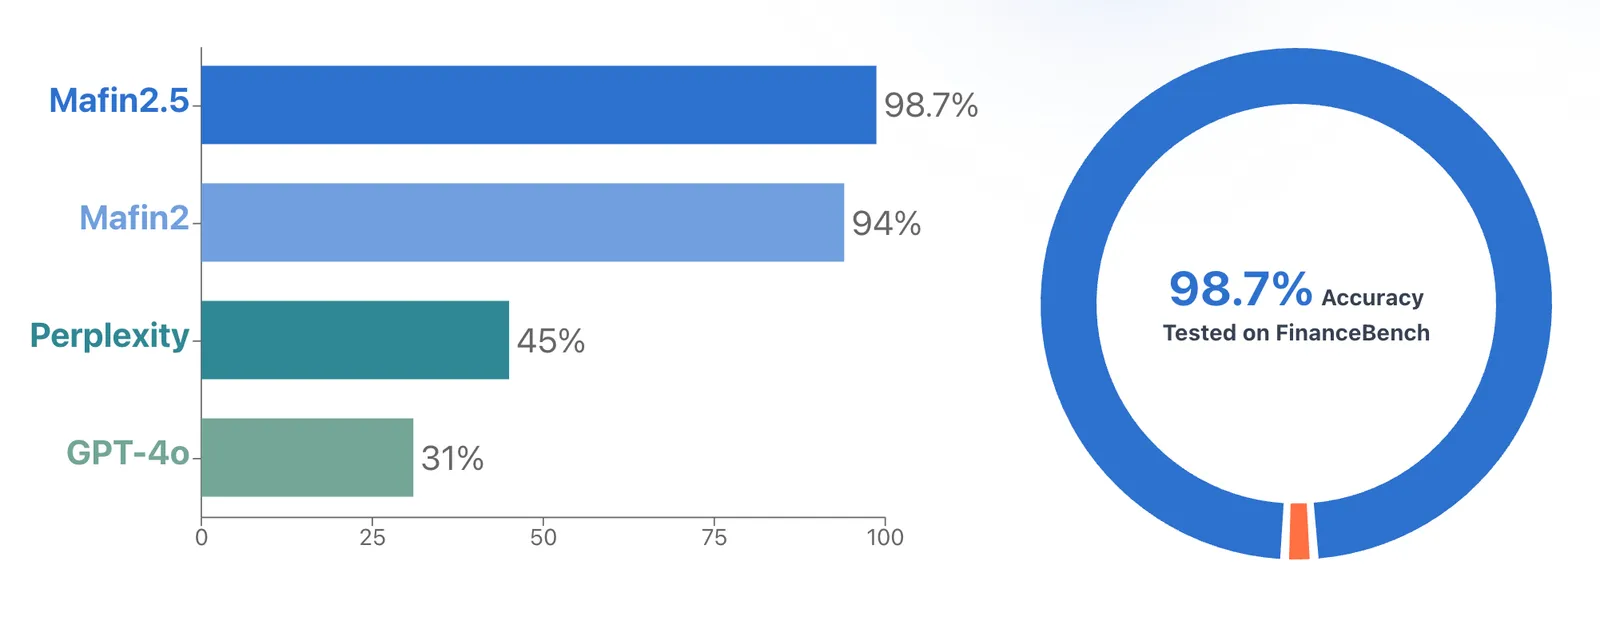
受 AlphaGo 启发,不依赖向量相似度搜索,而是通过构建文档树状索引 + LLM 推理,实现 98.7% 长文档检索准确率——比传统向量 RAG 高出近 20 个百分点。
🚀 什么是 PageIndex?
传统的 RAG(检索增强生成)方案依赖向量数据库,将文档切割成碎片后通过相似度匹配检索。但问题是:相似不等于相关。特别是在处理财务报告、学术教科书、法律手册等超长文档时,向量 RAG 经常出现"找到相似内容却答非所问"的情况。

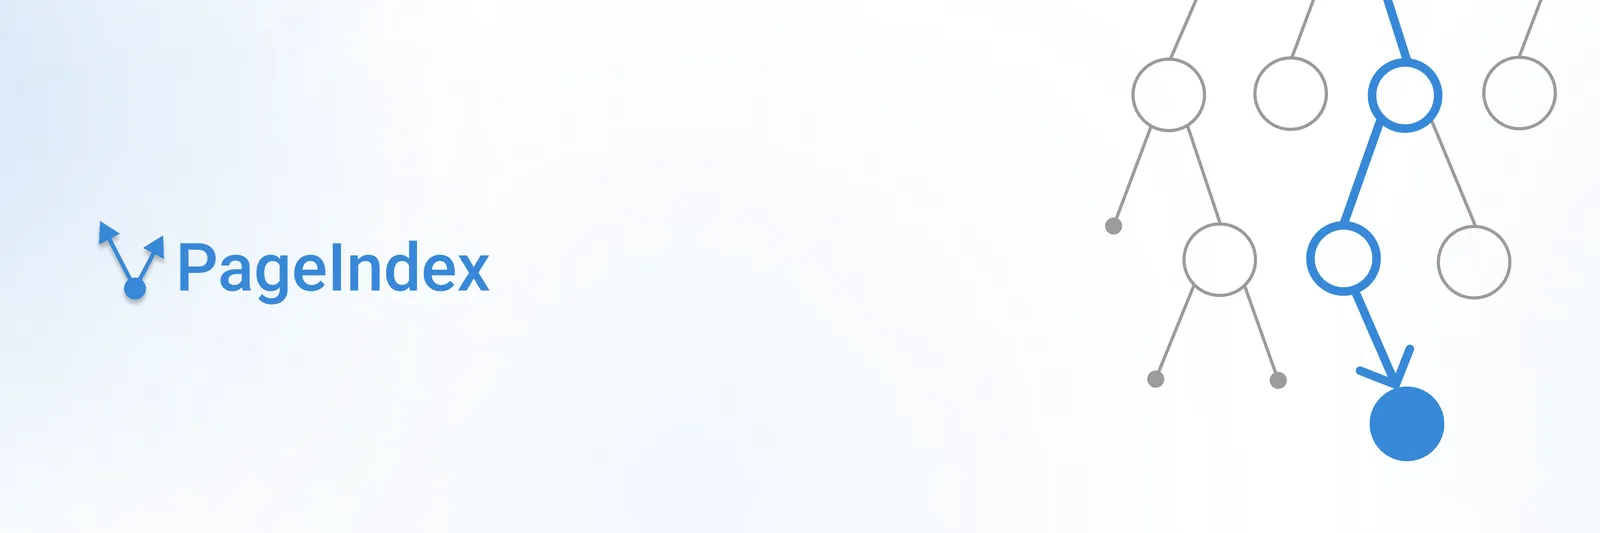
核心定位:受 AlphaGo 启发的无向量数据库推理型 RAG 系统——用树搜索代替向量相似度,让 AI 像专家一样阅读文档。
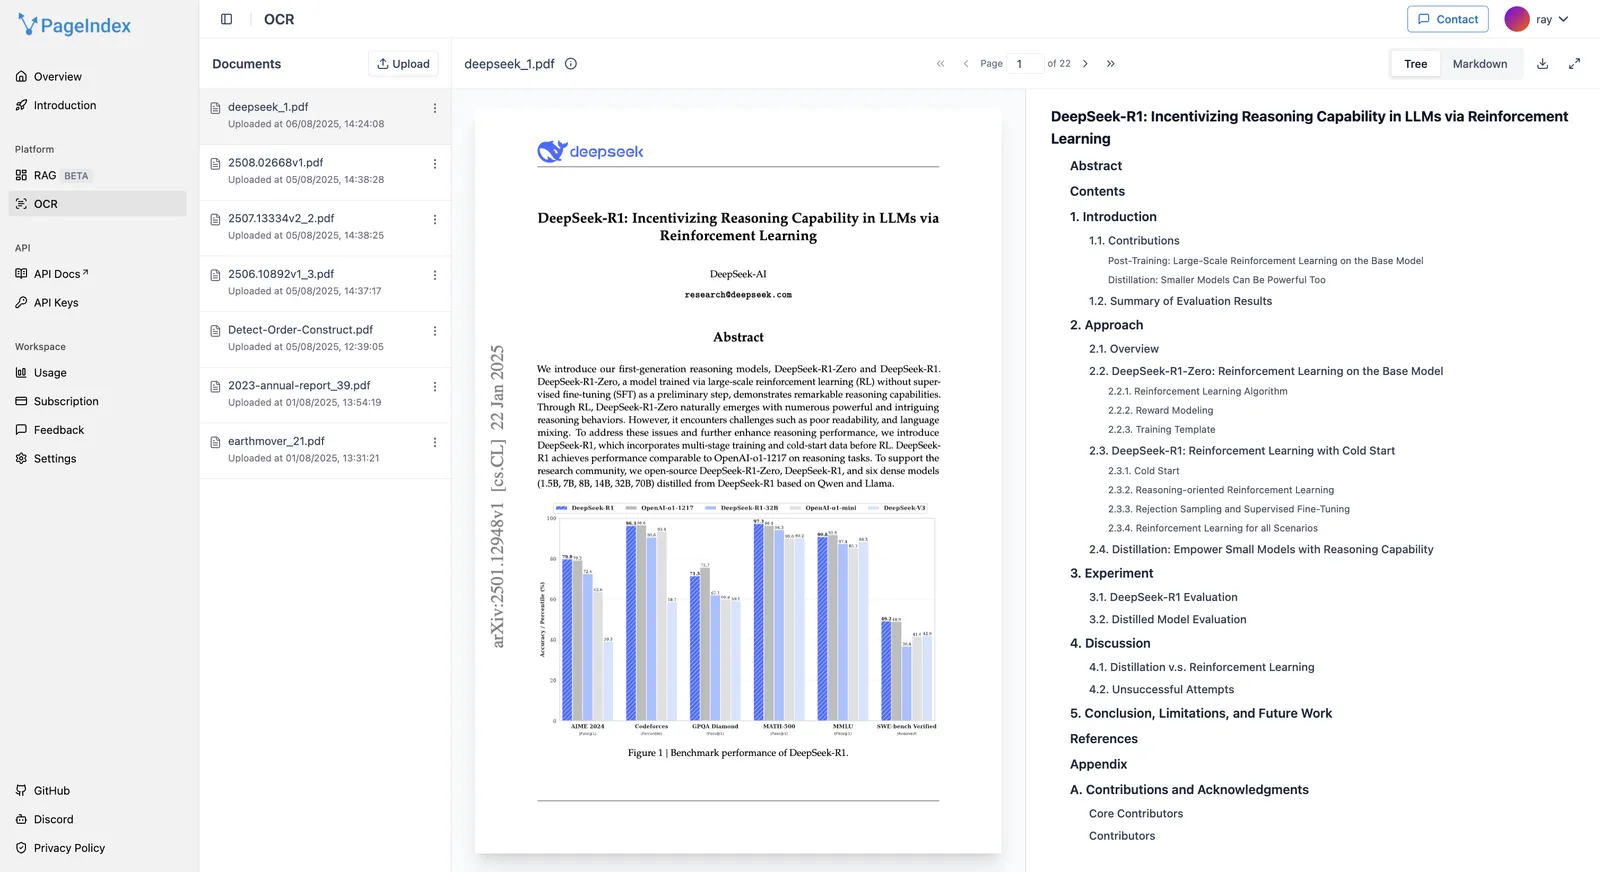
由 VectifyAI 团队开发的 PageIndex,核心思路极其巧妙:不构建向量索引,而是为长文档生成一份层次化的树状索引(类似书籍目录),然后通过 LLM 推理 + 树搜索来定位最相关的内容。检索结果带有明确的页码和章节引用,可追溯、可解释、可验证。
✨ 核心功能一览
💡 适用场景
1. 财务报告深度检索
功能说明:财务报表通常超过数百页,涵盖大量表格、数据和交叉引用。传统向量 RAG 很难定位到正确的财务章节和具体数据段落。PageIndex 通过树状索引结构,直接将问题映射到具体章节和页码。
输入要求:PDF 财务报告(如年报、季报)或 Markdown 格式财务报表
输出效果:精确定位到相关章节,附带页码和章节引用,LLM 基于精准上下文生成回答
适用场景:
- 投资机构分析师快速定位财报关键数据
- 审计师核对财务报告合规性
- 研究人员提取跨年度财务趋势数据
2. 学术教科书智能检索
功能说明:学术教科书(如斯坦福 CS229、MIT 深度学习教材)内容庞大且结构化程度高。PageIndex 天然契合教科书的章节结构,能精准定位到概念讲解、公式推导和实验步骤。
输入要求:PDF 教材或 Markdown 格式课程笔记
输出效果:返回目标章节的精准段落 + 上下文摘要 + 相关子章节导航
适用场景:
- 学生快速查找特定概念解释
- 教师备课定位相关章节内容
- 研究人员跨教材对比不同理论
3. 法律和技术手册查询
功能说明:法律条文、技术规范等专业文档往往字数巨大且要求精确引用。PageIndex 的树状索引天然支持"从宏观到微观"的检索路径,结果附带精确页码和条款编号,完美满足法律和技术文档的引用需求。
输入要求:PDF 法律条文、技术手册或规范文档
输出效果:精准定位到具体条款、页码,附带章节标题和上下文摘要
适用场景:
- 律师查找相关法规条款
- 工程师查阅技术规范
- 合规人员检索政策文件
用户群体总结
- ✅ 金融机构分析师:快速定位财报关键数据,比向量 RAG 准确率高出近 20%
- ✅ 学术研究者:高效检索长篇学术论文和教科书,支持跨章节知识整合
- ✅ 法律和技术专业人士:需要精确引用的场景,结果可追溯、可验证
- ✅ 企业知识管理:内部规范文档、合规手册的智能检索
- ❌ 不适合:简短文档检索(<50 页),简单场景下传统向量 RAG 同样高效
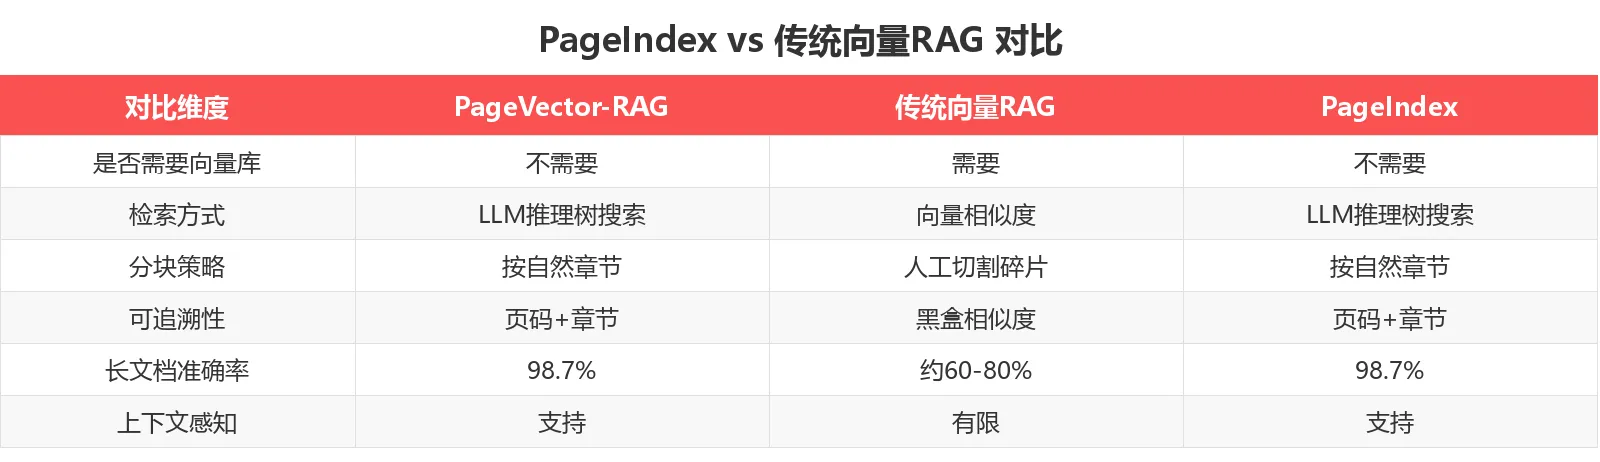
📊 与竞品对比
🛠️ 快速上手:5 分钟跑通示例
安装 / 配置
# 1. 克隆仓库
git clone https://github.com/VectifyAI/PageIndex.git
cd PageIndex

# 2. 安装依赖
pip3 install --upgrade -r requirements.txt

# 3. 配置 API Key(支持通过 LiteLLM 配置多模型)
export OPENAI_API_KEY=your_openai_key_here
# 或 .env 文件中配置
生成文档索引
# PDF 文档生成树状索引
python3 run_pageindex.py --pdf_path /path/to/your/document.pdf

# 或 Markdown 文件生成索引(推荐,速度更快)
python3 run_pageindex.py --md_path /path/to/your/document.md

# 指定模型(可选)
python3 run_pageindex.py --pdf_path report.pdf --model gpt-4o-2024-11-20
生成的索引结构示例
PageIndex 为文档生成的树状索引类似"目录",但针对 LLM 理解进行了优化:
{
  "title": "Financial Stability",
  "node_id": "0006",
  "start_index": 21,
  "end_index": 22,
  "summary": "The Federal Reserve ...",
  "nodes": [
    {
      "title": "Monitoring Financial Vulnerabilities",
      "node_id": "0007",
      "start_index": 22,
      "end_index": 28,
      "summary": "The Federal Reserve's monitoring ..."
    }
  ]
}
Agentic RAG 示例
结合 OpenAI Agents SDK 的完整示例:
# 安装可选依赖
pip3 install openai-agents

# 运行演示脚本
python3 examples/agentic_vectorless_rag_demo.py
注意:支持 LiteLLM 配置多模型,不仅限于 OpenAI。也可通过 MCP 或 API 接入云服务版本,享受增强 OCR 和树构建服务。
💰 定价方案
| 方案 | 说明 | 价格 |
|---|---|---|
| 自托管(开源) | 本地运行,标准 PDF 解析 | 免费(MIT 协议) |
| 云服务 | 增强 OCR + 树构建 + MCP/API | 按量计费 |
| 企业版 | 私有化部署 / VPC | 联系销售 |
开源协议: MIT
💡 新用户福利:开源版本完全免费,无需任何 API Key 即可本地运行基础功能。
🎯 总结
PageIndex 提出了一个极具启发性的 RAG 新范式:不用向量库,用树搜索 + LLM 推理解决长文档检索问题。在 FinanceBench 基准测试中取得 98.7% 的准确率,远超传统向量 RAG 的 60-80%。
它的核心创新在于将 AlphaGo 的树搜索思路引入文档检索领域,让 AI 像人类专家一样"翻书"——先看目录定位章节,再看正文定位段落。这种可追溯、可解释的检索方式,特别适合对准确性要求极高的金融、法律、学术场景。
推荐指数: ⭐⭐⭐⭐⭐(满分 5 星)
适合人群: 需要处理长文档、对检索精度要求高、重视结果可追溯性的团队和个人
立即体验: PageIndex 官网
GitHub 仓库: VectifyAI/PageIndex
数据截至 2026-06-06,最新信息请以官网为准。