🔥 【今日推荐 OpenMythos】:22岁天才破解 Anthropic 闭源架构!循环思考16次,770M 参数打爆 1.3B 模型!
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../OpenMythos-recommend.pptx../../OpenMythos-recommend.mp4本文目录
🔥 【今日推荐 OpenMythos】:22岁天才破解 Anthropic 闭源架构!循环思考16次,770M 参数打爆 1.3B 模型!
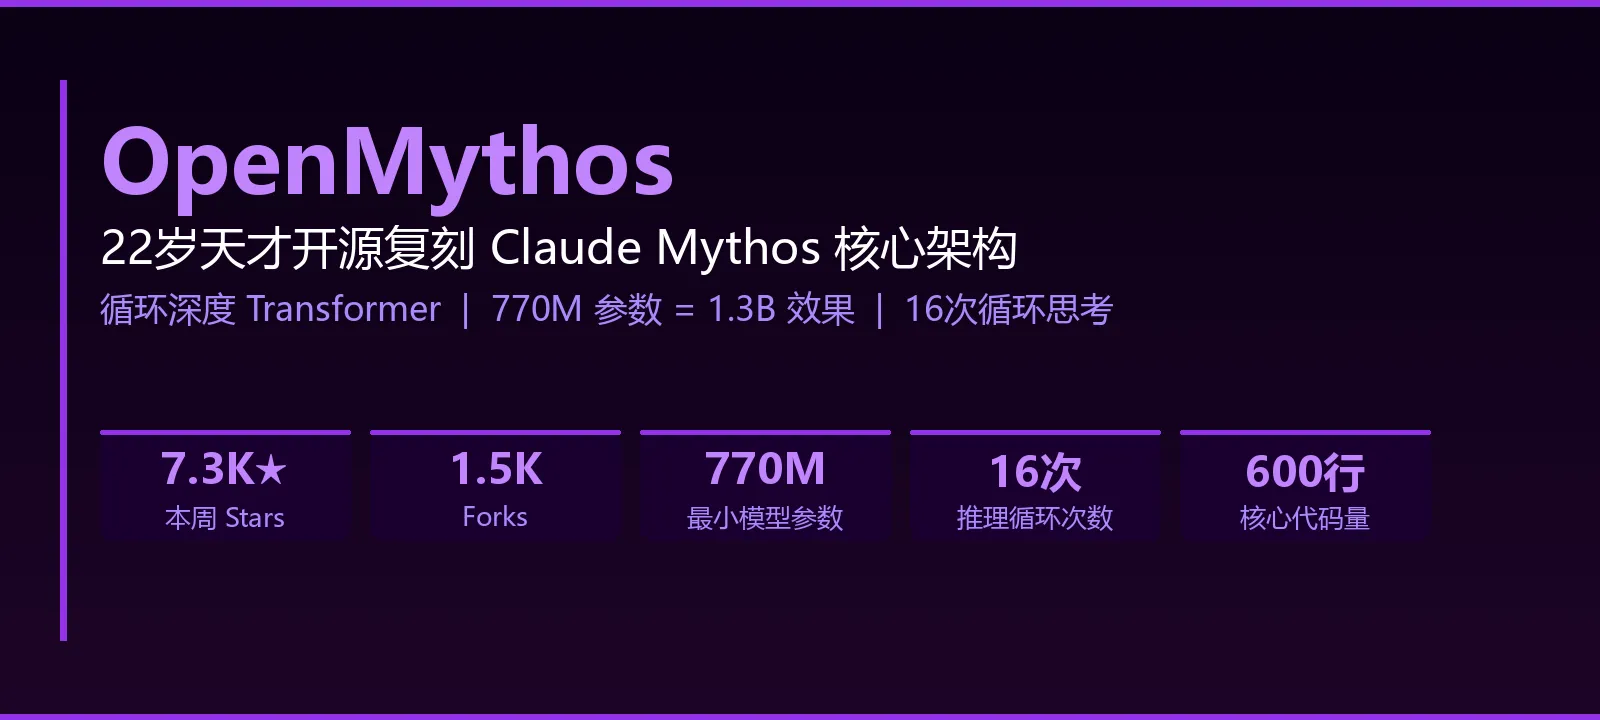
一个22岁创业公司 CEO,用600行 PyTorch 代码,基于公开论文从第一性原理逆向推导出了 Anthropic 最神秘的 Claude Mythos 核心架构——并全部开源。本周 GitHub 狂揽 7300+ Stars,整个 AI 社区都震惊了。


🚀 什么是 OpenMythos?
OpenMythos 是由 22 岁开发者 Kye Gomez 发起的开源项目,旨在用第一性原理对 Anthropic 闭源的 Claude Mythos 架构进行理论性重建。
它不是泄露的模型,也不是蒸馏版本。作者通过深度解析公开学术论文,提出了一个核心假设:Claude Mythos 本质上是一种循环深度 Transformer(Recurrent-Depth Transformer,RDT),通过反复循环同一套权重来实现"隐空间链式推理",而非依赖传统的堆参数 Scaling。
核心结论:k 层权重循环 L 次,等效 kL 层非循环模型的表达能力,但参数量只需 k 层。
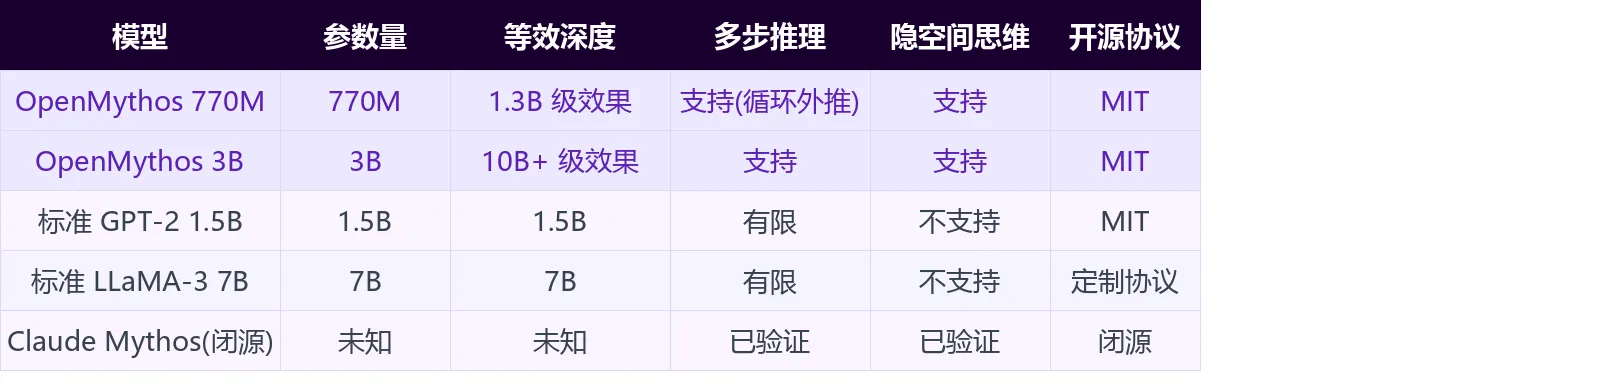
最惊人的数字:OpenMythos 770M 参数模型,可以达到 1.3B 参数标准 Transformer 的等效表达能力,同时在多步推理任务上碾压同量级竞品!
✨ 核心功能一览
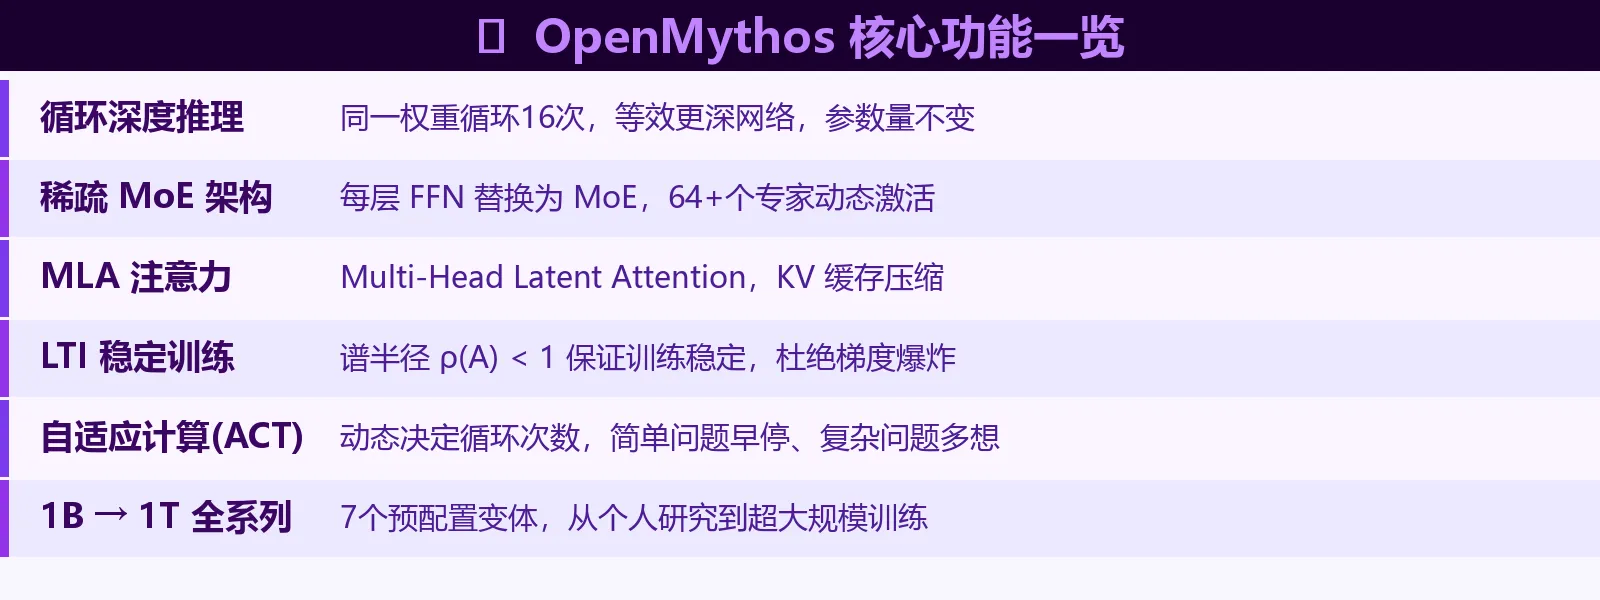
🧠 核心架构:三段式循环 Transformer
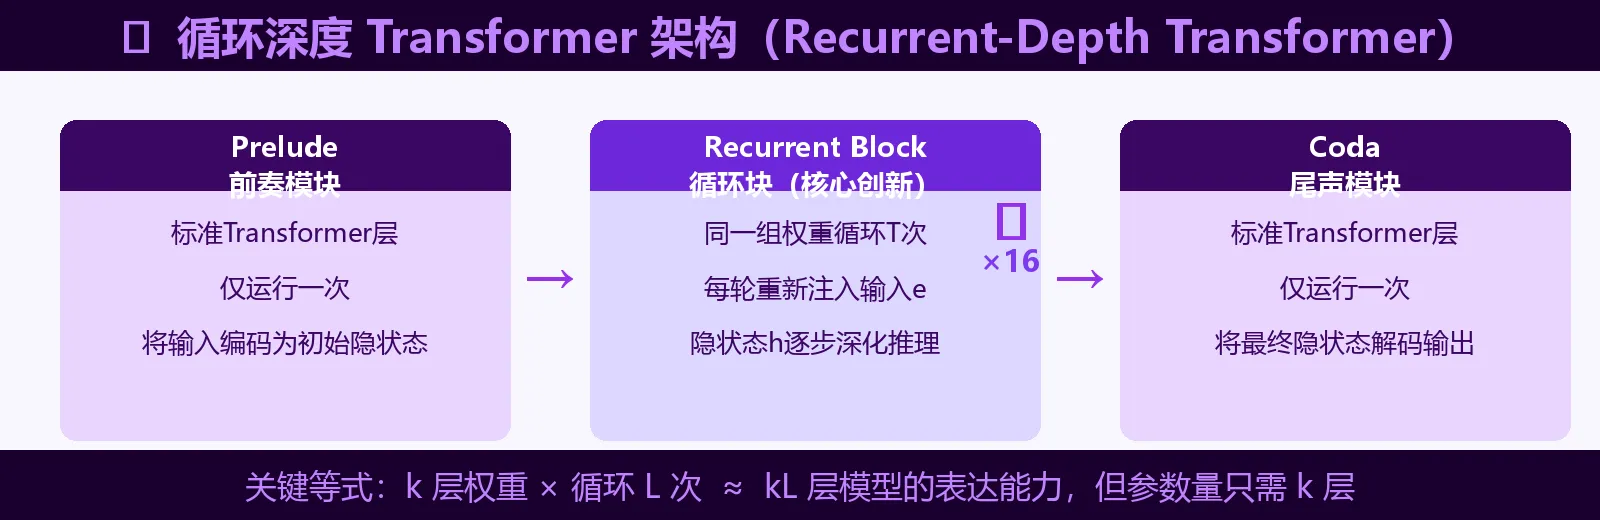
OpenMythos 的整体架构分为三个阶段:
1️⃣ Prelude(前奏)
标准 Transformer 层,只跑一次。把原始输入编码成初始隐状态,交给循环块处理。
2️⃣ Recurrent Block(循环块)— 核心创新
这是整个架构最有价值的部分。同一组权重被循环使用最多 max_loop_iters 次(默认 16 次),每一轮都会把原始输入 e 重新注入到隐藏状态 h 中:
h_{t+1} = A · h_t + B · e + Transformer(h_t, e)
每轮循环就像一步深层推理:
- 第1轮:理解问题表面语义
- 第5轮:建立逻辑关联
- 第10轮:验证推理路径
- 第16轮:输出确定结论
3️⃣ Coda(尾声)
标准 Transformer 层,只跑一次。将最终隐状态解码为输出 token。
最关键的突破:训练时只用5步推理链,测试时用10步推理链,模型依然能成功——传统 Transformer 在这里会彻底失败!
🛠️ 快速上手:5 分钟跑通示例
安装
pip install open-mythos
# 或用 uv(更快)
uv pip install open-mythos
基础使用(MLA 注意力)
import torch
from open_mythos.main import OpenMythos, MythosConfig

# 配置一个小型演示模型
cfg = MythosConfig(
    vocab_size=1000,
    dim=256,
    n_heads=8,
    max_seq_len=128,
    max_loop_iters=4,    # 循环4次
    prelude_layers=1,
    coda_layers=1,
    n_experts=8,         # 8个 MoE 专家
    n_shared_experts=1,
    n_experts_per_tok=2,
    expert_dim=64,
    lora_rank=8,
    attn_type="mla",     # Multi-Head Latent Attention
    n_kv_heads=8,
    kv_lora_rank=32,
    q_lora_rank=64,
    qk_rope_head_dim=16,
    qk_nope_head_dim=16,
    v_head_dim=16,
)

model = OpenMythos(cfg)
total = sum(p.numel() for p in model.parameters())
print(f"参数量: {total:,}")

# 前向传播
ids = torch.randint(0, cfg.vocab_size, (2, 16))
logits = model(ids, n_loops=4)
print(f"Logits shape: {logits.shape}")

# 文本生成(推理时用更多循环!)
out = model.generate(ids, max_new_tokens=8, n_loops=8)

# 验证稳定性:谱半径必须 < 1
A = model.recurrent.injection.get_A()
print(f"谱半径 ρ(A) = {A.max().item():.4f}(必须 < 1,保证训练稳定)")
使用预配置的生产级模型变体
from open_mythos import mythos_1b, mythos_3b, OpenMythos

# 直接用预配置(无需手动设置所有超参数)
cfg = mythos_3b()    # 3B 参数,等效 10B+ 表达能力
model = OpenMythos(cfg)

total = sum(p.numel() for p in model.parameters())
print(f"参数量: {total:,}")
训练自己的循环 Transformer
# 单 GPU 训练 3B 模型
python training/3b_fine_web_edu.py

# 多 GPU 分布式训练(DDP)
torchrun --nproc_per_node=8 training/3b_fine_web_edu.py
注意:训练时使用 FineWeb-Edu 数据集,目标 300 亿 token(Chinchilla 最优比例)。H100/A100 推荐 bfloat16;旧 GPU 使用 float16 + GradScaler。
📊 与竞品对比
💡 适用场景
场景一:AI 架构研究
功能说明:为研究者提供一套完整的循环深度 Transformer 实现,可在其基础上进行实验和改进。代码仅 600 行,结构清晰,注释详尽,是学习前沿架构的绝佳材料。
输入要求:标准文本 token 序列。
输出效果:多步推理质量显著优于同参数量 Transformer。
适用场景:AI 架构论文研究、复现循环 Transformer 基线实验、探索 Scaling Law 新方向。
场景二:低资源高效训练
功能说明:通过权重复用降低参数量,在有限算力下获得更强的推理能力。770M 参数模型等效 1.3B 效果,特别适合学术机构和个人开发者。
输入要求:任意文本训练数据(支持 HuggingFace 数据集格式)。
输出效果:同参数量下多步推理、数学推断、逻辑链条的表现大幅超越标准 Transformer。
适用场景:学术预训练实验、低显存环境下的 LLM 预研、初创团队降低训练成本。
场景三:探索"隐式思维链"
功能说明:不同于显式 Chain-of-Thought(CoT)在 token 层面逐步推理,OpenMythos 在隐空间中每一次循环都等价于一步推理。可以研究模型是如何在内部"默想"的。
适用场景:可解释性 AI 研究、思维链替代方案探索、复杂推理任务(数学/法律/科学)。
用户群体总结
- ✅ AI 架构研究者:用600行代码研究循环 Transformer 的可能性
- ✅ 低算力团队:用更少参数实现更强推理能力,降低训练成本
- ✅ LLM 爱好者:深入理解前沿 LLM 架构设计哲学
- ✅ 学生/学者:基于此实验自己的架构改进想法
- ❌ 不适合:生产级推理部署(尚无预训练权重,需自行训练)
📦 预配置模型规模
| 变体 | 维度 | 专家数 | 循环次数 | 上下文长度 |
|---|---|---|---|---|
| mythos_1b | 2048 | 64 | 16 | 4K |
| mythos_3b | 3072 | 64 | 16 | 4K |
| mythos_10b | 4096 | 128 | 24 | 8K |
| mythos_50b | 6144 | 256 | 32 | 8K |
| mythos_100b | 8192 | 256 | 32 | 1M |
| mythos_500b | 12288 | 512 | 48 | 1M |
| mythos_1t | 16384 | 512 | 64 | 1M |
💰 开源协议
开源协议: MIT License
重要声明:OpenMythos 是独立的社区驱动理论重构项目,完全基于公开研究,与 Anthropic 无任何关联或背书。
💡 完全免费开源! 代码结构清晰,600行核心代码,MIT 协议,可随意用于学术研究和商业项目。
🎯 总结
OpenMythos 是 2026 年 AI 开源社区最令人兴奋的项目之一。它代表的不仅是一个具体工具,更是一种思维方式:与其盲目堆参数,不如设计更智能的推理架构。循环深度 Transformer 理念如果被证实,将颠覆 LLM Scaling Law 的常识认知。
无论 OpenMythos 最终与 Claude Mythos 真实架构的相似度有多高,单就"用第一性原理重建闭源 AI 架构"这件事本身,就足以让整个 AI 社区为之侧目。
这是一个值得每一位 AI 工程师和研究者认真 star 并深读的开源项目。
推荐指数: ⭐⭐⭐⭐⭐
适合人群: AI 研究者、LLM 爱好者、架构设计者、在校学生
GitHub 仓库: kyegomez/OpenMythos
数据截至 2026-04-22,最新信息请以官方仓库为准。项目仍在快速迭代,建议 Watch 仓库获取最新进展。