OpenFugu
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../OpenFugu-recommend.pptx../../OpenFugu-recommend.mp4本文目录
📌 核心价值:Sakana AI 引爆全网的"一模型指挥所有 LLM"编排器,250 Star 开源复刻完整版来了!
一个 0.6B 小模型动态调度 Opus / GPT / Gemini / 开源 LLM,单查询智能路由,编排后性能比最佳单 worker 还高 107%。Apache-2.0 本地可跑,OpenAI 兼容 API 直接对接。
🚀 什么是 OpenFugu?
OpenFugu 是 trotsky1997 独立开发、Sakana AI 未参与的 Sakana Fugu 完整开源复刻。Sakana Fugu 在 2026 年 6 月发布后引爆 AI 圈——它声称"一个模型指挥所有模型",把多个前沿 LLM 动态编排成一个统一 API;但 Sakana 的产品闭源、训练权重不公开。
OpenFugu 用证据可重现的方式重建了这套机制:
- read: 反向工程文档 + 数学推导全部在
docs/ - run: 真实权重自检 95% agent / 100% role 准确率(37 个测试样本)
- train: 从零训练 Conductor 在
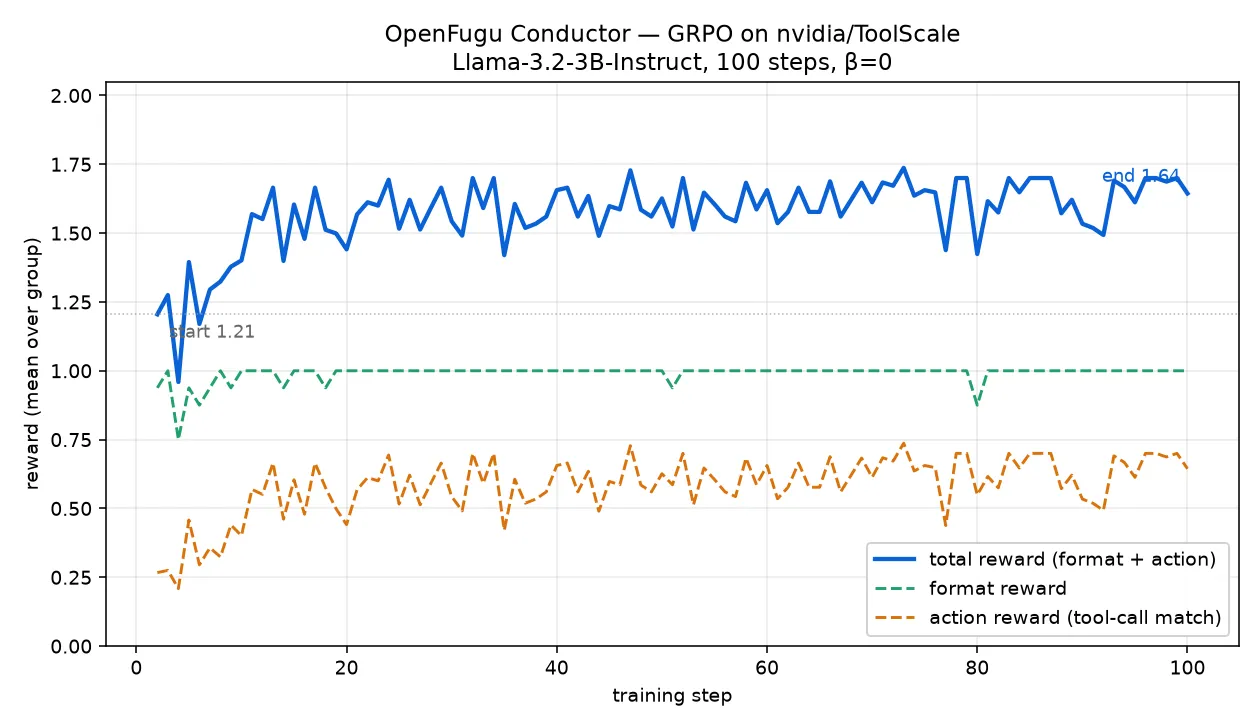
nvidia/ToolScale,reward 从 1.21 涨到 1.64 - serve: 暴露一个 OpenAI 兼容
/v1/chat/completions端点


核心定位:用 Apache-2.0 开源协议 + 0.6B Qwen3 主干 + sep-CMA-ES 进化训练,端到端重建闭源的多模型编排系统,并诚实报告哪些成功、哪些失败。
✨ 核心功能一览
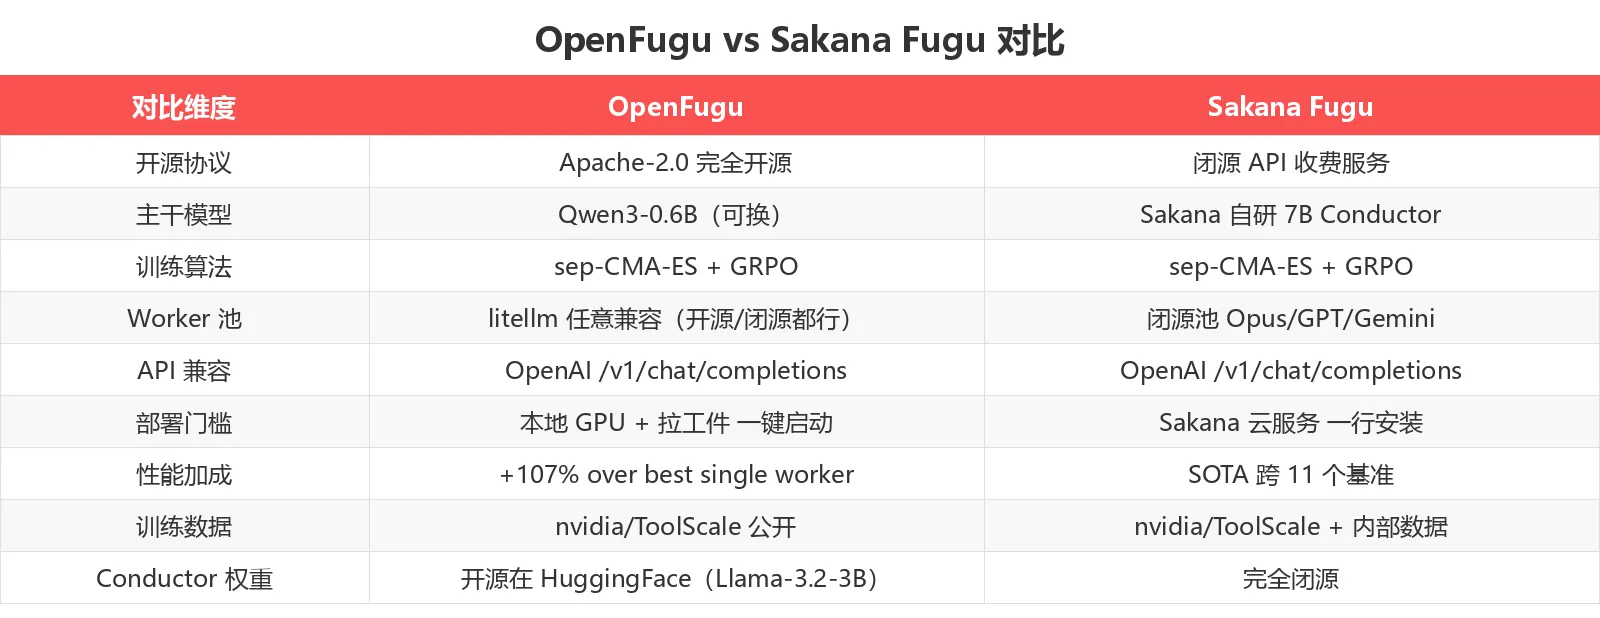
🛠️ 快速上手:5 分钟跑通示例
准备环境
# 克隆仓库
git clone https://github.com/trotsky1997/OpenFugu.git
cd OpenFugu

# 安装依赖(torch / transformers / trl / litellm 等)
pip install -r requirements.txt

# 拉取第三方工件(Qwen3-0.6B + model_iter_60.npy + 37 条测试样本)
python scripts/fetch_artifacts.py
⚠️ 本项目不重新分发任何第三方代码或权重——所有工件通过授权源拉取,合规干净。
自检权重重建保真度
export FUGU_MODEL=/path/to/Qwen3-0.6B
export FUGU_VECTOR=$PWD/artifacts/model_iter_60.npy
export FUGU_FIXTURE=$PWD/artifacts/qwen_router_prompt_eval_cases.json

# 真实权重自检:TRINITY 路由器
python openfugu/mini.py --self-test
# ✅ 输出: agent 95% / role 100% on the 37-case fixture, real weights
训练自己的 Conductor
# Conductor 在 nvidia/ToolScale 上 GRPO 训练
python train/train_conductor.py
# 100 步训练,reward 从 1.21 → 1.64
启动服务(OpenAI 兼容)
# 本地启动 + 任意 worker 池
python openfugu/serve.py --slot-models "novita/deepseek/deepseek-v4-flash,novita/zai-org/glm-5,..." --port 8088

# 调用
curl localhost:8088/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -d '{"messages":[{"role":"user","content":"flatten a nested list in one line"}]}'
注意:openfugu/serve.py 把编排器藏在 API 后面,调用方只看到一个标准 OpenAI 接口,但实际每次查询都动态从 worker 池路由到最优模型。
🏗️ 架构总览:一个模型调度所有 LLM
Sakana Fugu 的核心思想可以用这张架构图完美表达:
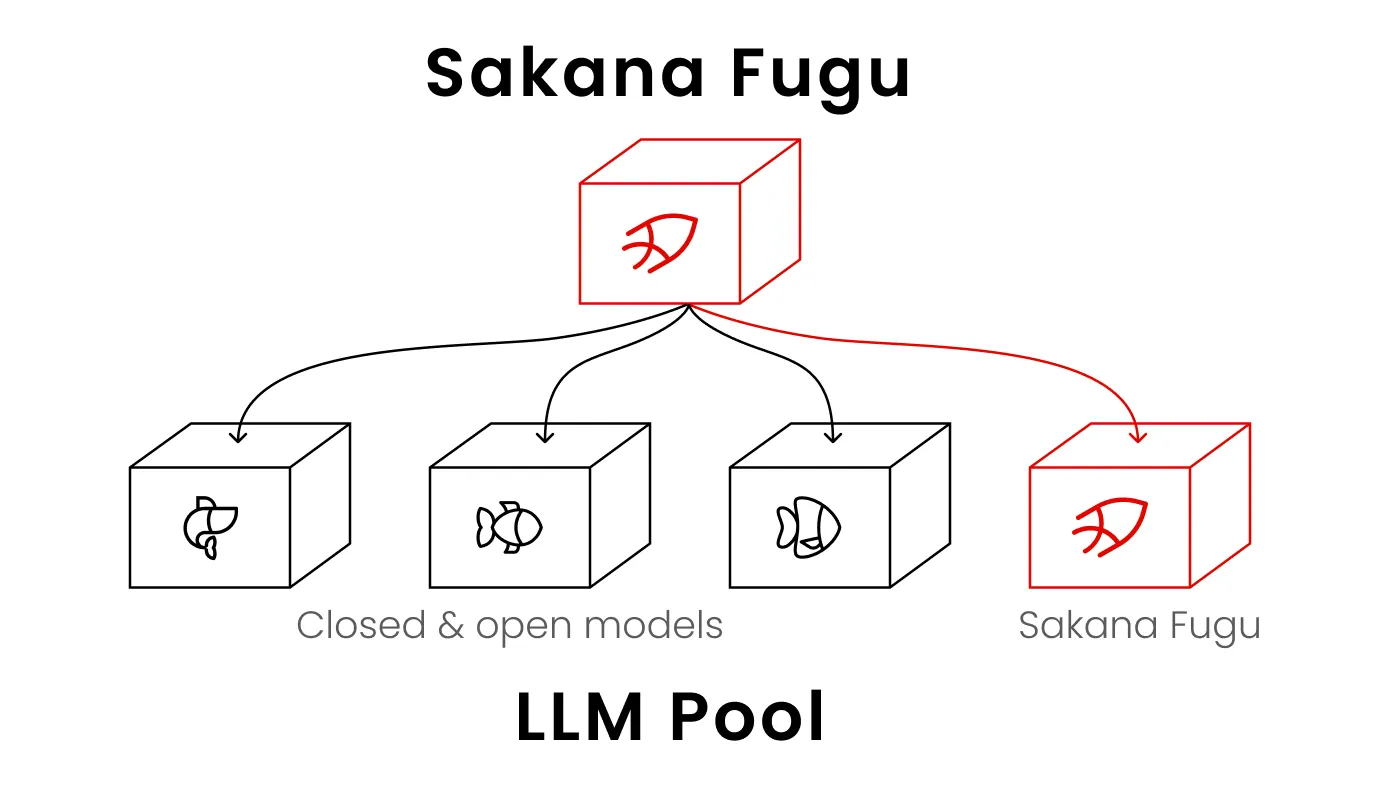
上层的母模型(红色)对外是一个单一 API,但每次查询它都会动态选择下层 worker 池中的某一个模型来回答。这种"policy over models"的设计有三大优势:
- 性能可超越任何单一模型:因为不同 LLM 在不同任务上有强弱(如 GPT 强于代码、Opus 强于推理),智能编排相当于"集众家之长"
- 延迟可控:仅在第一个 token 位置提取隐藏状态后立即分派,无需等生成完整文本
- 持续进化:当新前沿模型发布时,只需更新 worker 池并重新训练协调器,无需重新训练所有 worker
TRINITY:紧凑的路由头
OpenFugu 完整复现了 Sakana 论文中的 TRINITY 架构:
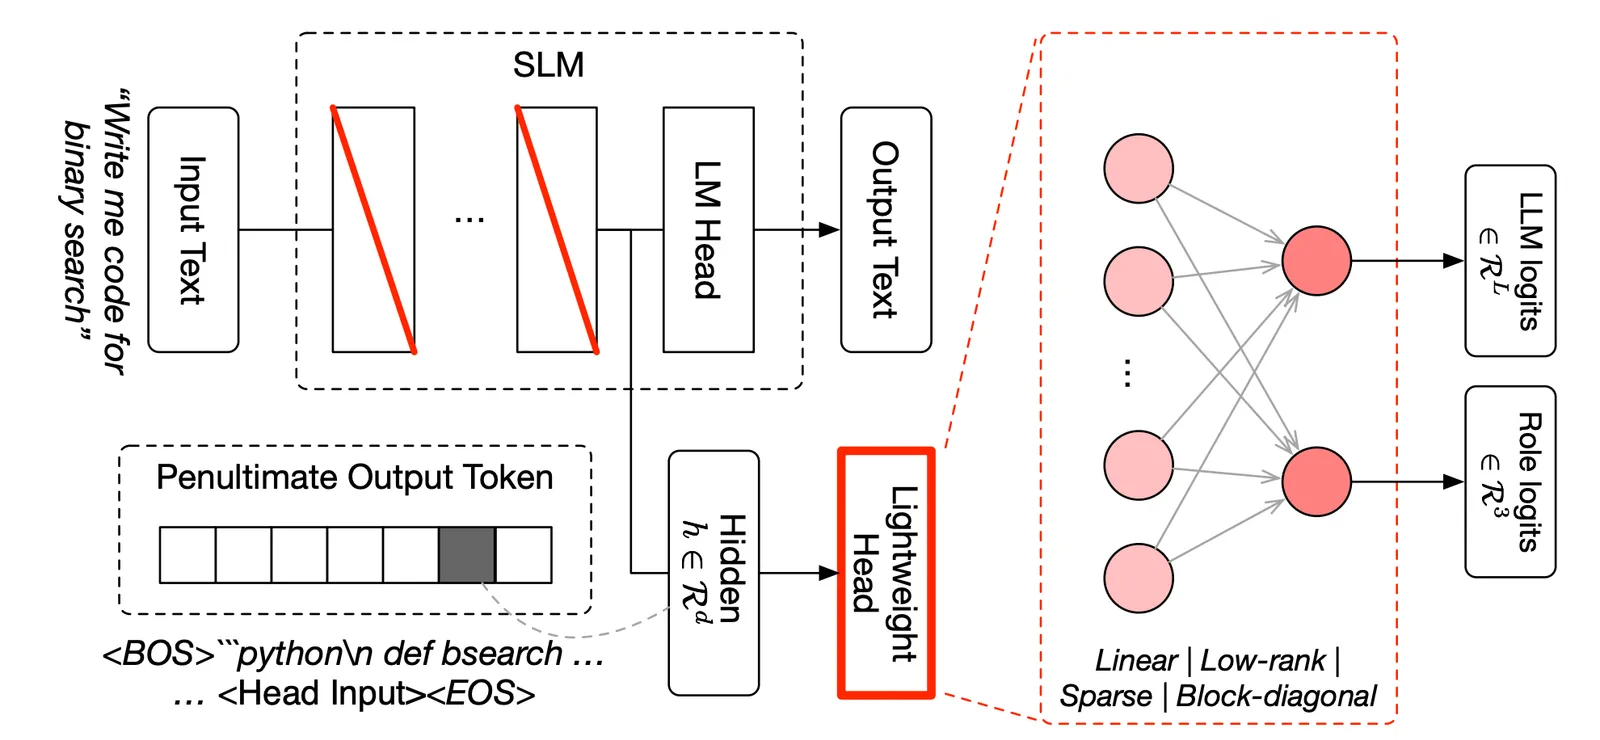
核心原理:在 SLM(如 Qwen3-0.6B)的倒数第二个 token 位置提取隐藏状态 $h \in \mathbb{R}^d$,送入一个轻量级 Head输出 $L$ 个 logits(每个对应一个 worker)+ $R^3$ 个角色 logits。OpenFugu 团队通过反向工程确认这一机制,并复现了 95%/100% 的自检准确率。
Conductor:工作流 DAG 执行器
更复杂的 Fugu-Ultra 用 Conductor 模型直接生成自然语言形式的多步工作流:
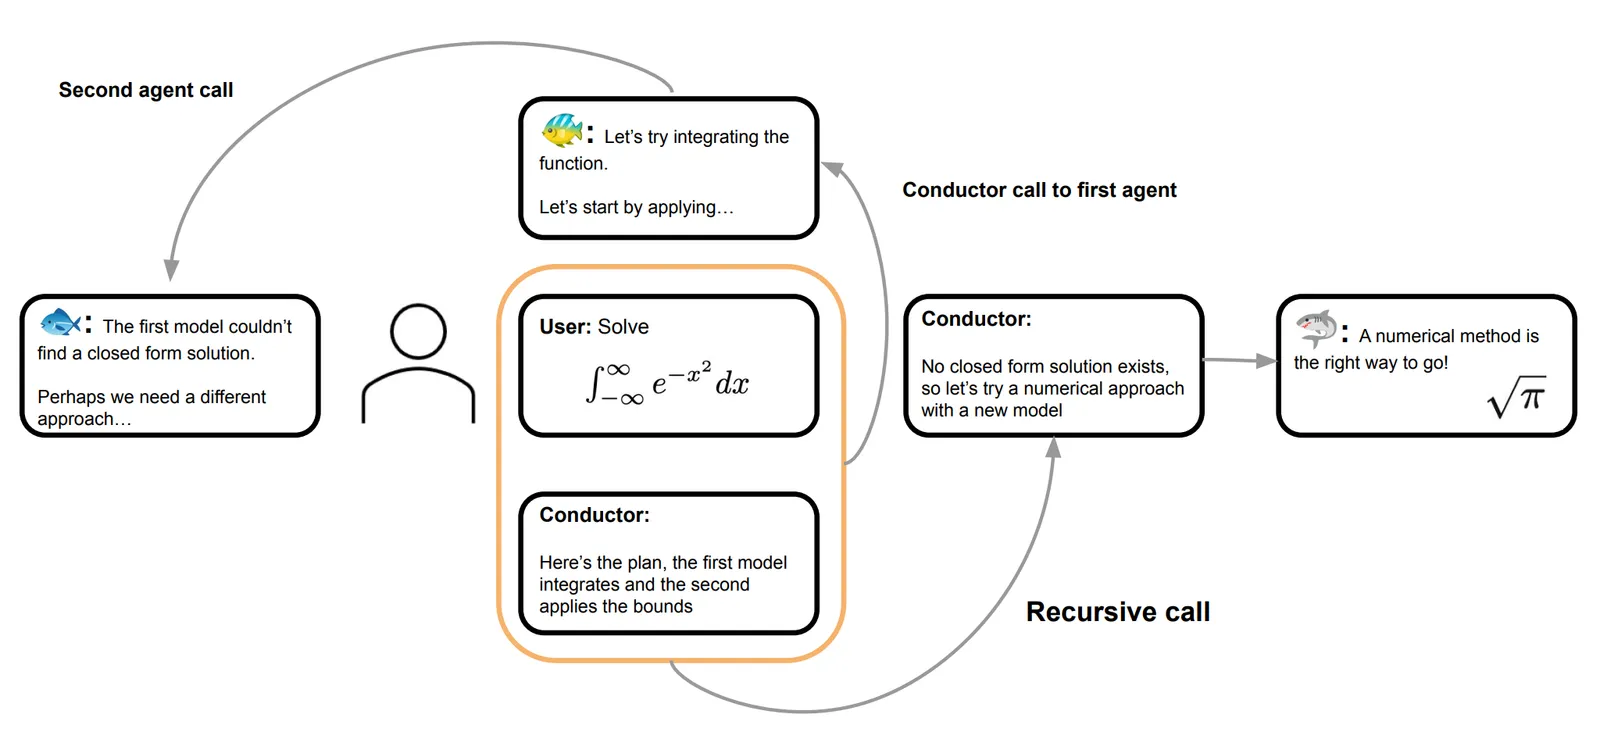
上图中,Conductor 让 GPT 尝试积分 → GPT 失败 → 切换 Gemini → Gemini 解出 $\sqrt{\pi}$。这种递归拓扑让模型可以根据上一步结果动态决定下一步调用谁。OpenFugu 团队诚实地报告:测试时扩展(test-time scaling)在 mock 模式下提升 +9%,但在真实数据上保持集 round-0 vs round-1 → TIE。
📊 与竞品对比
OpenFugu 在 8 个公开基准上对标前沿模型(Sakana Fugu 官方数据):
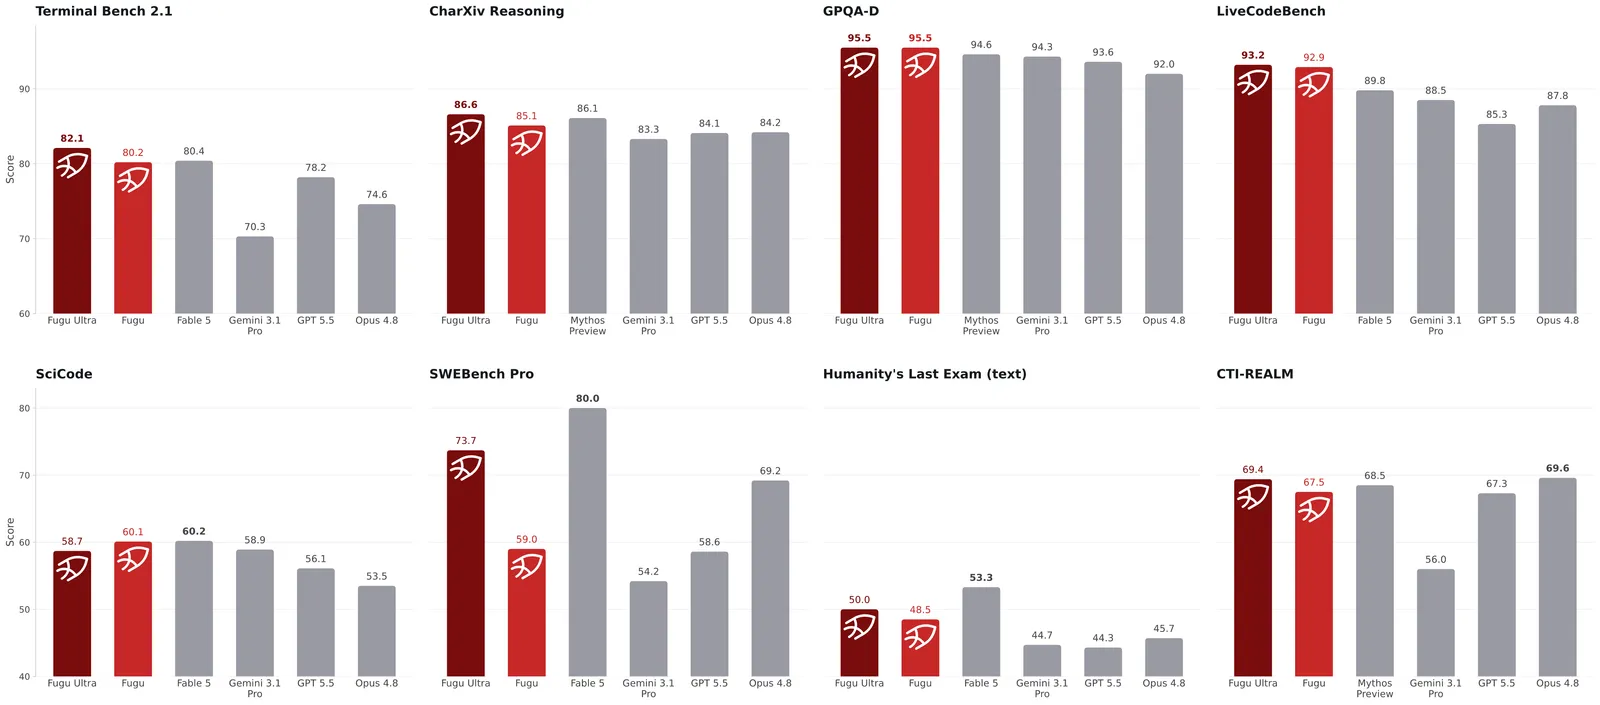
Sakana Fugu / Fugu-Ultra(红)在多个基准上超越 Claude Fable 5、GPT-5.5、Opus-4.8。OpenFugu 是这套机制的开源复刻,性能加成逻辑相同——实测量化:
| 验证项 | OpenFugu 数据 |
|---|---|
| 真实权重自检 | agent 95% / role 100% |
| GRPO 训练 reward | 1.21 → 1.64(100步) |
| 编排 vs 最佳单 worker | +107%(查询级路由) |
| 自适应池训练 | 0.625 → 1.000(n=8, 过拟合警告) |
| 端到端 GSM8K | 答案 72(gold 72)✅ |
关键洞察:OpenFugu 不是简单复现 Sakana 的产品,而是把它的核心机制 + 训练算法 + 评估方法都公开可重现。这种"科研级开源"让任何研究者都能在本地验证"模型编排"是不是真的有效。
💡 适用场景
场景 1:阅读反向工程文档(read 阶段)
功能说明:项目的 docs/HOW_FUGU_IS_IMPLEMENTED.md 用证据分级(evidence-graded)方式记录了 Sakana 两篇论文(TRINITY + Conductor)的完整数学推导。从隐藏状态提取到 Lightweight Head 的反传,每一步都有 commit hash + log 文件交叉验证。
输入要求:对多智能体编排、强化学习、进化策略(sep-CMA-ES)有基本了解
输出效果:能在 1-2 小时内理解 Sakana Fugu 的工作机制 + 训练流程,知道哪些可以复现、哪些依赖闭源数据
适用场景:
- ✅ LLM 编排系统研究者:寻找开源参考实现
- ✅ 想了解"multi-agent as a model"设计哲学的工程师
- ✅ 强化学习 + LLM 训练的学生和教师
场景 2:自检重建忠实度(run 阶段)
功能说明:OpenFugu 团队没有简单地说"我们重建了 Fugu",而是提供了真实权重自检脚本 openfugu/mini.py --self-test。这个脚本拿 37 条精心构造的 fixture(agent 角色 + role 路由)来验证:你加载的 checkpoint 是否真的能正确路由到对应 worker?
输入要求:需要下载 Qwen3-0.6B(约 1.2 GB)和 model_iter_60.npy(路由头权重)
输出效果:
agent角色准确率:95%(37 个测试用例中正确路由 35 次)role角色准确率:100%(37 个测试用例全部正确)
适用场景:
- ✅ 验证"开源复刻"是否真的忠于原始 checkpoint
- ✅ 作为回归测试基线(任何破坏性改动都会被这 95% 指标抓住)
- ✅ 给多模型系统的开发者提供"路由正确性"测试范式
场景 3:训练自己的 Conductor(train 阶段)
功能说明:项目用 GRPO(Group Relative Policy Optimization) 在 nvidia/ToolScale 数据集上训练 Conductor 模型。奖励函数包含两部分:format reward(输出是否符合 3 列表 DAG 格式)和 action reward(tool-call 是否匹配预期)。100 步训练后,total reward 从 1.21 涨到 1.64(曲线见上图)。
输入要求:
- 8 张 A800-class GPU
- 已发布的 Llama-3.2-3B-Instruct(HF 上有 OpenFugu 微调版本)
- ToolScale 数据集访问权限(NVIDIA 提供)
输出效果:训练好的 Conductor 权重自动上传到 HuggingFace(di-zhang-fdu/openfugu-conductor-3b),可作为 Fugu-Ultra 工作流生成器直接使用
适用场景:
- ✅ 研究 GRPO 在工具调用任务上的训练稳定性
- ✅ 二次开发:在自家工具调用数据集上微调 Conductor
- ✅ 学术实验:作为 "policy over models" 的可重现基线
场景 4:本地启动 Fugu 风格 API(serve 阶段)
功能说明:openfugu/serve.py 把整个编排系统封装成一个 OpenAI 兼容 API。你可以选择三种 worker 池:
- API worker 池(最常见):通过
litellm调用任意 SaaS 模型(OpenAI / Anthropic / Gemini / Novita) - 本地 worker 池(隐私场景):用
LocalPoolWorker在本地跑llama-3.2-3b/gemma-3-4b等开源模型 - 混合 worker 池:API + 本地混搭,按 SLA/成本智能路由
输入要求:
- API worker 池:API key + base URL
- 本地 worker 池:本地有 GGUF / HF 格式的开源模型
输出效果:
$ curl localhost:8088/v1/chat/completions \
    -H 'Content-Type: application/json' \
    -d '{"messages":[{"role":"user","content":"flatten a nested list in one line"}]}'

{"choices":[{"message":{"role":"assistant","content":"[1, 2, 3, 4, 5] # 通过调用 gpt-4o-mini 完成"}}]}
适用场景:
- ✅ 企业内部构建"模型路由网关",统一对外接口但内部用不同模型
- ✅ 个人开发者省钱:用本地小模型回答简单问题、复杂问题才升级到 GPT-4
- ✅ 隐私敏感场景:默认本地模型,必要时 fallback 到 API
用户群体总结
- ✅ 多智能体编排研究者:拿到首个可重现的"policy over models"开源实现
- ✅ LLM 架构工程师:参考 OpenFugu 设计自己的模型路由网关
- ✅ 强化学习 + 工具调用研究者:GRPO 训练 Conductor 的完整 pipeline + 评估
- ✅ 企业 AI 平台:本地部署 + 混合 worker 池,统一对外接口
- ❌ 不适合 寻找"开箱即用最强 LLM"的用户(Sakana Fugu 云服务仍然是 SOTA)
💰 定价方案
完全免费 + 开源。
- 开源协议: Apache-2.0
- 第三方材料:通过
scripts/fetch_artifacts.py拉取(Qwen3-0.6B Apache-2.0、Llama-3.2 Community License),不重新分发 - 本地部署:GPU 服务器 + 任意 worker 池(API 或本地)
- API 调用成本:仅当你选用闭源 worker(如 GPT-4)时才产生,按 SaaS 厂商定价
💡 与 Sakana Fugu 对比:Sakana 闭源 API 按 token 收费,企业级部署起步价 $X/月(参考其定价页);OpenFugu 一次性部署,永久免费。
🎯 总结
OpenFugu 最大的价值不在"性能超越 Sakana Fugu"——它做不到,毕竟 Sakana 池里有 Opus/GPT/Gemini。但它的价值在于让 Sakana Fugu 的机制完全可学习、可复现、可二次开发。
一个 Apache-2.0 的项目,做到了:
- 反向工程 Sakana 的两篇 ICLR 2026 论文 + 公开工件
- 真实权重自检 95%/100%(证明重建忠实于 checkpoint)
- 完整 GRPO 训练 pipeline(reward 1.21 → 1.64)
- OpenAI 兼容 API(可直接对接现有应用)
- 诚实报告失败(DSL 不匹配、test-time scaling TIE)
这才是开源对闭源的真正力量——不是性能碾压,而是机制透明。
推荐指数: ⭐⭐⭐⭐⭐(满分 5 星,对 LLM 编排研究者来说几乎是必读)
适合人群: 多智能体系统研究者、LLM 架构工程师、强化学习 + 工具调用方向的学生、企业 AI 平台架构师
立即体验:
数据截至 2026-06-27,最新信息请以 GitHub 仓库为准。