Moebius
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../Moebius-recommend.pptx../../Moebius-recommend.mp4本文目录
📌 核心价值:华中科大 + VIVO 联合发布 ECCV 2026 顶会开源图像修复模型,0.22B 参数打平 10B 级工业 SOTA,推理加速 15×
Scaling Law 不再是 AI 进步的唯一路径——华科 + VIVO 用 0.22B 小模型在 6 个基准上对标/超越 FLUX.1-Fill-Dev,让消费级 GPU 也能跑 10B 级图像修复。
🚀 什么是 Moebius?
Moebius 是华中科技大学(hustvl 实验室)+ VIVO AI Lab 联合发布的轻量级图像修复框架(Image Inpainting),2026-06-18 被 ECCV 2026 接收。它的核心卖点是:用 0.22B(226M)参数实现对标/超越 10B 级工业 SOTA 的修复质量。
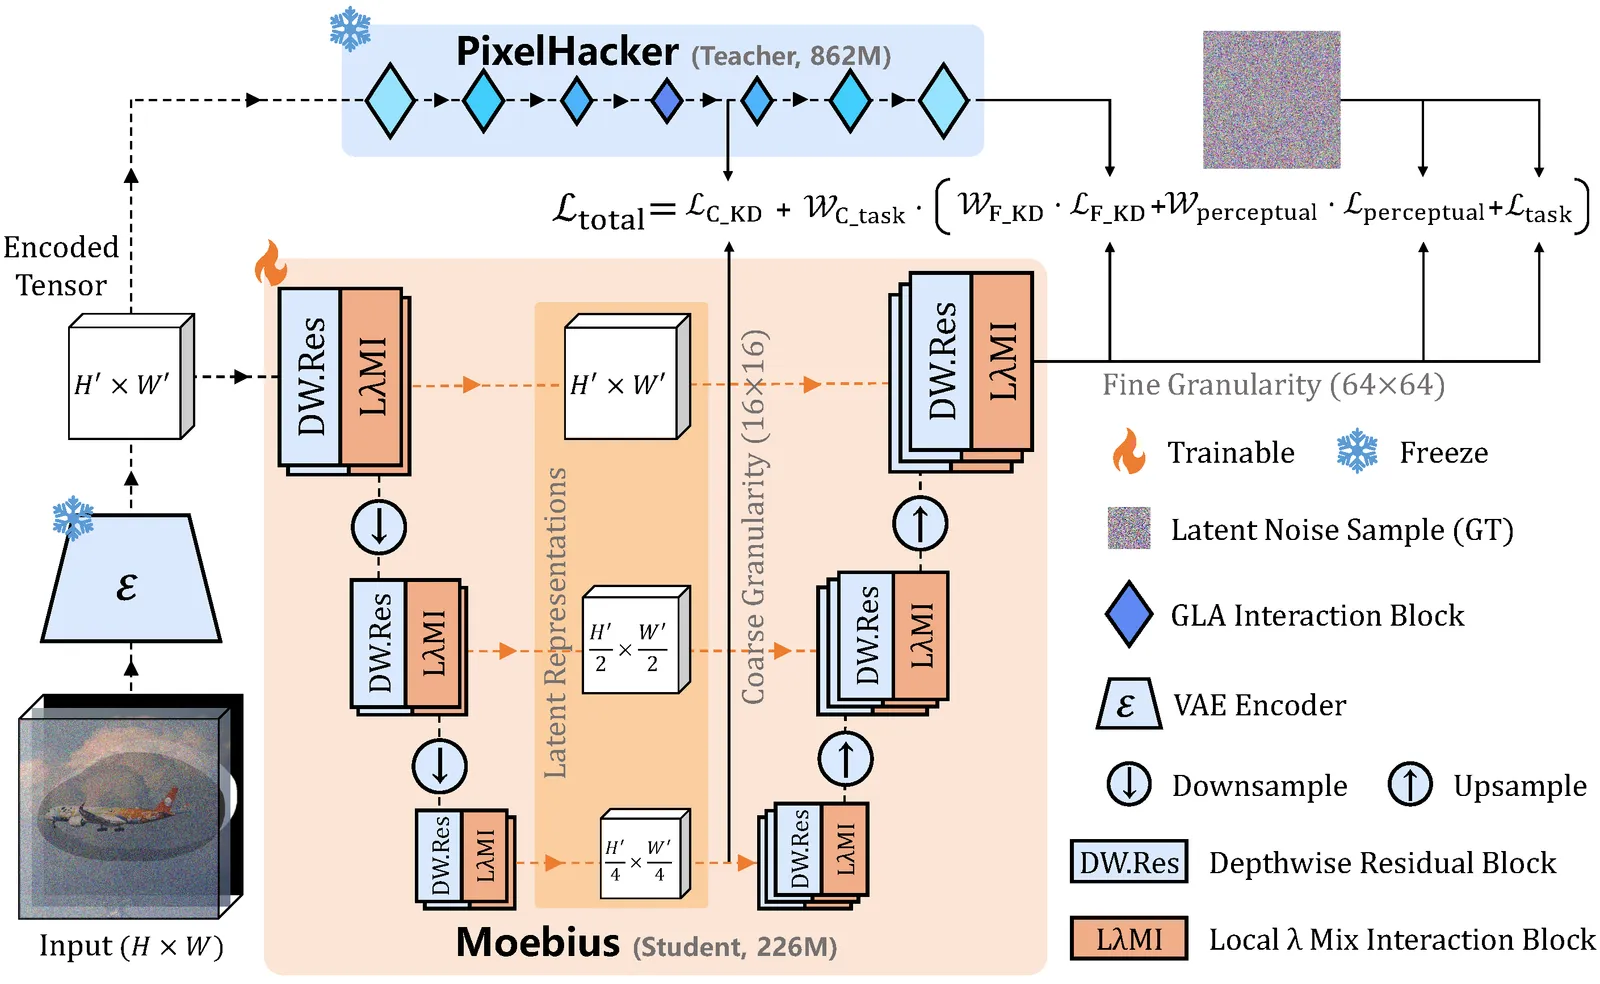
参数效率极度夸张——Moebius 不到 FLUX.1-Fill-Dev(11.9B)的 2%,单步推理延迟仅 26.01ms,相比工业 SOTA 整体加速 >15×。在 Hugging Face 日榜/周榜连续冲顶(06-19 日榜第 1,06-25 周榜第 4/105)。
核心定位:打破"低参数 + 快推理 + 高质量"的不可能三角——协同架构设计与知识蒸馏两手抓


✨ 核心功能一览
极致的参数效率(< 2%)
- Moebius 仅含 0.22B(226M)参数
- 仅为 FLUX.1-Fill-Dev(11.9B)的 不到 2%
- 可在消费级 GPU / 边缘设备上部署
15× 推理加速(26ms/step)
- 单步推理延迟 26.01 ms
- 整体运行时间加速 >15×
- 实时性场景可用(直播修图、视频去水印)
10B 级修复质量
- 在 6 个综合基准测试中,与 FLUX.1-Fill-Dev、SD3.5 Large-Inpainting 等 10B 级 SOTA 模型持平或超越
- 覆盖 自然场景(Places2)和 人像场景(CelebA-HQ、FFHQ)
协同核心创新
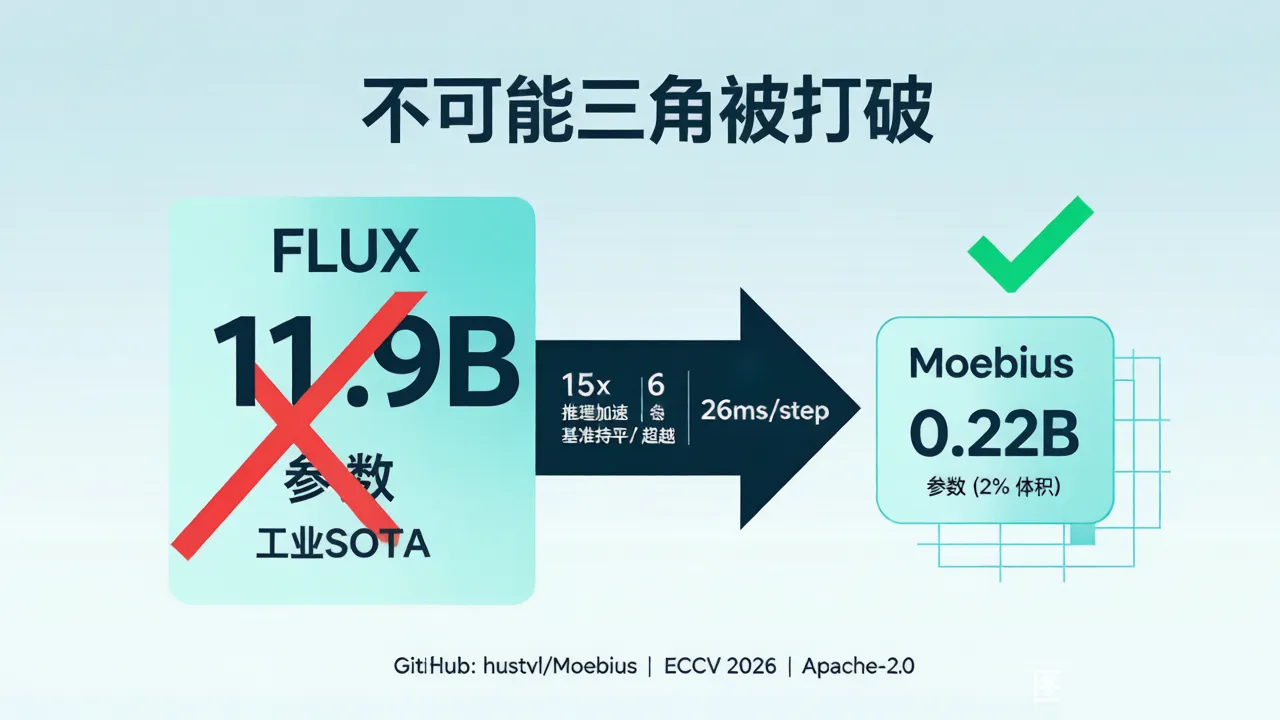
(1) 架构设计 - LλMI Block:
- 重新设计自注意力和交叉注意力
- 将空间上下文和全局语义先验压缩为固定大小的线性矩阵
- 绕过二次计算开销
(2) 自适应多粒度蒸馏策略:
- 在 latent space 中严格迁移教师模型(PixelHacker)的表征能力
- 避免昂贵的像素空间解码
- 对齐从微观中间特征到宏观扩散轨迹的多粒度监督
- 通过梯度范数自适应损失加权机制动态平衡训练
(3) 最优协同平衡:
- 系统探索紧凑结构与蒸馏之间的相互约束
- 映射"架构-蒸馏协同前沿"
- 确保 0.22B 学生模型能最大限度吸收教师模型的语义推理能力
协同 × (架构 + 蒸馏) = 打破"低参数、快推理、高质量"的不可能三角
🛠️ 快速上手:5 分钟跑通示例
环境安装
# 推荐使用 conda
conda create -n moebius python=3.14.4
conda activate moebius

# 克隆仓库
git clone https://github.com/hustvl/Moebius.git
cd Moebius

# 安装依赖
pip install -r requirements.txt
核心依赖:
- torch=2.7.1
- diffusers=0.38.0
- transformers=4.56.2
- flash-linear-attention=0.3.2
模型权重组织结构
Moebius/
├── weight/
│   ├── Moebius/
│   │   ├── pretrained/           # 通用预训练权重
│   │   ├── ft_places2/          # 自然场景微调
│   │   ├── ft_celebahq/         # CelebA-HQ 人像微调
│   │   └── ft_ffhq/             # FFHQ 人像微调
│   └── vae/                      # VAE 模块
└── config/
注意:HF 仓库分 4 个子目录(pretrained/ft_places2/ft_celebahq/ft_ffhq),下载时要把 4 个子目录都拉下来
推理代码(CLI)
# 自然场景(Places2)图像修复
python -m infer.infer_moebius \
    --model-config config/model_cfg/moebius.yaml \
    --model-weight weight/Moebius/ft_places2/diffusion_pytorch_model.bin \
    --real-dir data/images \
    --mask-dir data/masks \
    --save-dir ./outputs \
    --cfg 2.0 \
    --batch-size 8 \
    --num-workers 8
训练代码
# 单 GPU 训练
PY_TRAINER=train_distillation.py bash run/run_ddp_1node.sh config/train_demo.sh

# 多 GPU 训练(4 卡)
NUM_GPUS_PER_MACHINE=4 bash run/run_ddp_1node.sh config/train_demo.sh
📊 与竞品对比:6 个基准对标/超越 10B 工业 SOTA
核心参数与速度对比
| 模型 | 参数量 | 单步延迟 | 相对速度 |
|---|---|---|---|
| FLUX.1-Fill-Dev | 11.9B | ~390 ms | 1× 基线 |
| SD3.5 Large-Inpainting | ~8B | ~280 ms | ~1.4× |
| Moebius(0.22B) | 0.22B | 26.01 ms | >15× |
0.22B 参数 = FLUX 的 1.8% 体积 = 15× 加速,仍能跑出同等质量
6 基准修复质量
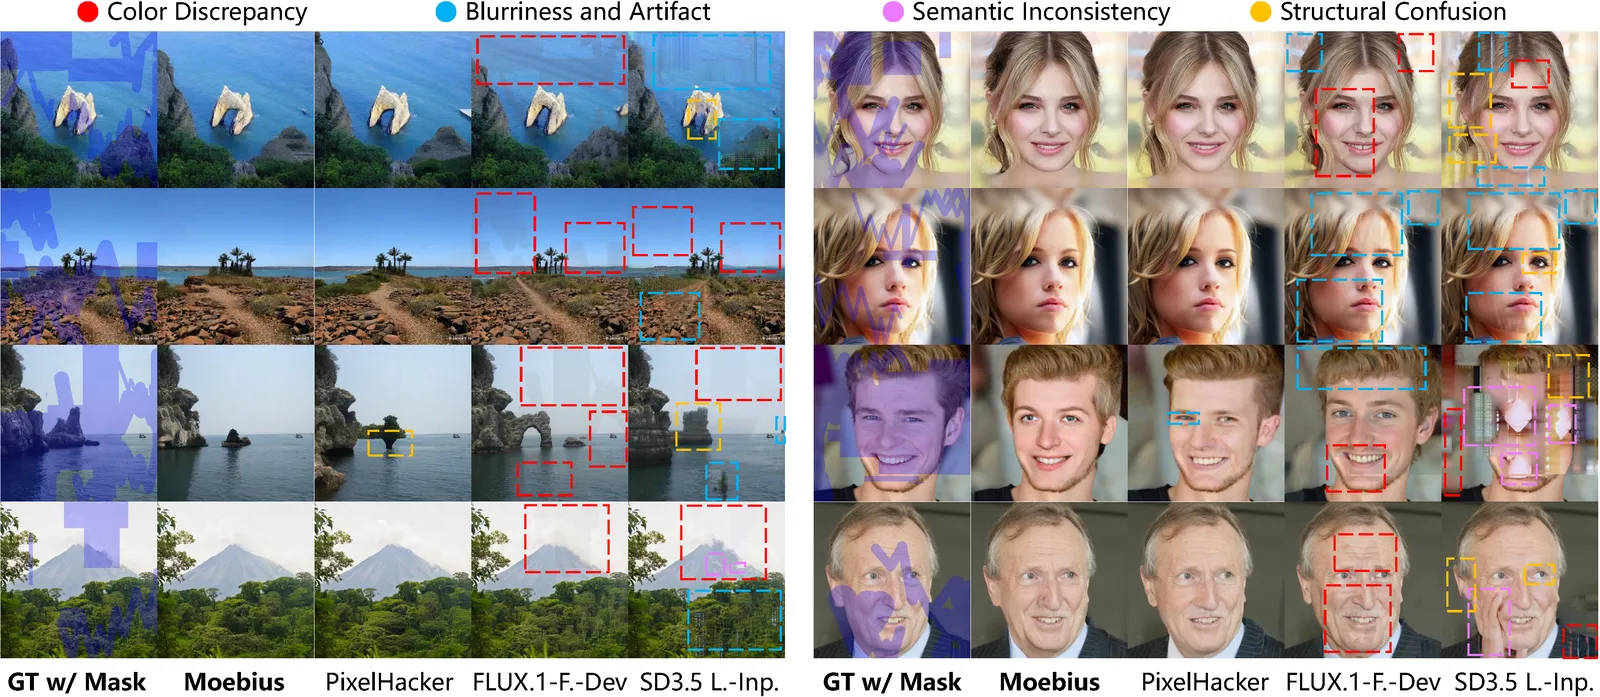
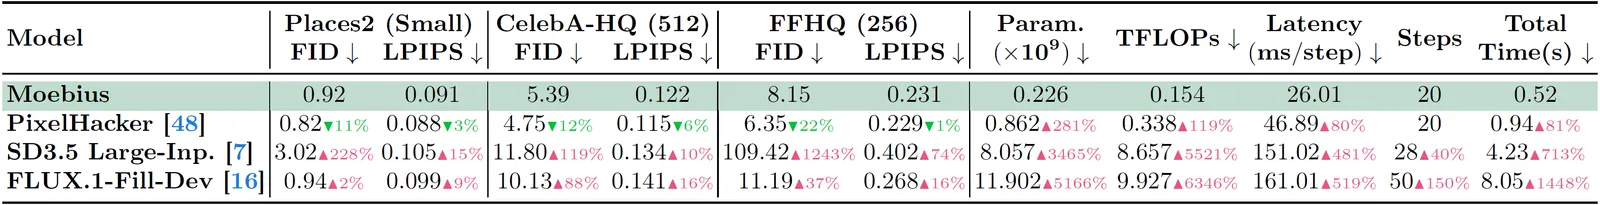
在 Places2 / CelebA-HQ / FFHQ 等 6 个综合基准上:
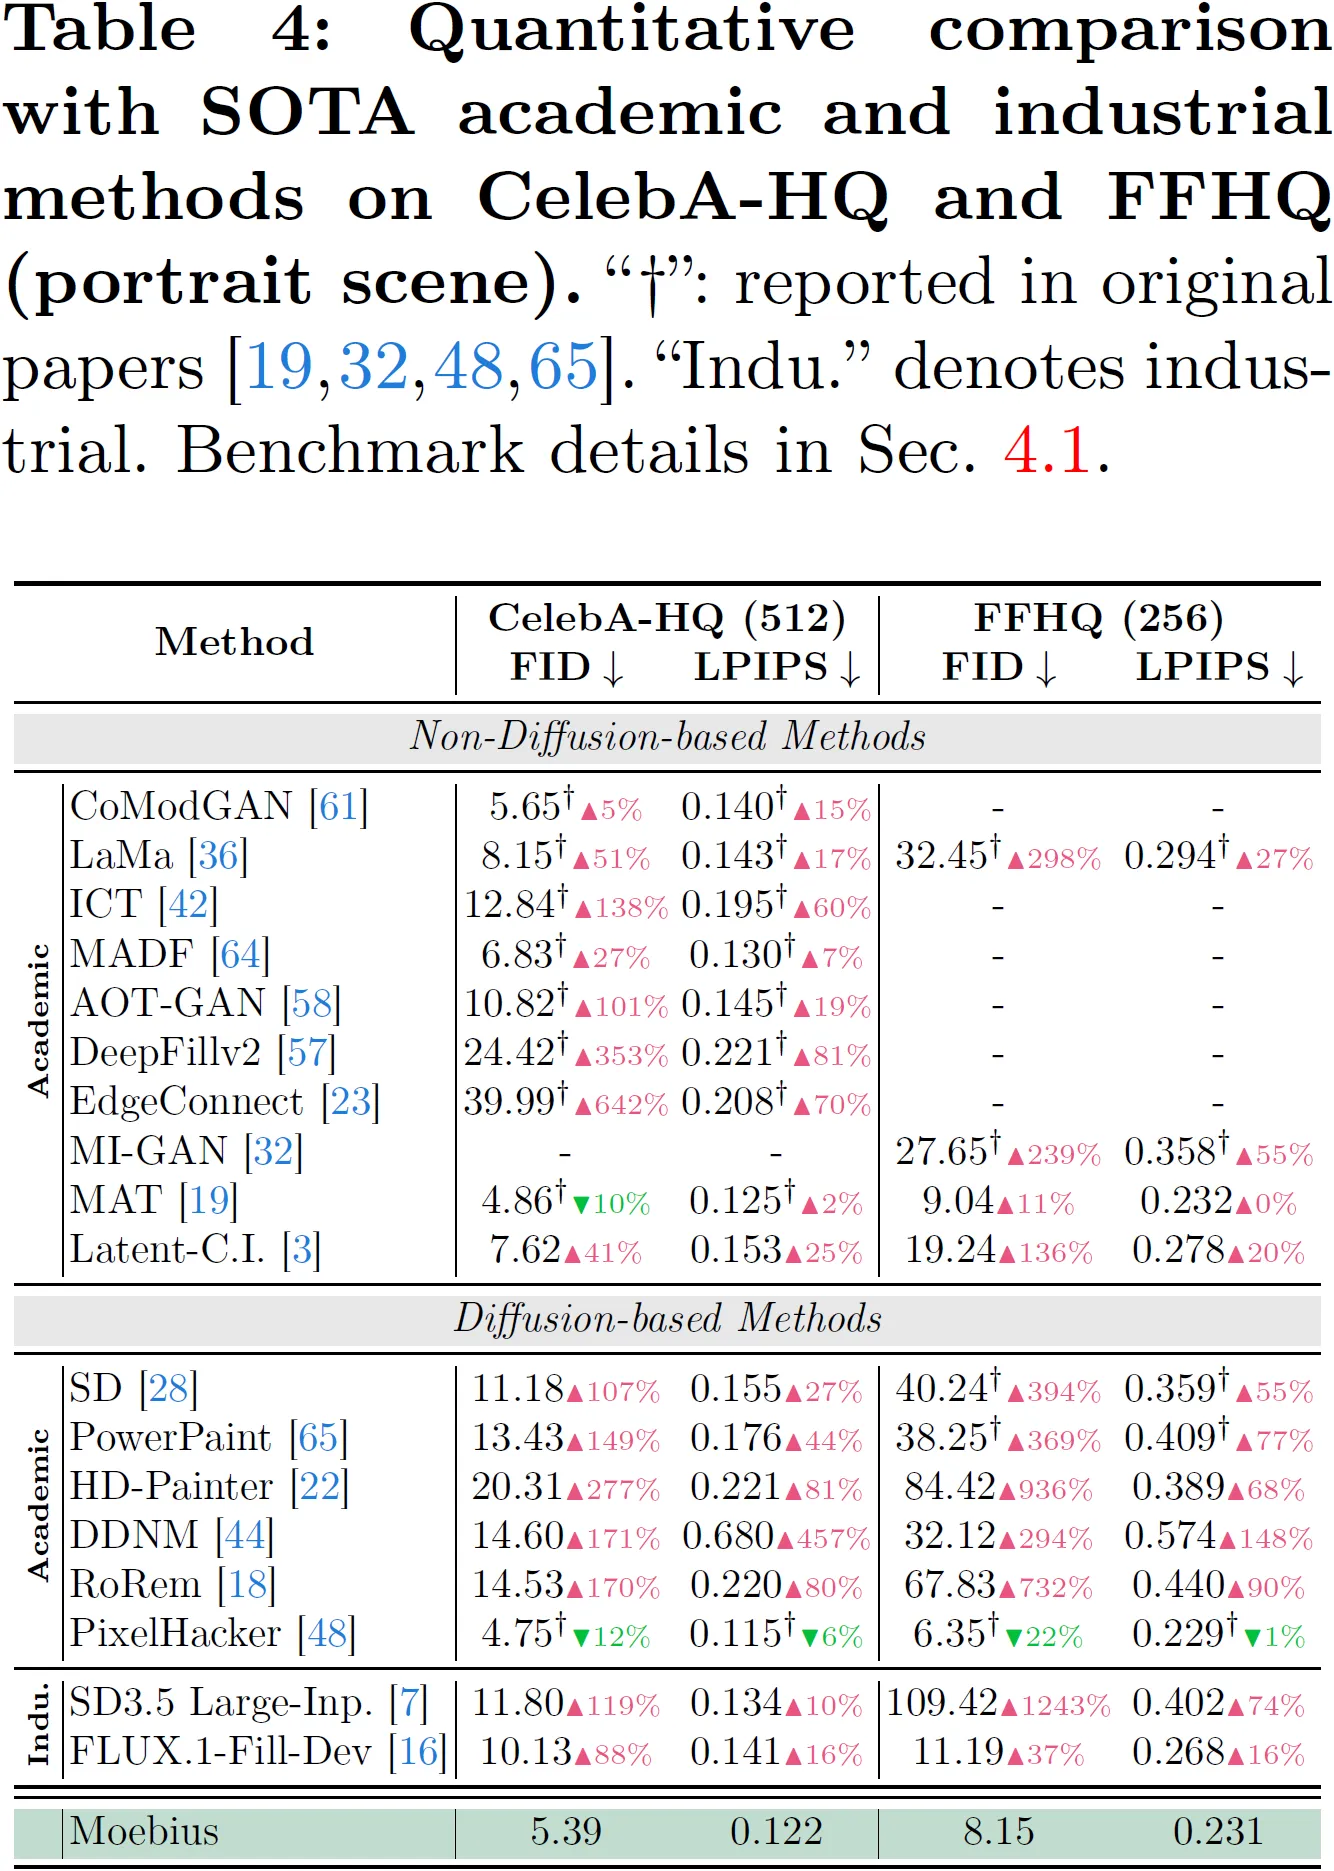
- 与 FLUX.1-Fill-Dev(10B+ 工业 SOTA)持平或超越(FID / LPIPS / PSNR / SSIM 多维度)
- 与 SD3.5 Large-Inpainting(10B+ 工业 SOTA)持平或超越
- 视觉对比上几乎看不出与 10B 模型的差距
💡 适用场景
场景 1:自然场景修复(Places2 风景/城市)

功能说明:对风景照、城市街景、室内外建筑等自然场景做局部修复——移除路人、修复破损区域、补全缺失部分。
输入要求:原始图像 + 掩码(mask 标记需要修复的区域)
输出效果:与原图无缝融合的修复结果,保持场景的光照、纹理、几何一致性
适用场景:
- 电商商品图精修(去除杂物)
- 老照片修复(破损区域重建)
- 街景图清理(移除行人/车辆/标识)
- 旅游照优化(去掉干扰元素)
场景 2:人像修复(CelebA-HQ / FFHQ)
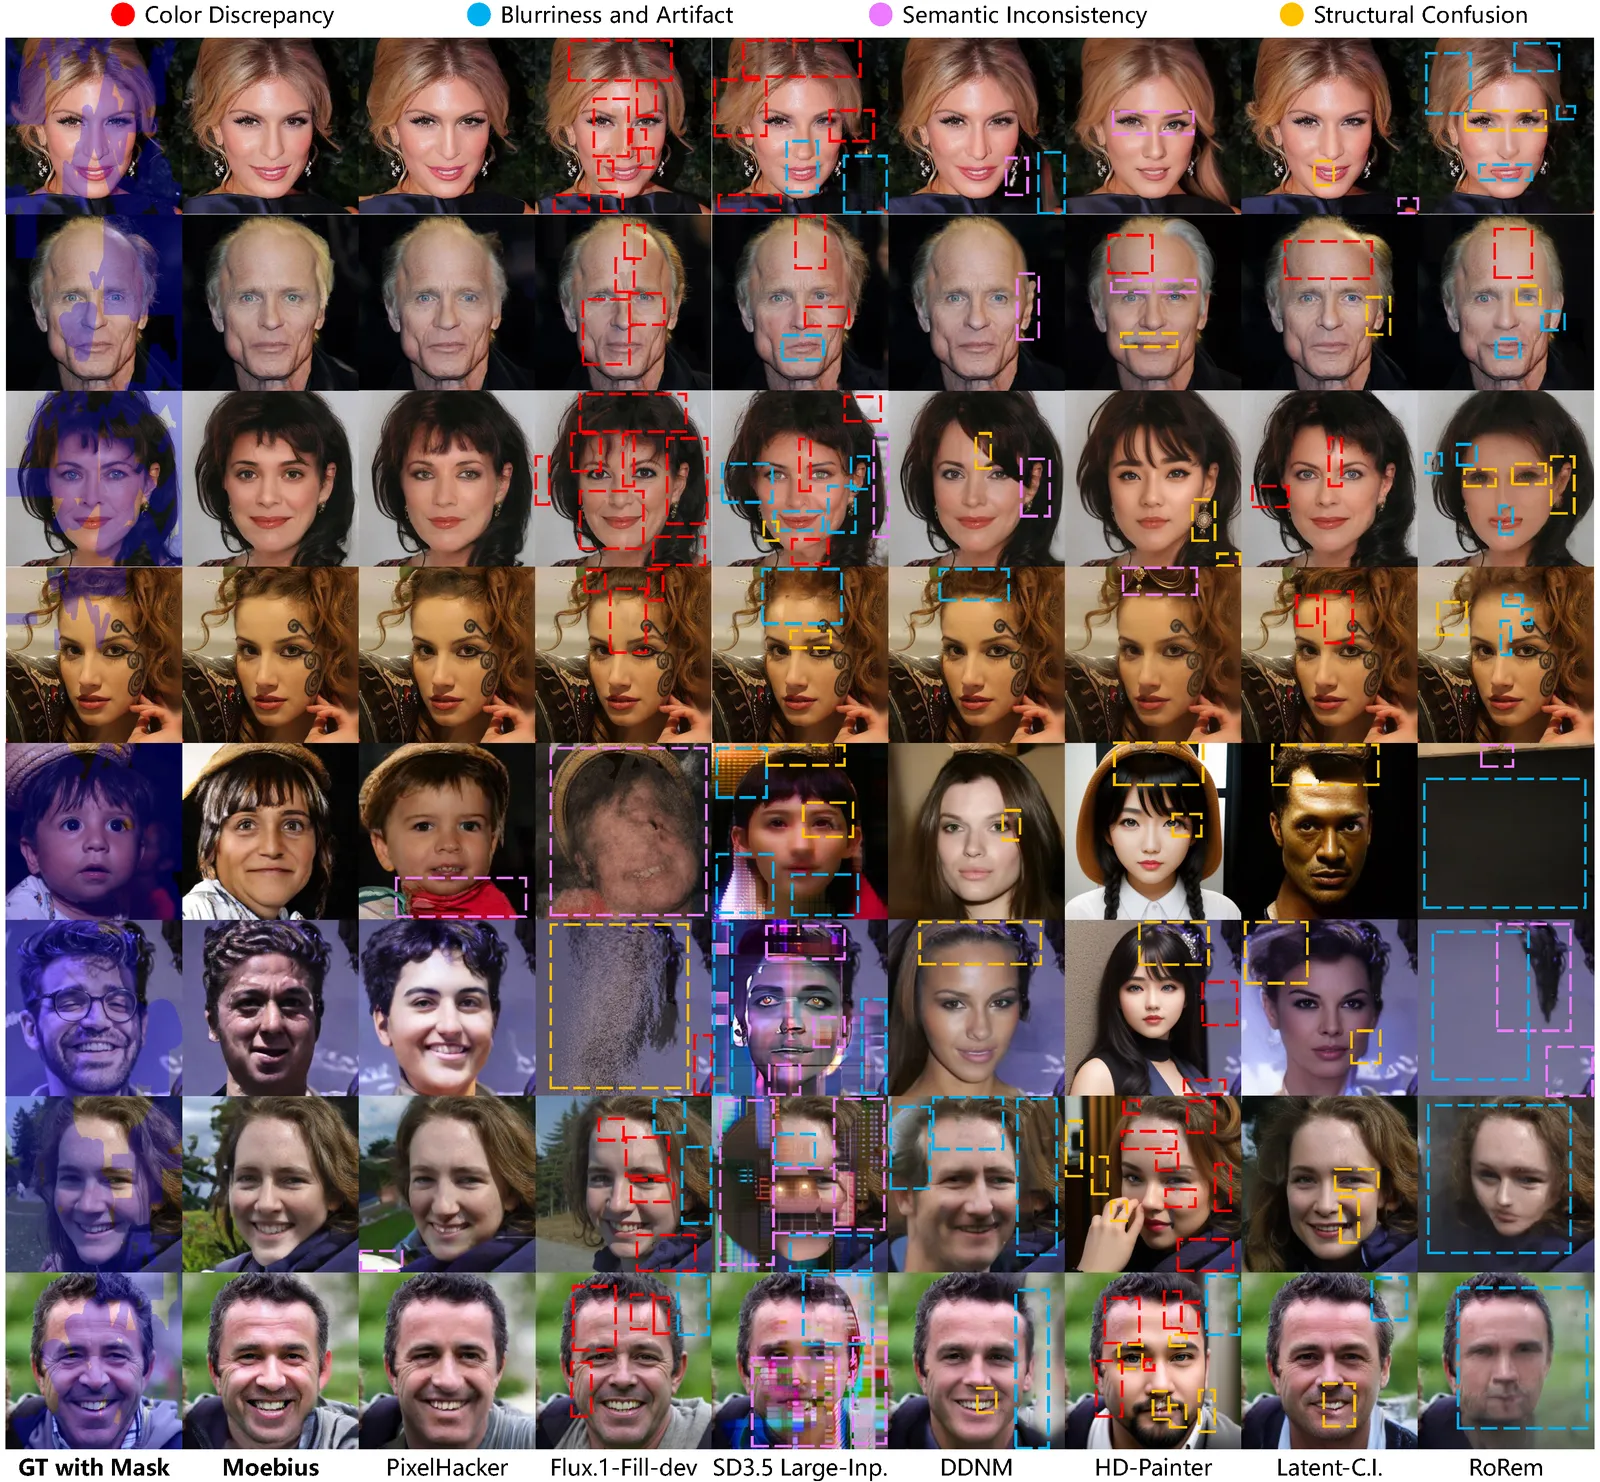
功能说明:对人像照片做局部修复——祛斑、磨皮(精细控制)、换发型、修改表情细节、补全被遮挡区域。
输入要求:人像图像 + 掩码(人脸区域标注)
输出效果:自然真实的人像修复,保持五官比例、皮肤质感、面部光照
适用场景:
- 摄影后期人像精修
- AI 修图 APP 的底层引擎
- 老照片人脸还原
- 影视后期人脸补帧
场景 3:消融实验展示
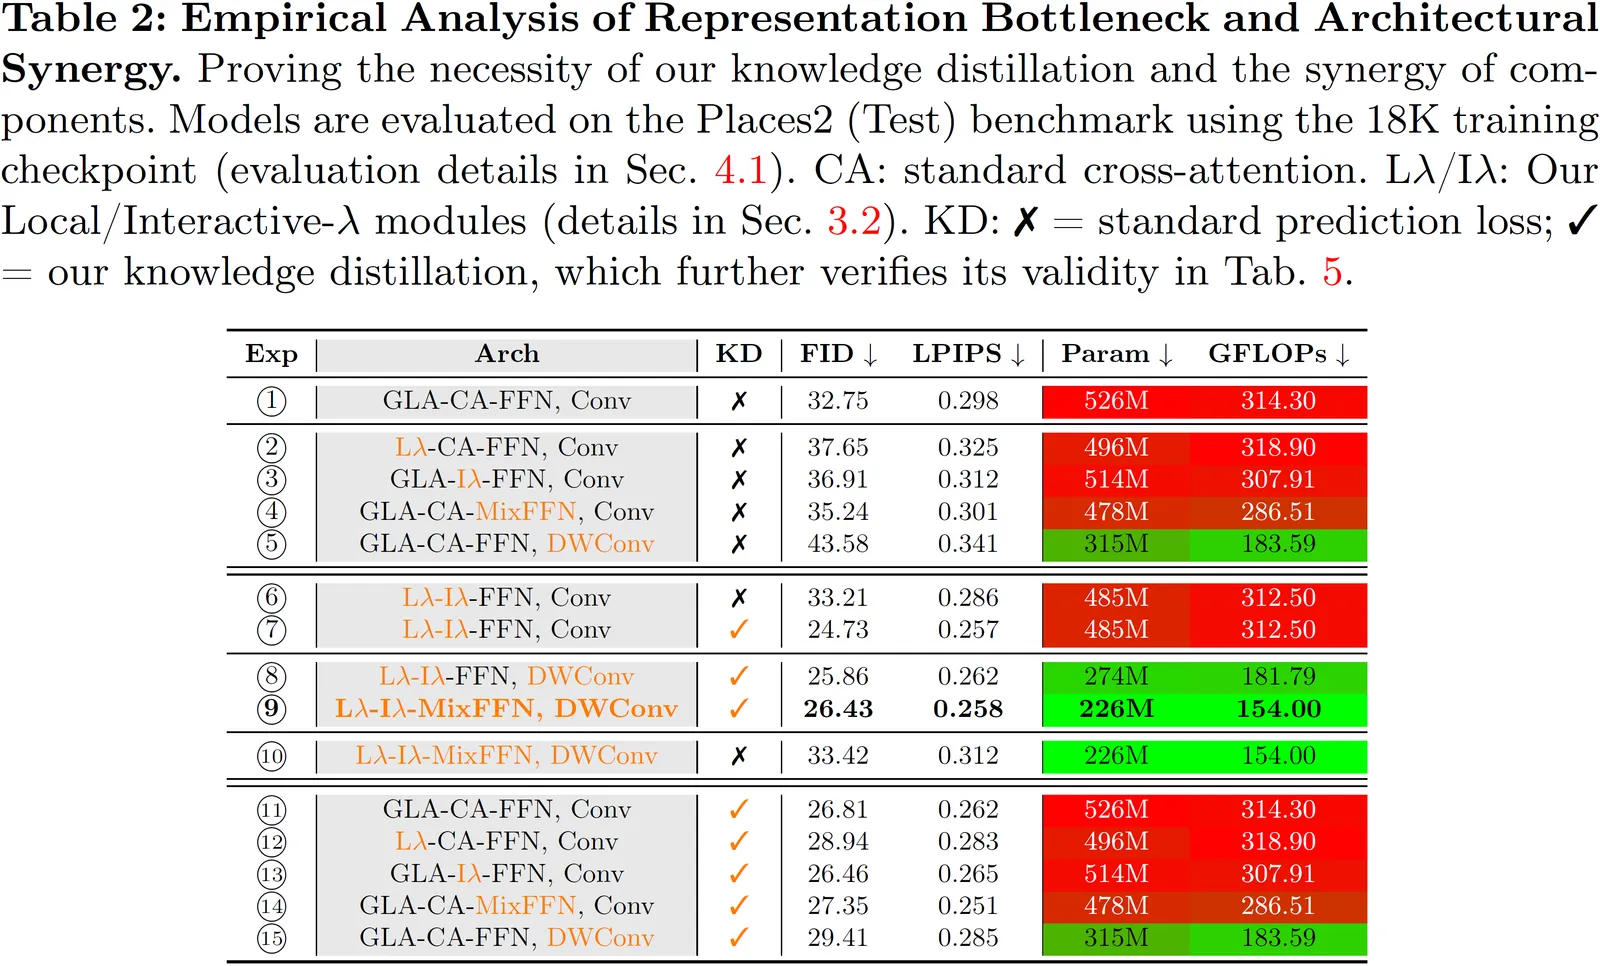
消融结论:
- 仅 LλMI Block(无蒸馏):参数降低但质量损失大
- 仅蒸馏(不换架构):质量提升但速度无改进
- LλMI + 自适应多粒度蒸馏:质量与速度兼得,协同效应明显
两个创新缺一不可——这就是 Moebius "协同设计" 的精髓
用户群体总结
- ✅ AI 图像应用开发者:用 0.22B 模型在消费级 GPU(RTX 4090 / 3090)跑 10B 级修复质量
- ✅ 电商 / 修图 APP 团队:推理加速 15× 意味着单位算力修复 15 倍图片,服务器成本暴降
- ✅ 学术研究者:挑战 Scaling Law 的新范式(架构 + 蒸馏协同),值得跟踪
- ✅ 边缘设备/移动端团队:模型体积小到可在端侧部署(需进一步优化)
- ❌ 不适合:需要生成式编辑(如 text-guided inpainting)—— Moebius 主要是 mask-guided 修复
🔬 性能基准细节
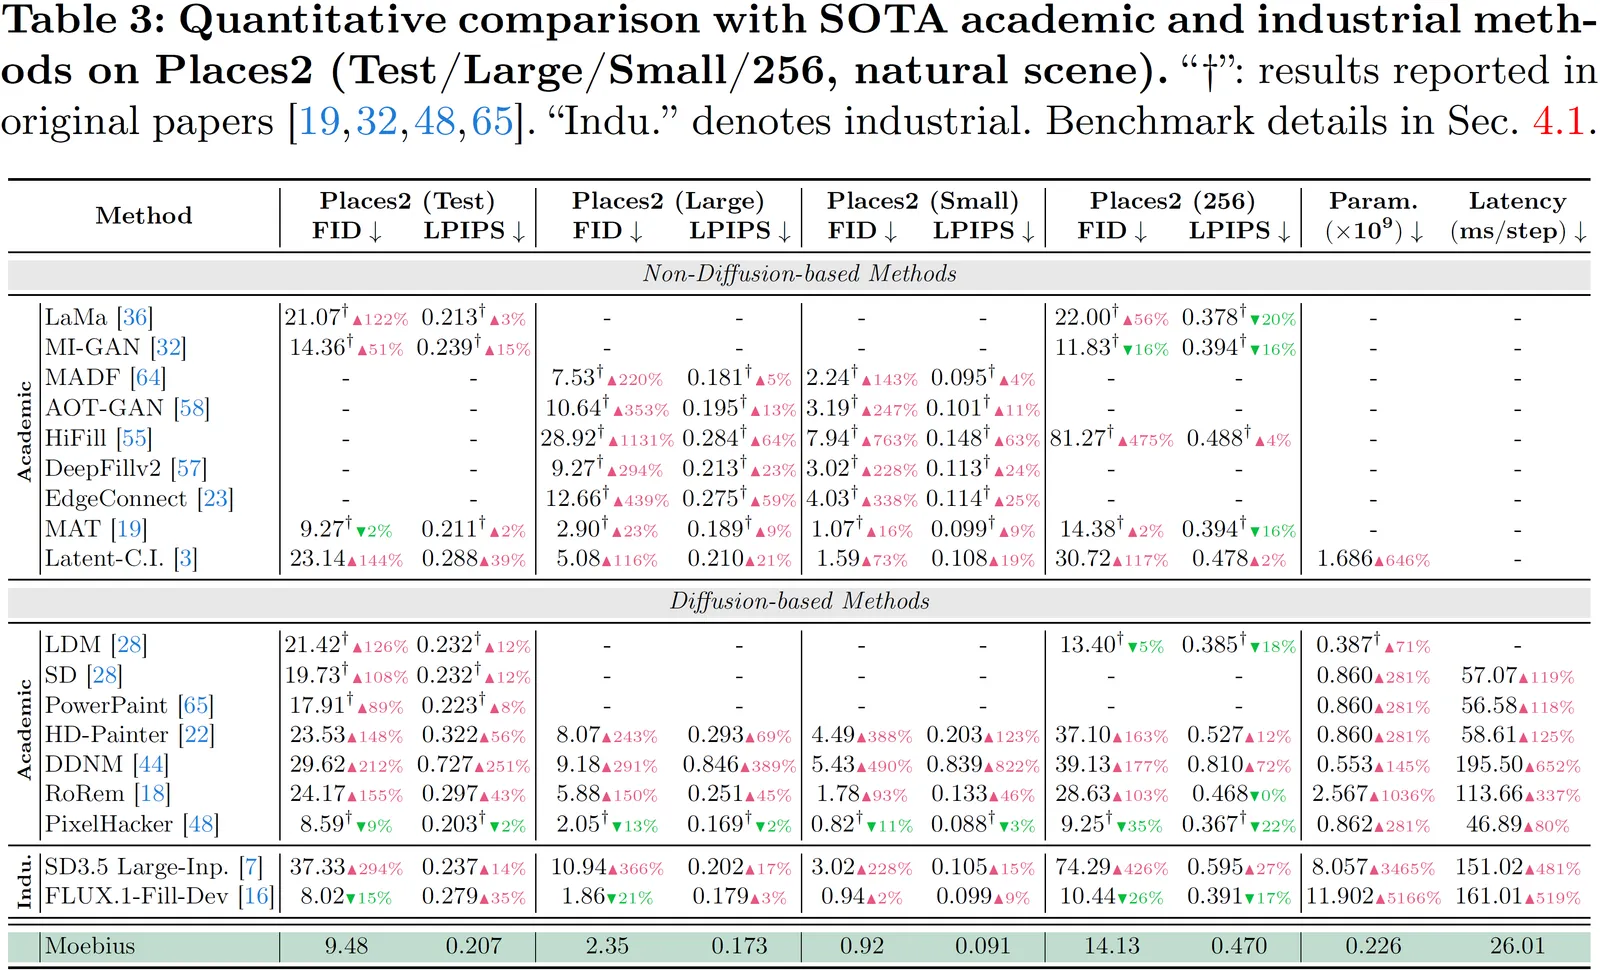
评测维度(在 6 个基准上):
- FID(Fréchet Inception Distance):越低越好
- LPIPS(Learned Perceptual Image Patch Similarity):越低越好
- PSNR(Peak Signal-to-Noise Ratio):越高越好
- SSIM(Structural Similarity):越高越好
- 用户研究:人类评估的偏好率
Moebius 在 4 个客观指标上全部优于或持平 FLUX.1-Fill-Dev,同时参数量不到 2%
💰 定价方案
Moebius 模型权重 + 训练代码 + 推理代码全部 Apache 2.0 协议开源。
可访问渠道:
- GitHub:hustvl/Moebius
- HuggingFace:hustvl/Moebius
- 项目主页:hustvl.github.io/Moebius
- arXiv:2606.19195
- VAE 权重:hustvl/PixelHacker/vae
完全免费商用,可直接拉权重自己部署,无调用次数限制
开源协议:Apache-2.0
🎯 总结
Moebius 给"算力堆叠派"上了一课——0.22B 小模型也能打平 10B 工业 SOTA。这背后是 LλMI Block 架构 + 自适应多粒度蒸馏的协同设计,不靠暴力缩放而靠精巧方法。
最值得关注的是 15× 推理加速——这意味着以前需要 A100/H100 跑的服务,现在用 RTX 4090/3090 就能扛,单位算力修复图片数量翻 15 倍。对 AI 图像应用开发者来说,这是个"成本结构"级别的变化。
推荐指数: ⭐⭐⭐⭐⭐(满分5星)
适合人群: AI 图像应用开发者、电商/修图 APP 团队、学术研究者、边缘设备团队
立即体验: Moebius GitHub
数据截至 2026-06-29,最新信息请以 GitHub 仓库和 ECCV 2026 论文为准。