🔥【今日推荐 Memori】:给 AI Agent 装上永久记忆,Token 消耗降 20 倍!
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../Memori-recommend.pptx../../Memori-recommend.mp4本文目录
🔥【今日推荐 Memori】:给 AI Agent 装上永久记忆,Token 消耗降 20 倍!
Agent 每次对话都失忆?Memori 把 Agent 执行过程和对话转成结构化持久状态,13K+ Stars,LLM 无关,即插即用。
🚀 什么是 Memori?
Memori 是一套 Agent 原生记忆基础设施,由 Memori Labs 开源。它解决的问题非常明确:现有的 AI Agent 每次对话都"失忆",要么靠超长上下文硬撑(Token 烧钱),要么靠简单的向量检索(召回不准)。
Memori 的做法是:把 Agent 的执行过程和对话内容结构化存储为持久状态,像一个专门为 Agent 设计的内存数据库,支持任意 LLM、任意数据存储后端、任意 Agent 框架。


核心定位:Agent 的"海马体"——把短期对话变成长期记忆,支持毫秒级召回,无需修改现有代码!
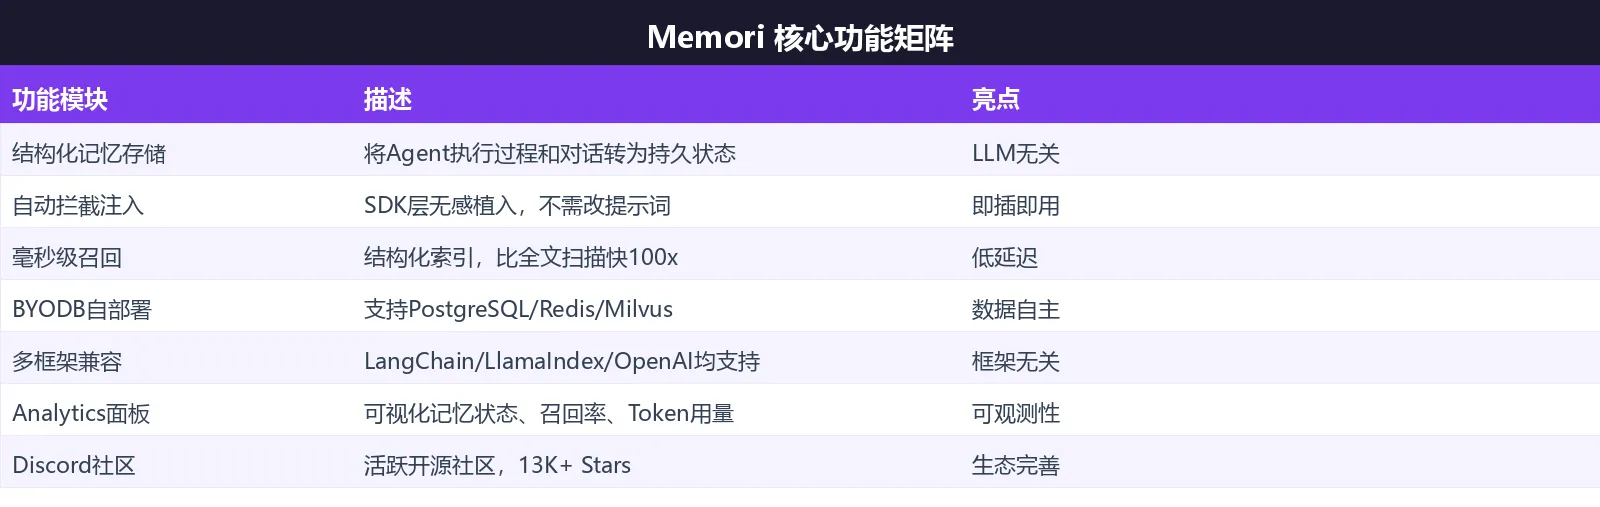
✨ 核心功能一览
🛠️ 快速上手
安装(Python / TypeScript 双 SDK)
# Python SDK
pip install memori

# TypeScript SDK
npm install @memorilabs/memori
30 秒接入现有 OpenAI 代码
from memori import Memori
from openai import OpenAI

# 设置环境变量:MEMORI_API_KEY + OPENAI_API_KEY
client = OpenAI()
mem = Memori().llm.register(client)

# 给这个用户/会话打个标签(attribution)
mem.attribution(entity_id="user_123", process_id="support_agent")

# 第一次对话:告诉 AI 你的偏好
response = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "My favorite color is blue."}]
)
# → Memori 在后台自动持久化这段对话

# 第二次对话(可以是几天后、另一个会话)
response = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[{"role": "user", "content": "What's my favorite color?"}]
)
# → Memori 自动召回历史记忆,AI 回答 "Blue"
重点:你不需要改任何提示词、不需要手动管理 Memory、不需要在 prompt 里塞历史记录——Memori 在 SDK 层面自动拦截 LLM 调用,无感植入记忆能力。
📊 LoCoMo 基准测试 —— 行业最强
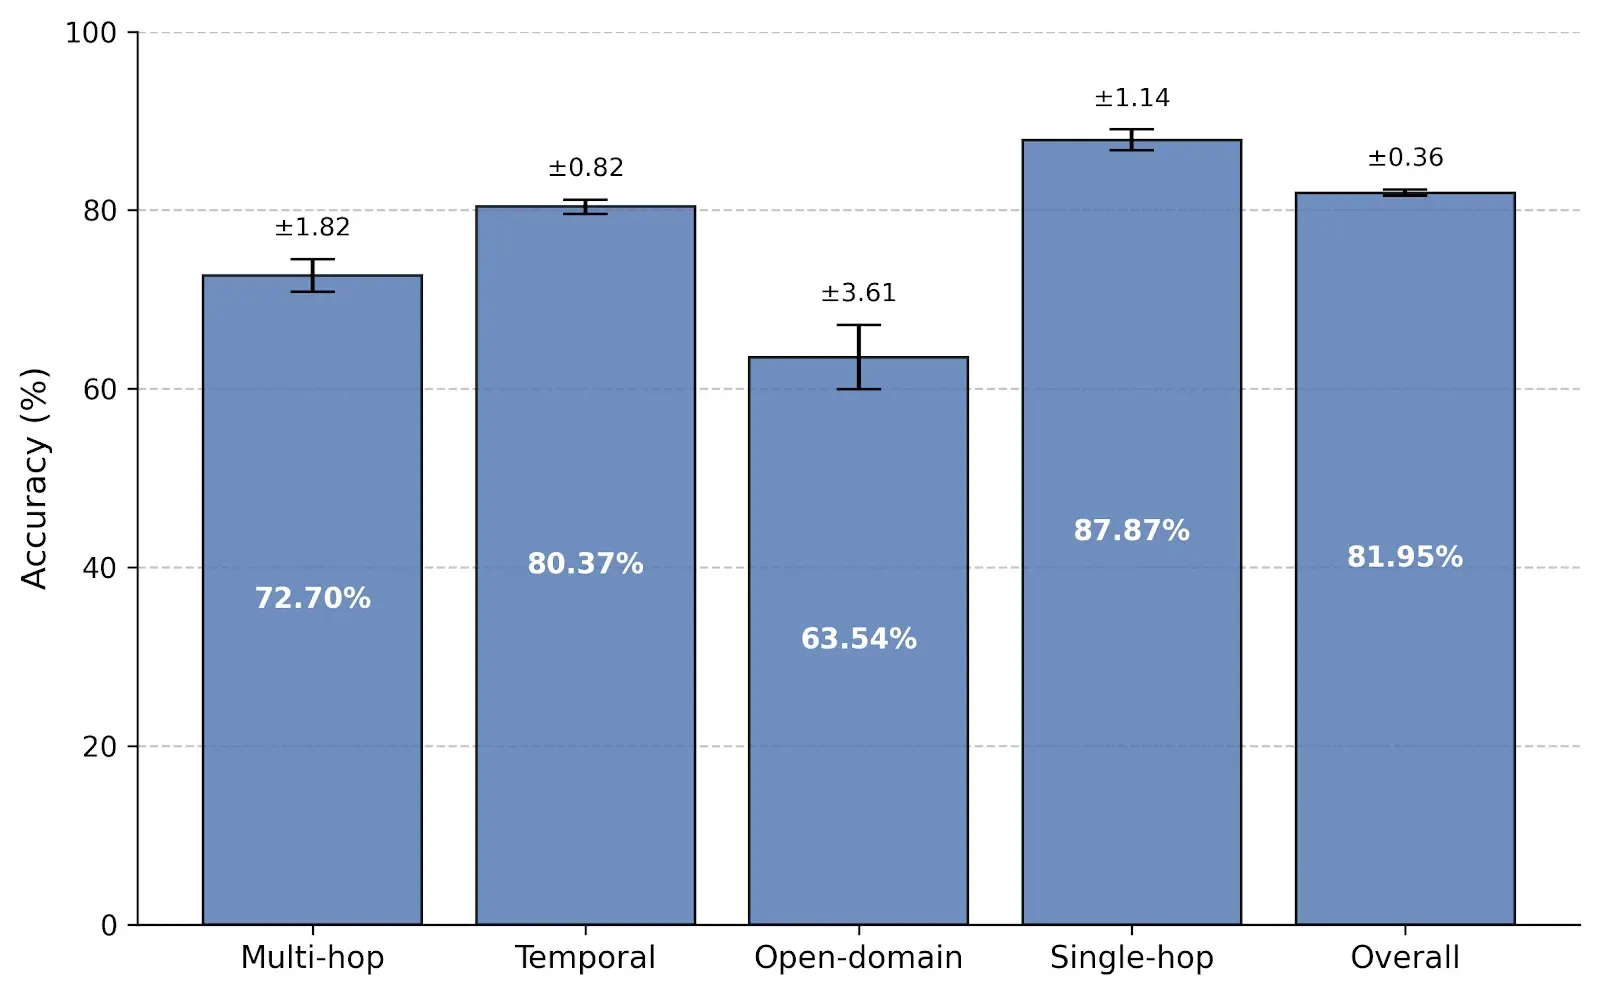
Memori 在学术界公认的 LoCoMo 长对话记忆基准测试 中取得了压倒性成绩:
| 指标 | Memori | 全文上下文(Full-context) | Zep | LangMem | Mem0 |
|---|---|---|---|---|---|
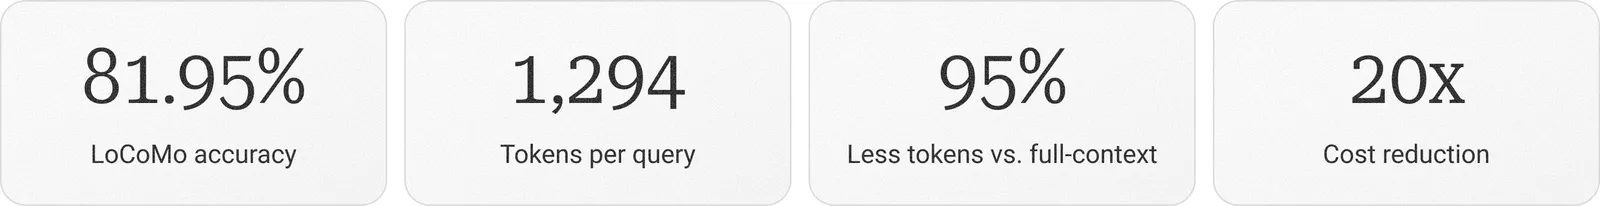
| 整体准确率 | 81.95% | ~75% | ~68% | ~65% | ~70% |
| Token 消耗 | 1,294 / query | ~26,000 / query | ~4,000 / query | ~3,500 / query | ~3,000 / query |
| 相对全文上下文 | 仅 4.97% | 100% | ~15% | ~13% | ~12% |
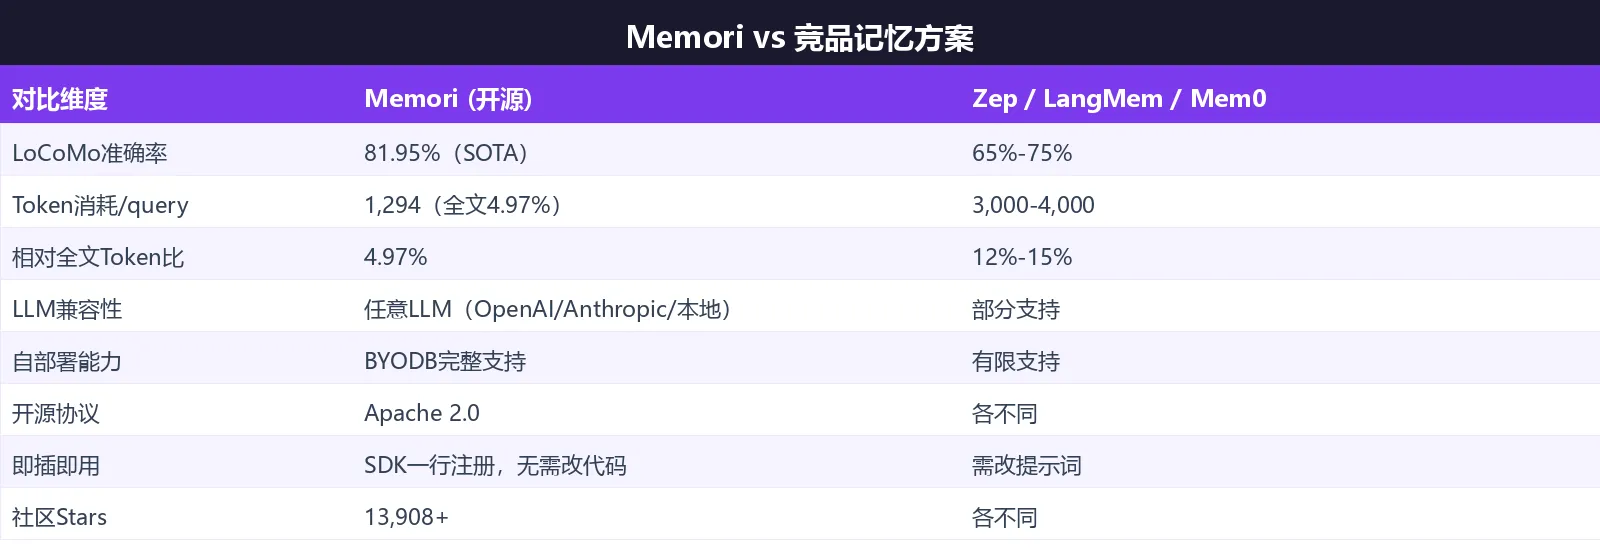
核心数字:用仅仅 4.97% 的 Token 消耗,达到了超越全文上下文的准确率!相比 Zep,Token 减少 67%;相比全文硬撑,成本降低 20 倍以上。
💡 适用场景
场景一:客服 Agent 记住用户历史问题
功能说明:将每次客服对话结构化存储,下次用户再来时,Agent 自动知道历史问题和偏好,无需用户重复描述。
输入要求:接入 Memori SDK,设置 entity_id(用户唯一标识)。
输出效果:
- Agent 自动召回历史工单和对话
- 个性化回复(记住用户偏好设置)
- 多轮对话连贯性大幅提升
适用场景:
- 在线客服机器人(电商、SaaS 支持)
- 企业内部 Helpdesk Agent
- 医疗预问诊 Agent(记住患者历史)
场景二:个人 AI 助理的跨会话记忆
功能说明:让个人 AI 助理记住你的偏好、日程、工作习惯,跨越数天/数周依然"认识你"。
输入要求:在初始化时设置用户的 entity_id。
输出效果:
- "帮我安排明天会议" → Agent 记得你的工作时间偏好
- "继续上次的报告" → Agent 知道上次写到哪里
- "推荐类似的书" → Agent 记得你最近读过的书
适用场景:
- 个人效率 AI 助理
- 写作/编程 Copilot 的长期上下文
- 健康管理 Agent(记住病史和用药)
场景三:多 Agent 协作的共享记忆
功能说明:多个 Agent 共享同一块记忆空间,A Agent 的见闻可以被 B Agent 直接利用。
输入要求:多个 Agent 使用同一个 entity_id 或关联 ID。
输出效果:
- 研究 Agent 找到的论文 → 写作 Agent 直接引用
- 数据 Agent 清洗的结果 → 分析 Agent 直接使用
- 所有 Agent 的动作都被审计追踪
适用场景:
- 企业级多 Agent 自动化流水线
- AI 研究团队的多模型协作
- RAG + Agent 混合系统
场景四:自部署模式(数据不出内网)
功能说明:Memori 支持 BYODB(Bring Your Own Database),可以用自己的 PostgreSQL / Redis / Milvus 作为存储后端,数据完全不离开自己的 VPC。
适用场景:
- 金融/医疗等数据合规行业
- 大型企业内网部署
- 对数据主权有严格要求的场景
用户群体总结
- ✅ AI Agent 开发者:即插即用,无需自己造记忆模块
- ✅ SaaS 产品经理:提升 AI 功能用户体验(记住用户偏好)
- ✅ 企业 AI 团队:BYODB 模式满足数据合规
- ✅ 个人开发者:Cloud 模式免费额度足够个人项目
- ❌ 不适合:不需要记忆能力的单次调用场景(如简单翻译)
🆚 与竞品对比
💰 定价方案
| 方案 | 价格 | 适合人群 |
|---|---|---|
| Memori Cloud 免费版 | 免费(有额度限制) | 个人项目 / 快速验证 |
| Memori Cloud Pro | 按量计费(详见官网) | 生产环境 |
| BYODB 自部署 | 开源免费(需自己维护 DB) | 企业 / 合规场景 |
开源协议: Apache 2.0
💡 新手福利:Memori Cloud 有免费额度,注册即用,无需信用卡;BYODB 模式完全开源,数据自己管!**
🎯 总结
Memori 解决了 AI Agent 领域一个长期被忽视但极其关键的问题:如何让 Agent 拥有可靠、高效、低成本的长期记忆。其 LoCoMo 基准测试成绩(81.95% 准确率 + 仅 4.97% Token 消耗)证明了结构化记忆路线远优于"全文硬塞上下文"和"简单向量检索"两条老路。
对于正在构建 AI Agent 的开发者来说,Memori 是目前开源方案中最成熟的选择。
推荐指数: ⭐⭐⭐⭐⭐(满分5星)
适合人群: AI Agent 开发者、SaaS 产品团队、需要长期记忆能力的 LLM 应用 builder
立即体验: Memori Cloud 注册
GitHub 仓库: MemoriLabs/Memori
数据截至 2026 年 4 月 27 日,最新信息请以官网为准。