MeMo
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../MeMo-recommend.pptx../../MeMo-recommend.mp4本文目录
📌 核心价值:MIT 团队把"长期记忆"从向量库外挂,推进为可训练、可替换、与基础模型解耦的记忆模型 — 1.5B 小模型就能扛起整个语料库
一句话:在不重训、不检索、不动基座权重的前提下,把新知识注入任意 LLM,推理成本与语料库大小无关。
🚀 什么是 MeMo?
2026 年 5 月 14 日,arXiv 上线了一篇编号为 2605.15156 的论文 "MeMo: Memory as a Model",作者来自 MIT CSAIL、National University of Singapore、DSO National Laboratories 等机构,其中 Daniela Rus 和 Armando Solar-Lezama 两位 MIT 教授挂帅。这个项目瞄准了一个长期困扰 LLM 应用落地的核心痛点——
基础模型不能每天重训,但业务知识、产品文档、内部数据每天都在变。
现有的三条路都有硬伤:
- RAG(检索增强):对检索噪声极度敏感,跨文档推理能力弱,加 1× 干扰文档准确率直接掉 6.22%
- 微调(Fine-tuning):贵到爆,还会触发灾难性遗忘
- 潜在记忆(Latent Memory):跟产生它的模型强耦合,换个基座就失效
MeMo 给出了第四条路:把"记忆"也训练成一个模型。一个 1.5B-14B 的小模型承担整个语料库的"参数化记忆",推理时由冻结的大模型(Executive Model)按结构化三阶段协议去查询它。最妙的是 —— 推理成本跟语料库大小无关,因为记忆是写在参数里、不是写在向量库里。


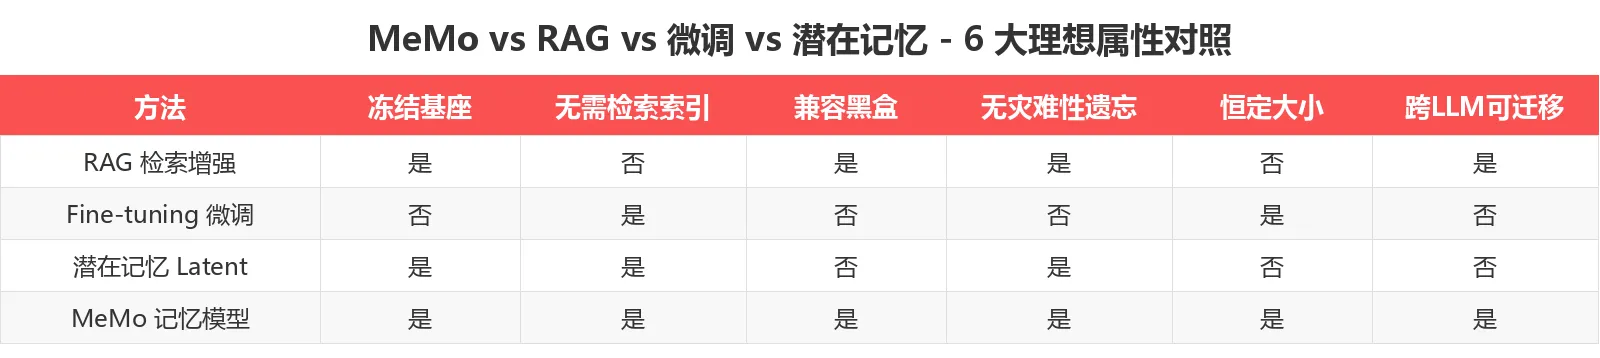
核心定位:这是第一个把记忆模块化成"独立小模型"的工作,零灾难性遗忘、即插即用闭源 LLM、推理成本与语料库解耦。
🧠 它解决了什么问题?
要理解 MeMo 的价值,先看现有方案的天花板:
| 痛点 | RAG | 微调 | 潜在记忆 | MeMo |
|---|---|---|---|---|
| 检索噪声鲁棒性 | 极差(−6.22%) | 不涉及 | 一般 | 反而 +0.55% |
| 跨文档推理 | 弱 | 强 | 中等 | 强 |
| 灾难性遗忘 | 无 | 严重 | 无 | 无 |
| 黑盒 LLM 兼容 | 是 | 否 | 否 | 是 |
| 恒定大小记忆 | 否(向量库膨胀) | 是 | 否(随模型变) | 是 |
| 跨 LLM 迁移 | 是 | 否 | 否 | 是 |
把这六个维度同时打勾,目前只有 MeMo 一家。
🔬 核心方法:把"知识"和"推理"分到两个模型
MeMo 的架构只有两个角色:
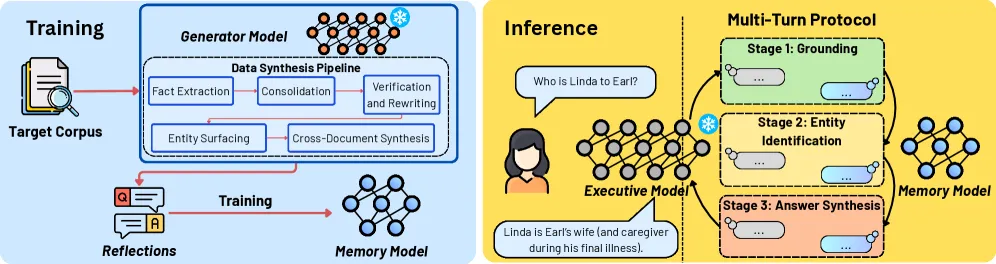
1. Executive Model(EM,执行模型)
- 任意冻结的强 LLM(开源或闭源都行)
- 论文里用了 Qwen2.5-32B-Instruct(开源)和 Gemini-3-Flash(闭源)
- 职责:把复杂查询拆成原子化子问题,最后综合成答案
2. Memory Model(MEM,记忆模型)
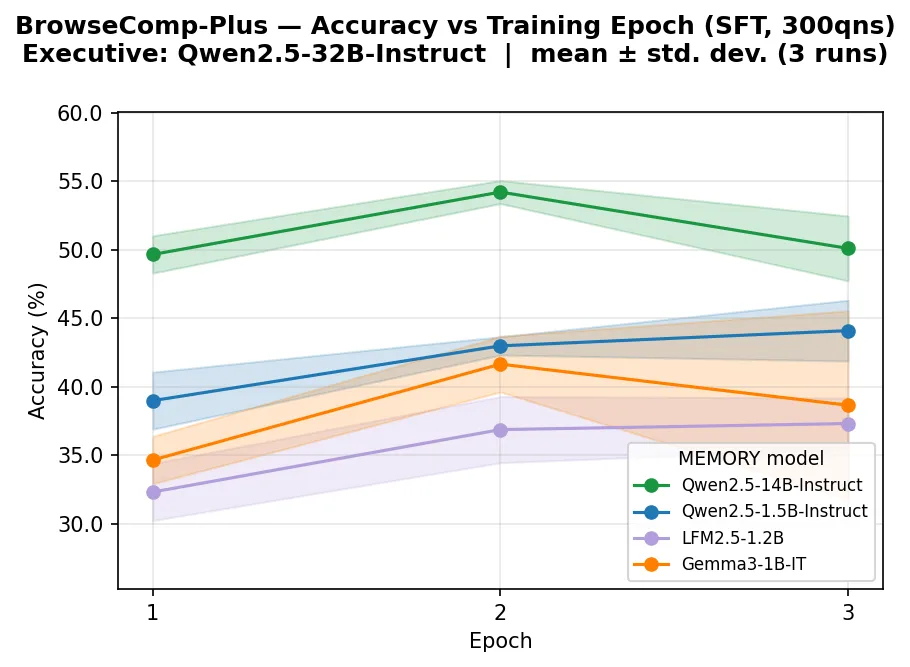
- 一个紧凑的 1.5B-14B 模型
- 参数里编码了整个目标语料库(不需要外挂向量库)
- 推理时不接触源文档,直接靠"参数化记忆"回答子查询
这意味着:你训一次 MEM,就能把它接到任何 Executive Model 上。论文里用 14B Qwen 训 MEM,推理时换成 Gemini-3-Flash 当 EM,性能直接 +27 个百分点。
🛠️ 训练管线:5 步把语料烧进 MEM
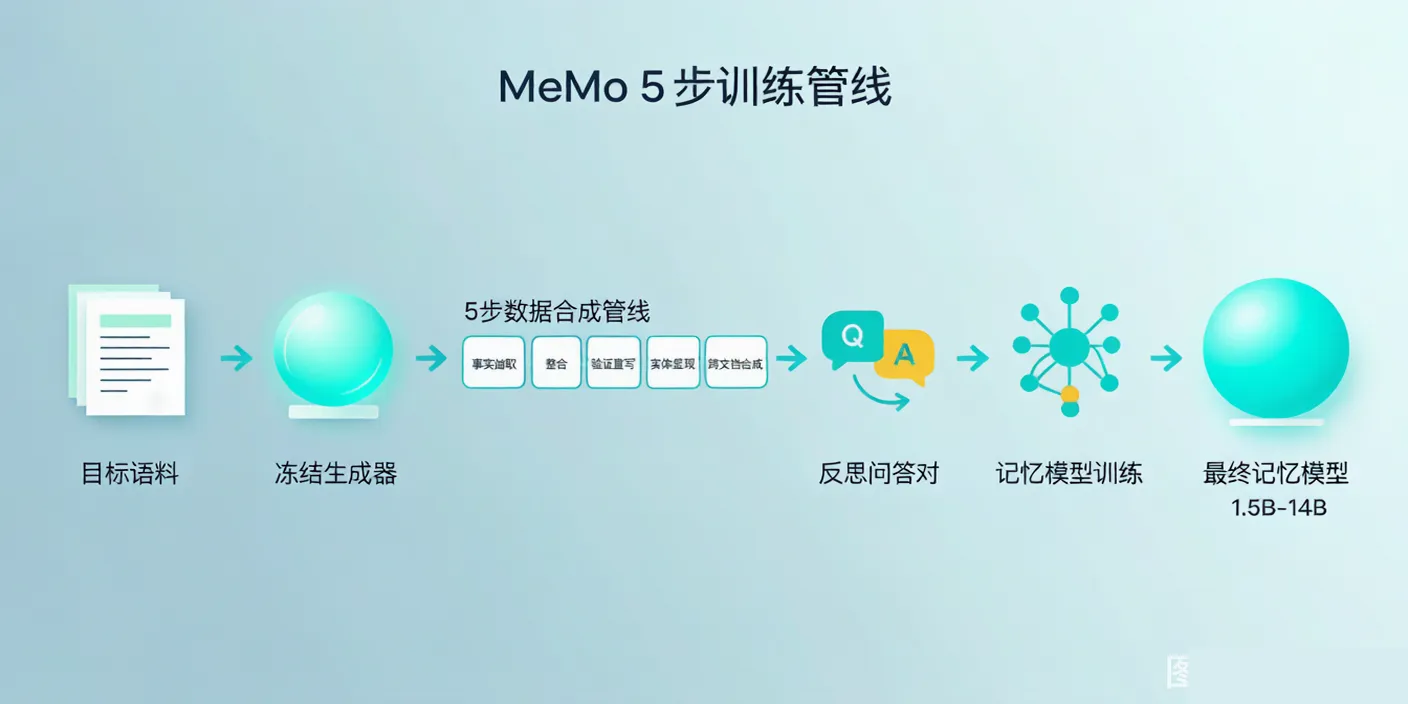
| 步骤 | 名称 | 作用 |
|---|---|---|
| 1 | 事实抽取 Fact Extraction | 从目标语料里挖出关键事实 |
| 2 | 整合 Consolidation | 把多文档的事实合并去重 |
| 3 | 验证重写 Verification and Rewriting | 检查事实一致性,过滤幻觉 |
| 4 | 实体显现 Entity Surfacing | 显式建立实体-关系图 |
| 5 | 跨文档合成 Cross-Document Synthesis | 生成"反思型" Q&A 对作为 SFT 数据 |
整个流程不依赖基座模型的梯度,完全离线跑完,得到一个 reflection QA 数据集,最后用标准 SFT(全量或 LoRA)+ DeepSpeed ZeRO-2 训练 MEM 即可。
# 完整复现脚本(仓库根目录)
# Stage 1: 数据准备
python data_processing_utils/preprocess.py --dataset bcp

# Stage 2: 5 步合成
bash data_synthesis_pipeline/datasynth_pipeline/run_bcp.sh

# Stage 3: SFT 训练(支持 LoRA)
python sft_training/train.py \
    --model_name Qwen2.5-14B-Instruct \
    --dataset_path ./data/bcp_synth \
    --use_lora True \
    --output_dir ./checkpoints/mem_bcp_14b
关键设计:合成阶段的"生成器"也是冻结的,意味着你可以在自己的私有语料上,直接复用公开的 32B Qwen 当生成器,完全不动它。
🎯 推理协议:三阶段结构化多轮对话
EM 和 MEM 之间不是"一锤子买卖",而是按结构化三阶段协议通信:
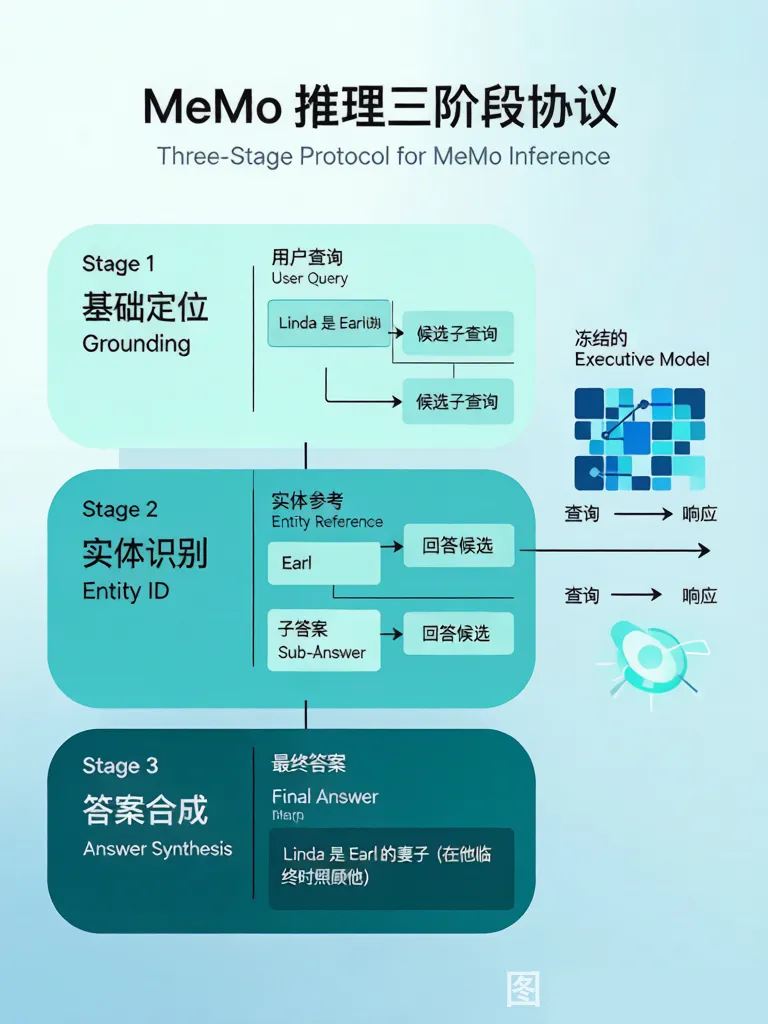
| 阶段 | 名称 | 干啥的 |
|---|---|---|
| Stage 1 | Grounding 基础定位 | EM 把查询拆成候选子查询发给 MEM |
| Stage 2 | Entity ID 实体识别 | MEM 反馈涉及到的实体和中间答案 |
| Stage 3 | Answer Synthesis 答案合成 | EM 拿到所有中间响应,综合出最终答案 |
论文里给了一个具体例子(来自 NarrativeQA):
用户查询:Linda 是 Earl 的谁? Stage 1 子查询:Earl 这个人物出现了哪些段落?他的家庭成员? Stage 2 实体反馈:Earl 的妻子 Linda;Earl 病重时的看护者 Stage 3 最终答案:Linda 是 Earl 的妻子(在他临终时照顾他)
这套协议让 EM 不用直接读源文档,只跟 MEM "对对话"就能拿到答案。
📊 实验结果:3 个基准全面碾压
论文在 BrowseComp-Plus、 NarrativeQA、 MuSiQue 三个知识密集型基准上做了完整实验:
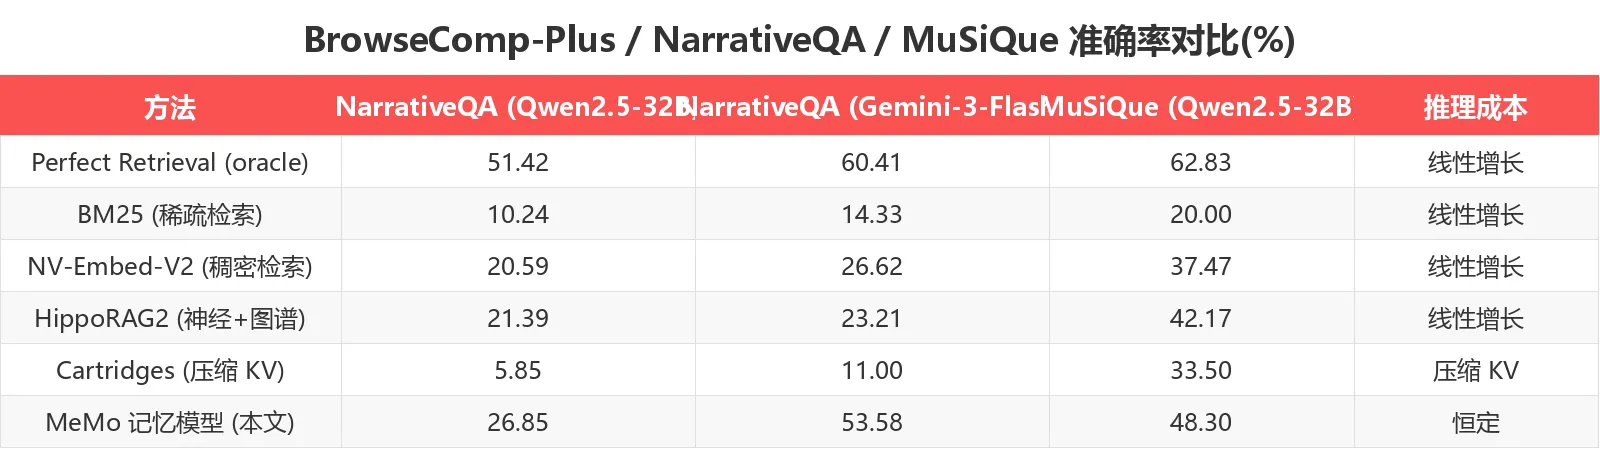
亮点 1:NarrativeQA 提升 +27 分
当 Executive Model 从开源的 Qwen2.5-32B 切换到闭源的 Gemini-3-Flash 时,MeMo 的 NarrativeQA 准确率从 26.85% 飙升到 53.58%,比所有检索基线(NV-Embed-V2、HippoRAG2)都高出一大截,甚至接近 Oracle(完美检索)的 60.41%。
这说明:MEM 的"参数化记忆"是模型无关的,闭源 EM 越强,MEM 给出的中间答案被综合得越好。
亮点 2:检索噪声鲁棒性
论文做了对抗性消融:往语料库里塞 1× 干扰文档。结果:
- NV-Embed-V2:BrowseComp-Plus 准确率从 57.00% 跌到 50.78%
- HippoRAG2:从 66.33% 跌到 60.11%
- MeMo:从 66.67% 反而升到 67.22%(+0.55%)
为什么会这样?因为 MEM 把整个语料"内化"进了参数,根本不需要外部检索,自然不受检索噪声影响。
亮点 3:5.5× 计算节省
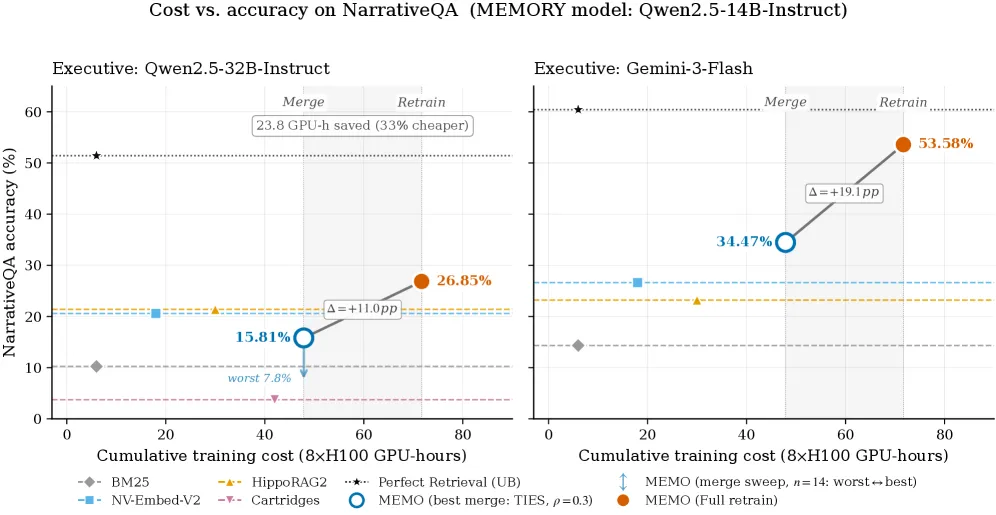
论文还展示了 模型合并(Model Merging)的玩法:当你新增一个语料 K=10 时,不用对全部 10 个语料重训一个 MEM,只需要训练第 10 个 MEM,然后用 TIES / DARE / SLERP 等参数空间合并方法把它跟之前的 9 个 MEM 合并成一个。
实测结果:合并版本在 NarrativeQA 上拿到 15.81% 准确率,只比全量重训的 26.85% 略低,但GPU 小时从 72 降到 48(节省 33%)。如果用更激进的合并扫描(n=14),worst-case 也能到 7.85%,但推荐用 best-case。
对于生产环境,这意味着新增一个知识库的成本 ≈ 训练一个 MEM + 一次合并,不需要重训整个历史语料。
🆚 MeMo vs 竞品对比图
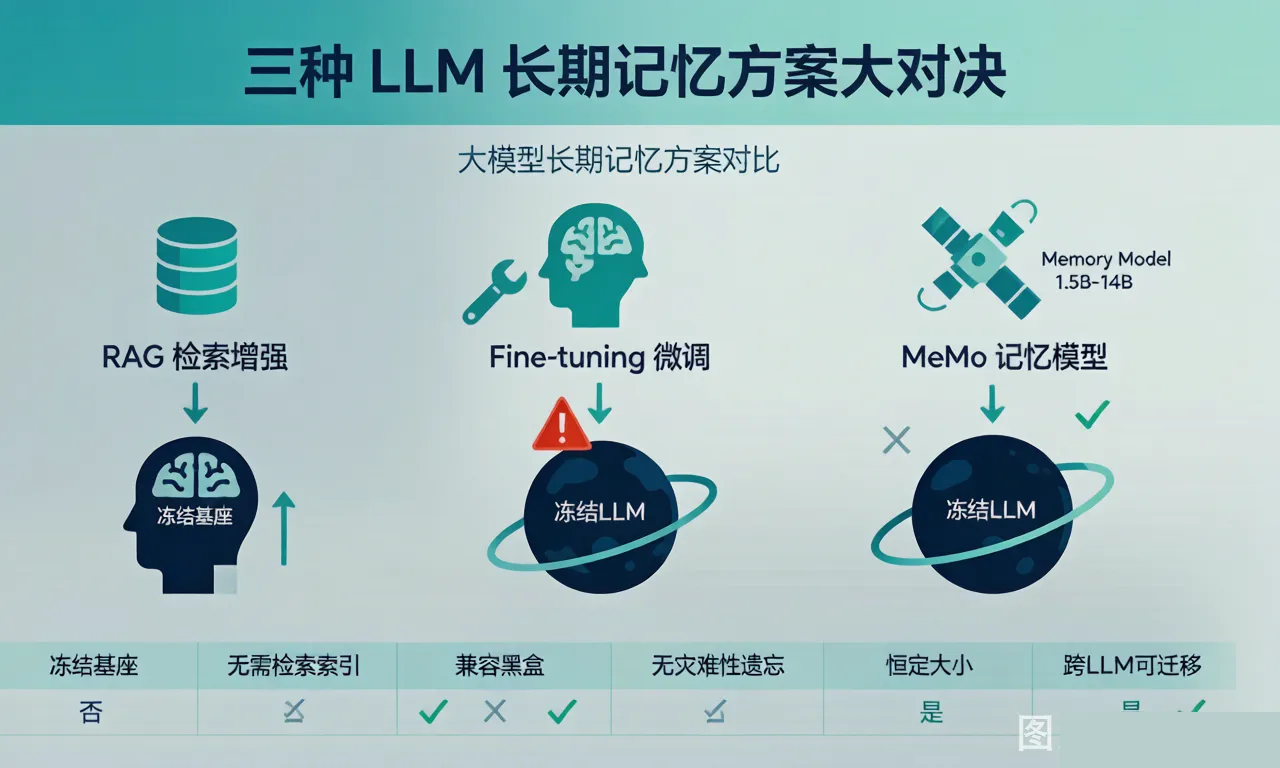
把主流方案画成一张图就很清楚:
- RAG:大脑外挂硬盘,硬盘坏一个文档就出问题
- Fine-tuning:把整个大脑拆开重组,贵 + 容易拆坏
- MeMo:大脑旁边挂一个小助手,把知识都写进小助手的"脑子里"
💡 适用场景
场景 1:企业知识库实时更新
痛点:金融研报每天 1000+ 篇、产品手册每周迭代、客服话术每天优化——不可能每周重训基座。
MeMo 方案:每个业务线训一个独立的 MEM(1.5B-14B),推理时按需加载。客服场景用 Qwen-32B 当 EM 跑本地,复杂分析场景切到 Gemini-3-Flash,性能自动 +27%。
适合客户:金融、医疗、法律、企业内部知识管理。
场景 2:多语料持续集成
痛点:今天接入游戏攻略,明天接入电商 FAQ,后天接入医疗问答——RAG 的向量库会越来越大,检索延迟线性增长。
MeMo 方案:每个新语料训一个新 MEM,然后用 TIES 合并参数空间。论文实测 K=10 时合并成本只有全量重训的 67%。
适合客户:多业务线 SaaS、知识密集型 Agent。
场景 3:黑盒闭源 LLM 增强
痛点:客户已经买了 GPT-4 / Gemini-3 的 API,但想塞私域知识——微调不可能(拿不到权重),RAG 延迟高且噪声大。
MeMo 方案:EM 就是闭源 LLM(你只发 HTTP 请求),MEM 自己部署,零接触 EM 权重。论文实测闭源 EM 比开源 EM 在 NarrativeQA 上提升 +27 个百分点。
适合客户:所有用 Claude / GPT / Gemini API 做产品的开发者。
场景 4:边缘部署 + 隐私合规
MEM 只需要 1.5B-14B 参数:单张 A100(80GB)就能同时 serve EM + MEM,整套管线本地化运行,数据不出域。
🛠️ 快速上手:5 分钟跑通最小示例
# 1. 克隆仓库
git clone https://github.com/arunv3rma/MeMo.git
cd MeMo

# 2. 创建环境(Python 3.10.19)
conda create -n memo python=3.10.19 -y
conda activate memo
pip install -r memo_requirements.txt

# 3. 配置 API Key(DeepEval 评分用)
cp .env_sample .env
# 编辑 .env 填入 OPENAI_API_KEY

# 4. 启动两个 vLLM 服务(一个 EM,一个 MEM)
# EM 用 Qwen2.5-32B-Instruct
vllm serve Qwen/Qwen2.5-32B-Instruct --port 8001

# MEM 用 Qwen2.5-14B-Instruct(训练好的 checkpoint)
vllm serve /path/to/your/mem_checkpoint --port 8002

# 5. 跑评估
bash evaluation_pipeline/structured_multi_turn/run_eval.sh
📦 仓库结构速查
MeMo/
├── baselines_icl/                # ICL oracle 和 closed-book 基线
├── data_processing_utils/        # 数据下载与预处理
├── data_synthesis_pipeline/      # 5 步合成 reflection-QA
│   ├── data_subsets/             # 预生成子集 ID
│   ├── datasynth_pipeline/       # 端到端管线 shell 脚本
│   └── loo_data_ablation/        # Leave-one-out 消融
├── sft_training/                 # SFT 训练(支持 LoRA + DeepSpeed ZeRO-2)
├── model_merging_scripts/        # Linear / SLERP / TIES / DARE 合并
├── evaluation_pipeline/          # 评估(single_turn / unstructured / structured)
└── blog/                         # 项目博客 + 配图
仓库自带完整复现脚本,从数据合成到模型合并到三阶段评估,端到端可跑通,论文所有表格都能复现。
🎯 总结
MeMo 第一次把 LLM 的"长期记忆"从一个外挂的工程组件(向量库)升级成了一个可训练、可替换、可合并的模型组件。它的核心价值不是比 RAG 准多少,而是给出了一条绕过"重训 vs 遗忘 vs 黑盒"三难困境的新路径。
关键数字回顾:
- ✅ NarrativeQA +27pp(切到 Gemini-3-Flash 后)
- ✅ 检索噪声下反而 +0.55%(其它基线 −6.22%)
- ✅ 5.5× 计算节省(K=10 时合并 vs 全量重训)
- ✅ 1.5B-14B MEM 即可承载整个语料库
- ✅ 完全兼容闭源 LLM(不需要 logits 也不需要权重)
推荐指数:⭐⭐⭐⭐⭐(满分 5 星,2026 年最值得关注的 RAG 替代方案之一)
适合人群:做企业知识库 / 多业务线 SaaS / 闭源 LLM 增强 / 边缘 Agent 部署的开发者
立即体验:arXiv:2605.15156 | GitHub 仓库
GitHub 仓库:arunv3rma/MeMo
开源协议:MIT
数据截至 2026-06-28,最新信息请以 GitHub 仓库为准。