MOSS-TTS-Nano
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../media/MOSS-TTS-Nano.pptx../media/MOSS-TTS-Nano.mp4本文目录
🔥 MOSS-TTS-Nano:0.1B超轻量多语言语音生成模型
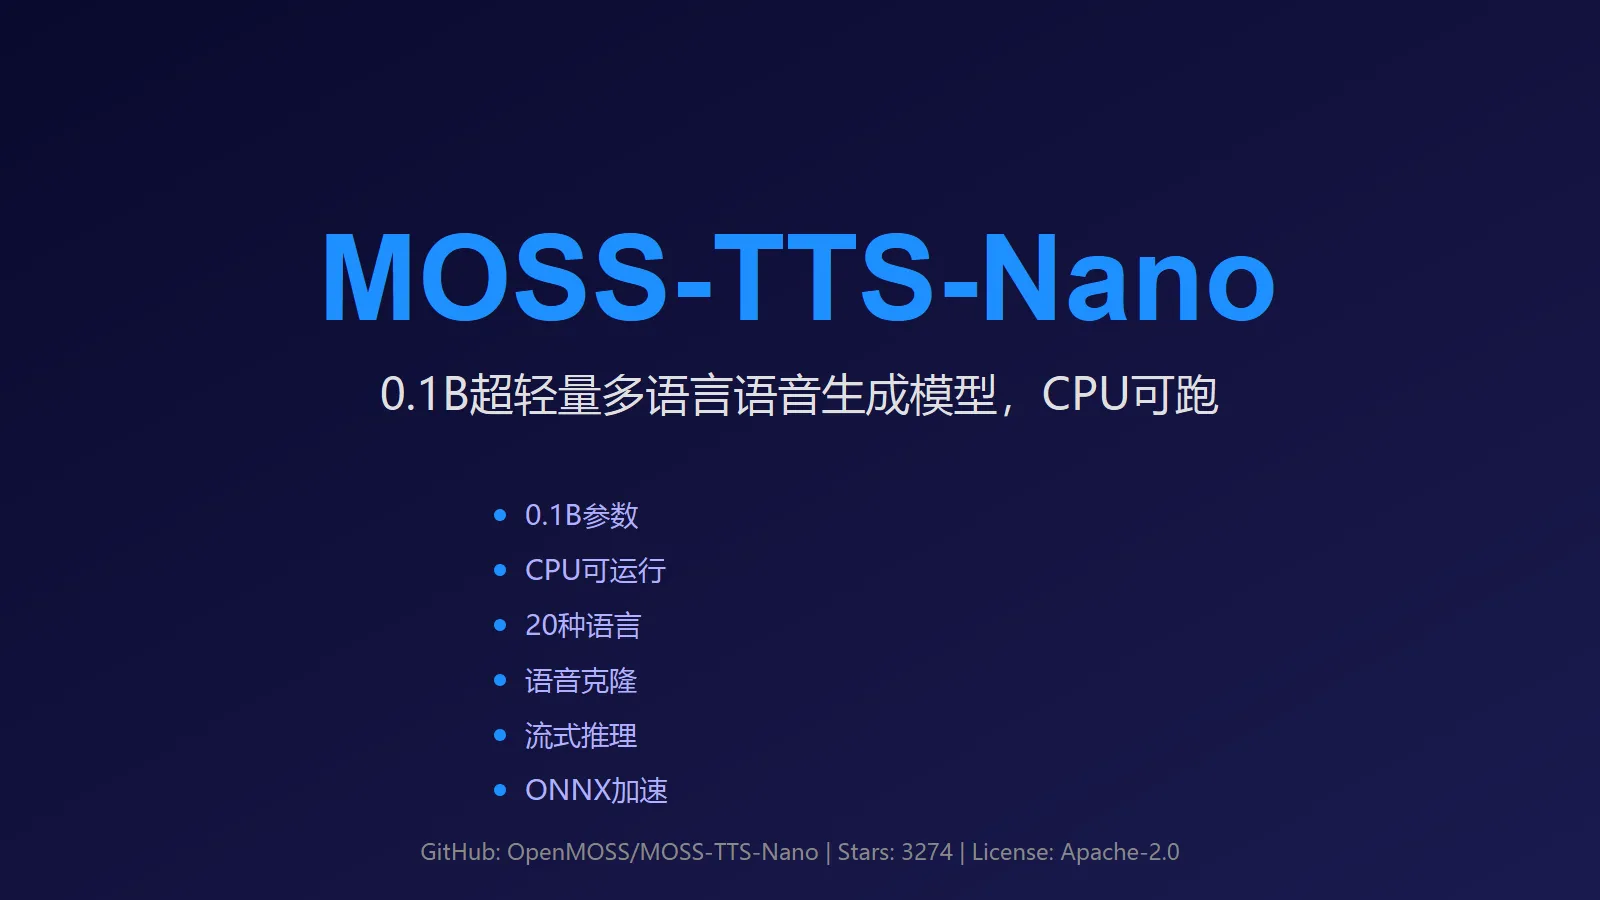
来自复旦大学 NLP 实验室 + MOSI.AI 的开源多语言微型语音生成模型,仅 0.1B 参数即可在 CPU 上实时生成语音,支持 20 种语言和语音克隆。
🚀 什么是 MOSS-TTS-Nano?
MOSS-TTS-Nano 是 OpenMOSS 团队(复旦大学 NLP 实验室 + MOSI.AI)推出的超轻量多语言语音生成模型。仅 0.1B 参数,无需 GPU 即可在普通 CPU 上实时运行,支持语音克隆、流式推理和 ONNX 加速。
对于 AI 播客创作者、语音助手开发者、以及有 TTS 需求的团队来说,MOSS-TTS-Nano 提供了一个部署简单、性能优秀、完全开源的语音合成方案。


核心定位:全球最小的实用级语音生成模型,CPU 可跑,一行命令语音克隆。
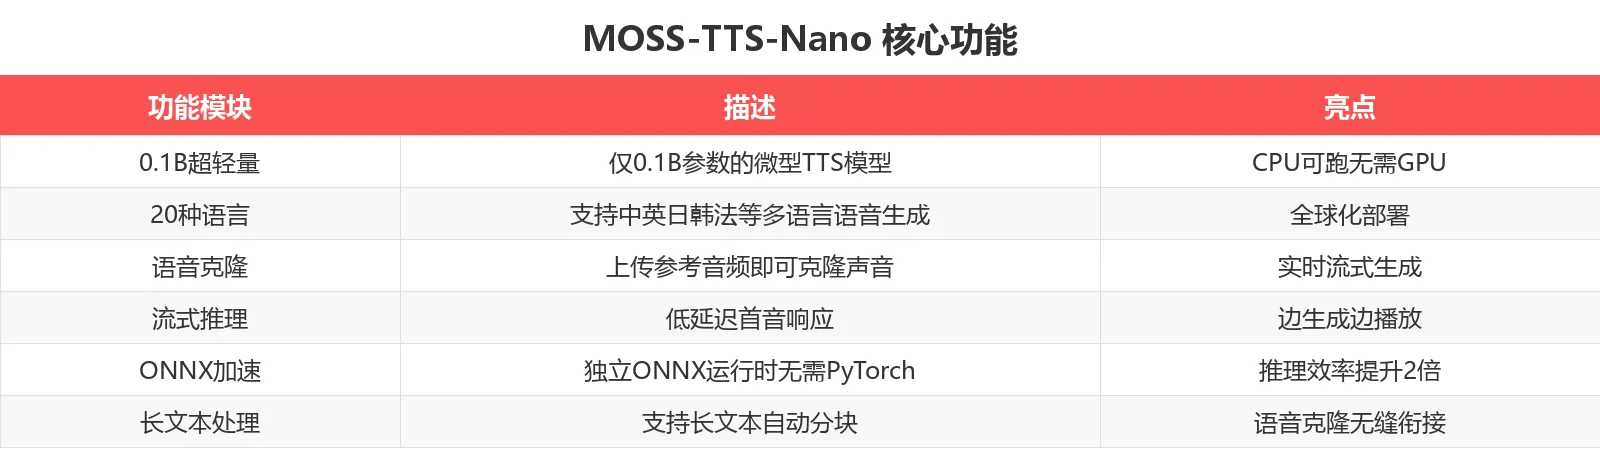
✨ 核心功能一览
🛠️ 快速上手:5 分钟跑通示例
安装
conda create -n moss-tts-nano python=3.12 -y
conda activate moss-tts-nano

git clone https://github.com/OpenMOSS/MOSS-TTS-Nano.git
cd MOSS-TTS-Nano

pip install -r requirements.txt
pip install -e .
语音克隆
只需一段参考音频,即可克隆该声音生成任意文本:
# 语音克隆
python infer.py \
  --prompt-audio-path assets/audio/zh_1.wav \
  --text "欢迎关注模思智能、上海创智学院与复旦大学自然语言处理实验室。"
CLI 命令行使用
# 一行命令生成语音
moss-tts-nano generate \
  --prompt-speech assets/audio/zh_1.wav \
  --text "欢迎使用 MOSS-TTS-Nano 命令行工具。"

# 启动 Web 服务
moss-tts-nano serve
ONNX CPU 推理(无需 PyTorch)
python infer_onnx.py \
  --prompt-audio-path assets/audio/zh_1.wav \
  --text "Welcome to the ONNX Runtime CPU demo."
注意:MOSS-TTS-Nano 最大的优势是 CPU 可跑。如果没有 GPU,直接使用 ONNX 版本,推理效率接近原始版本的 2 倍。
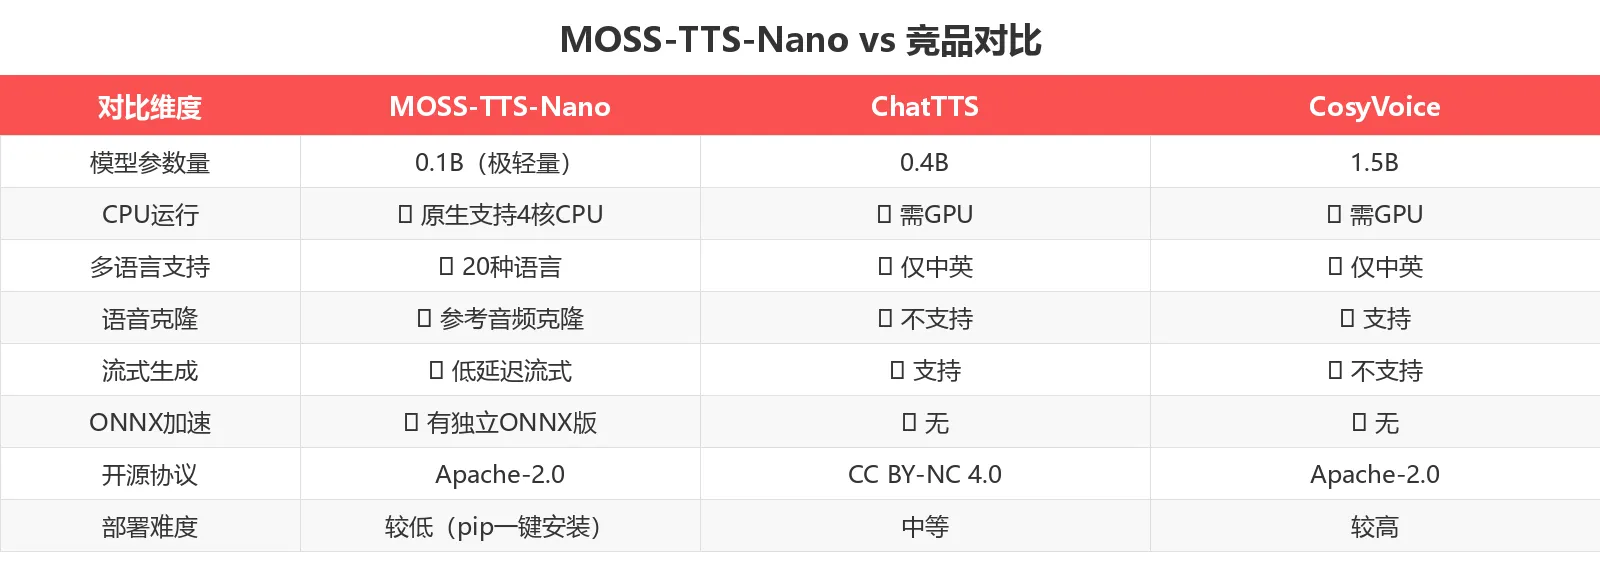
📊 与竞品对比
💡 适用场景
场景一:AI 播客 / 语音内容生成
功能说明:MOSS-TTS-Nano 基于音频分词器 + LLM 的纯自回归架构,可将文本直接生成为 48kHz 立体声音频,支持流式推理边生成边播放。
输入要求:文本字符串 + 可选的参考音频(用于语音克隆)
输出效果:48kHz 立体声 WAV 格式音频,支持 20 种语言
适用场景:
- AI 播客自动化配音
- 有声书 / 新闻播报生成
- 多语言语音内容本地化
场景二:语音助手 / 对话系统
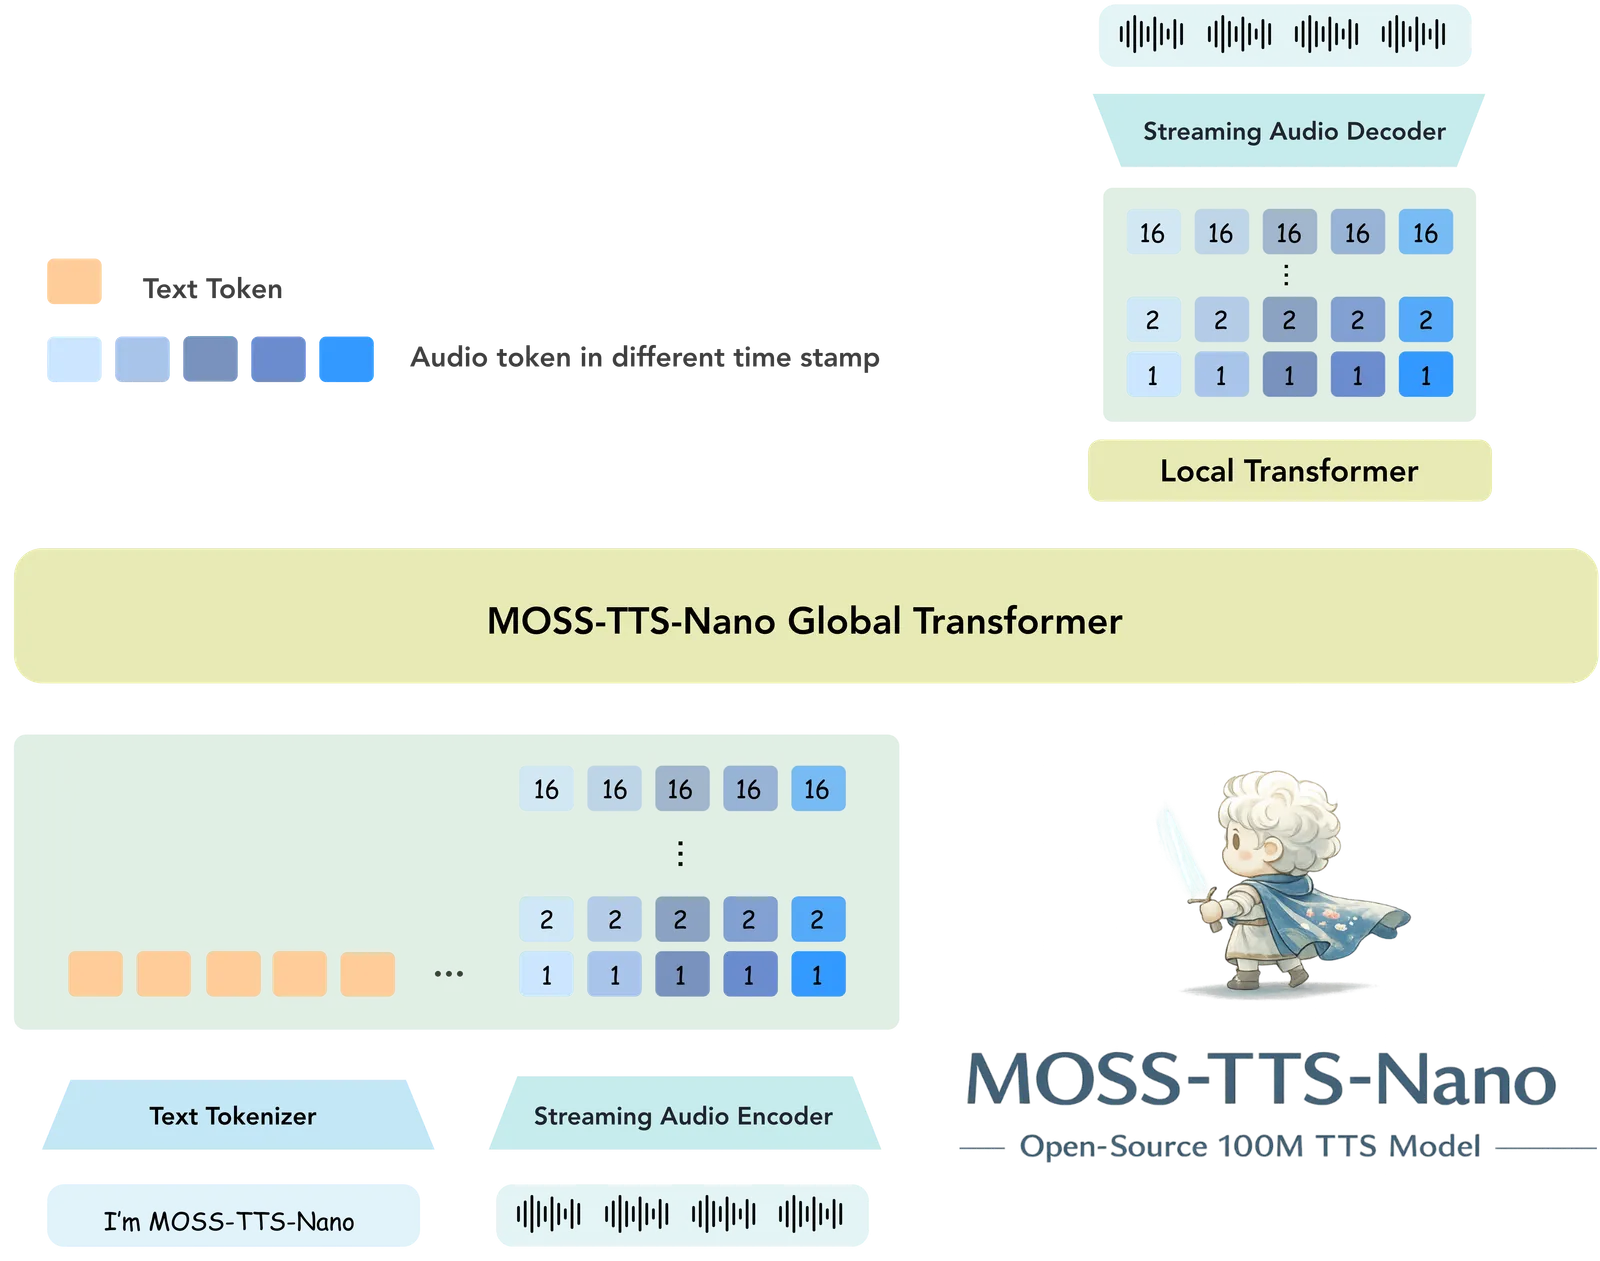
功能说明:MOSS-TTS-Nano 基于 Audio Tokenizer + LLM 的架构设计,0.1B 参数量确保在消费级硬件上也能低延迟响应。
输入要求:文本指令 + 音色参考(支持预设或动态切换)
输出效果:实时流式语音,首音延迟低
适用场景:
- 智能音箱 / 车载语音助手
- 客服机器人语音回复
- 教育类语音交互应用
场景三:跨语言语音应用
功能说明:支持中文、英语、日语、韩语、法语、德语等 20 种语言,同一模型即可覆盖多语种语音生成需求。
输入要求:任意支持语言的文本
输出效果:自然流畅的多语言语音输出
适用场景:
- 跨境电商多语言语音介绍
- 语言学习 APP 发音示范
- 国际化产品语音功能
用户群体总结
- ✅ AI 播客创作者:低成本生成高质量配音,支持语音克隆
- ✅ 语音应用开发者:CPU 可部署,降低服务器成本
- ✅ 中小团队:一个模型搞定多语言 TTS,省去多模型集成
- ✅ 教育行业:语音教学、听力材料自动生成
- ❌ 不追求极致音质:0.1B 模型音质略逊于大参数模型
💰 定价方案
完全开源免费! MOSS-TTS-Nano 采用 Apache-2.0 协议,可自由使用、修改和商用。
开源协议: Apache-2.0
💡 核心优势:0.1B 参数意味着部署成本极低。一台 4 核 CPU 服务器即可支撑实时语音生成,无需 GPU 实例。
🎯 总结
MOSS-TTS-Nano 是当前参数量最小、部署门槛最低的多语言语音生成模型之一。0.1B 参数却支持 20 种语言、语音克隆、流式推理和 ONNX 加速,让 TTS 能力真正走向低成本部署。
推荐指数: ⭐⭐⭐⭐⭐(满分5星)
适合人群: 语音应用开发者、AI 播客创作者、有 TTS 需求的任何团队
GitHub 仓库: OpenMOSS/MOSS-TTS-Nano
数据截至 2026-05-29,最新信息请以官网为准。