MOSS-Image
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../MOSS-Image-recommend.pptx../../MOSS-Image-recommend.mp4本文目录
📌 核心价值:中文字是模型自己画进图里的,不用再抠图补字
一个 5B 参数的开源图像模型,2026 年 10 月 16 日刚放出权重,免费、能本地跑。官方示例里白板上那一整段中文手写体,是模型一次生成的——不是后期 P 上去的。
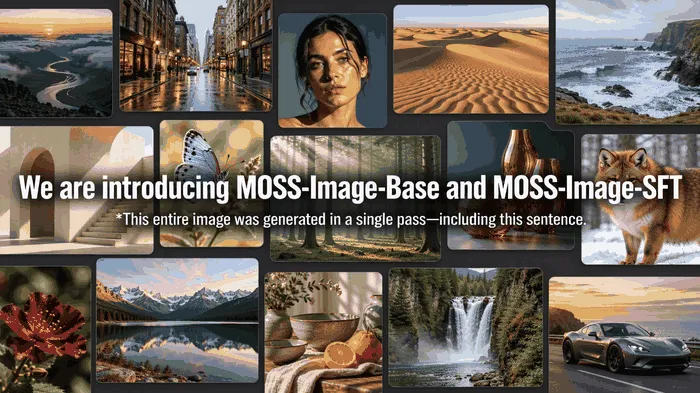
🚀 什么是 MOSS-Image?
做图的人都有同一个痛点:画面再好看,文字一塌糊涂。
让 AI 生成一张海报,山、水、人物都对,唯独标题写成鬼画符;想让它画个写着中文的白板,出来的全是乱码笔画。所以过去的标准流程是——AI 出底图,人再打开设计软件把字一个个敲上去、对齐、调间距。一张封面来回折腾半小时。
MOSS-Image 想解决的就是这一步。它由 OpenMOSS 团队开源,仓库 2026 年 10 月 16 日公开,当前 412 星、Apache-2.0 协议,基座是 5B 参数的单流 DiT 模型,文字编码器用的是 Qwen3.5-9B,VAE 来自 FLUX.2。
核心定位:它不是「又一个出图模型」,而是把「图上写字」这件事变成了模型的原生能力。
它有两个版本:
- MOSS-Image-Base:纯基座,没做任何后训练和蒸馏,参数得自己按官方推荐配;
- MOSS-Image-SFT:在整理过的数据上微调过,文字的成组和版式更整齐。
✨ 核心能力一览
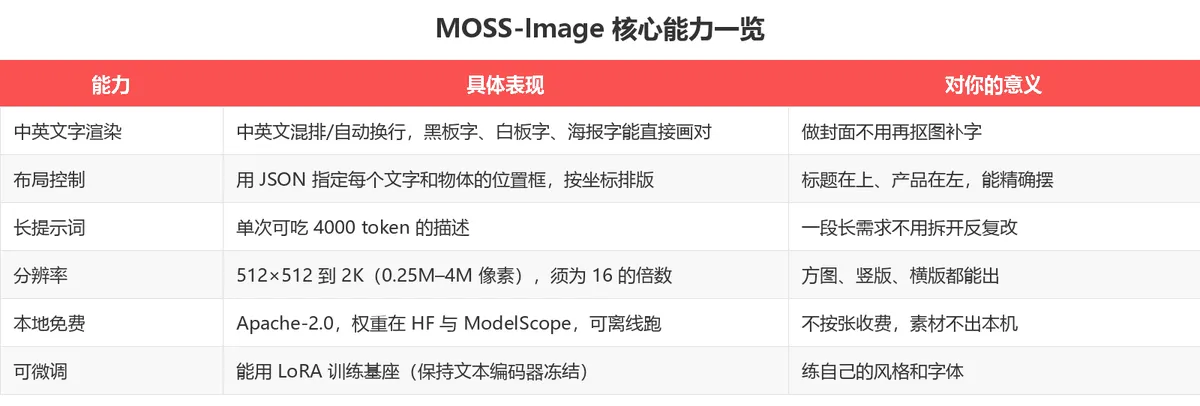
这三个点值得单独拆开说。
① 中文字,真能画对
官方 showcase 里这张是最有说服力的:
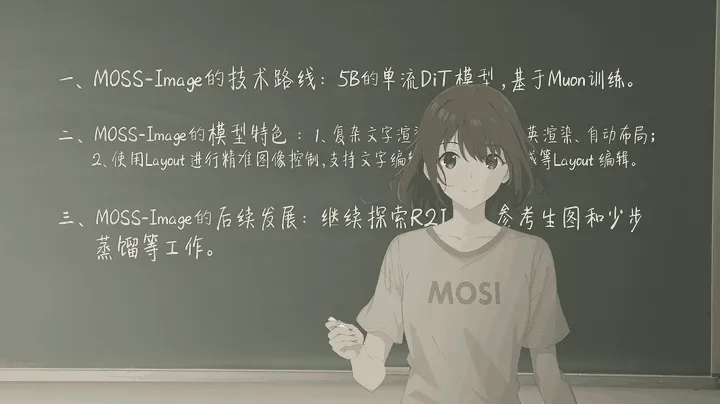
黑板上那段话是完整可读的:「一、MOSS-Image 的技术路线:5B 的单流 DiT 模型,基于 Muon 训练……」三行带编号的中文,字迹像人手写,没有缺笔画、没有串行。
另一张更极端——真人出镜,身后的玻璃板上是密密麻麻三段中文:
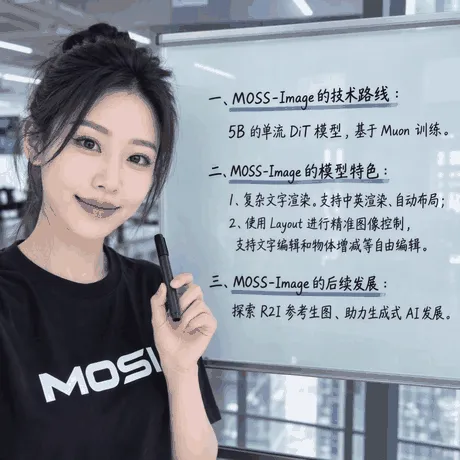
输入要求:中文或英文提示词,直接把要写的字放进引号里,需要换行的位置手动加换行符。
输出效果:文字随场景光照、透视、材质一起渲染,不是贴图。
适用场景:海报标题、知识类封面、教学板书、产品包装上的说明文字。
② 位置能按坐标摆
光会写字还不够,字得待在正确的位置。MOSS-Image 支持用一段 JSON 直接把版式喂进去:每个元素写清类型、描述、文字内容,再给一个坐标框。
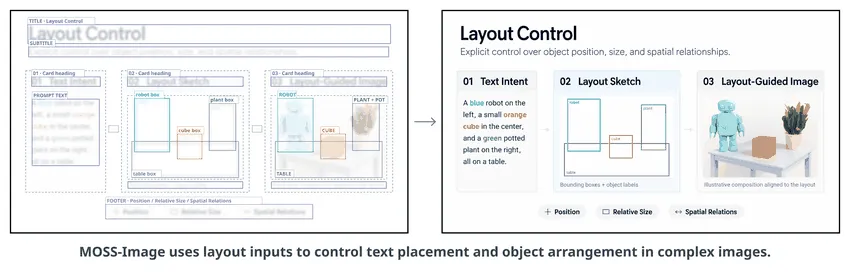
坐标用的是以画布中心为原点的绝对像素,顺序是 [y_min, x_min, y_max, x_max]。比如 1024×1024 的画布,每个轴的范围就是 -512 到 +512。官方解释过为什么不用相对坐标:不同分辨率和长宽比下,绝对像素更好控。
{
  "summary": {
    "meta": ["poster"],
    "canvas": "single",
    "caption": "A minimalist travel poster with a cream background and a blue mountain illustration."
  },
  "items": [
    {
      "label": "text",
      "caption": "Large dark-blue uppercase title centered at the top.",
      "text": "EXPLORE",
      "bbox": [-416, -384, -288, 384]
    }
  ],
  "bbox_coord_space": "abs_centralized",
  "bbox_format": "yxyx"
}
把这段 JSON 当 prompt 传进去,同时把宽高设成对应的尺寸,模型就按你画的框排版。
③ 5B 身板,还能微调
5B 在图像模型里算轻的。更关键的是它的定位——Base 版刻意不做后训练、不做 CFG 蒸馏,为的是把训练信息完整保留下来,方便社区自己训 LoRA。官方明确提醒:训的时候文本编码器要冻结,不要微调它。
这意味着风格、字体、行业版式都能自己练一版,而不是只能等官方更新。
🛠️ 三种跑法,按习惯挑
第一种:ComfyUI(最多人选这条)
仓库自带原生插件。把 comfyui/moss-image/ 整个复制到 ComfyUI/custom_nodes/moss-image/ 下,重启 ComfyUI 就能用;也可以在仓库根目录执行:
python comfyui/install.py --comfy-root /path/to/ComfyUI
然后下载官方工作流 comfyui/moss-image/example_workflows/moss-image.json,拖进 ComfyUI。工作流已经配好了 50 步、CFG 3、Shift 5、负向跳过第 22 层,采样器 Euler,分辨率 1024×1024,点 Run 就出图。
模型权重在 HuggingFace 和 ModelScope 都有,国内直接下 ModelScope 那个就行。
第二种:Gradio 界面
pip install -e '.[ui]'
python gradio_app.py --model OpenMOSS-Team/MOSS-Image-Base
界面里有「显存模式」可选,后面会讲。
第三种:Python 直接调
import torch
from diffusers import DiffusionPipeline

pipe = DiffusionPipeline.from_pretrained(
    "OpenMOSS-Team/MOSS-Image-Base",
    custom_pipeline="pipeline_moss_image",
    trust_remote_code=True,
    torch_dtype={"default": torch.bfloat16, "vae": torch.float32},
)
pipe = pipe.to("cuda")

image = pipe(
    "A wide view of a refrigerator beside a kitchen counter. "
    "A small sticky note on the door is handwritten in Chinese:\n"
    "记得买牛奶和鸡蛋!\n牛奶两盒,鸡蛋一打。",
    height=1456, width=1456,
    num_inference_steps=50,
    guidance_scale=3.0,
    uncond_skip_layers=[22],
    generator=torch.Generator("cpu").manual_seed(42),
).images[0]
image.save("note.png")
注意:宽高必须是 16 的整数倍,否则直接报错。官方推荐 1M、1.5M、2M 总像素数,也能外推到 512×512 到 2K。
🖥️ 显存不够怎么办
官方没给一个死的显存数字,而是给了三档模式,在 Gradio 的高级设置里切:
| 模式 | 行为 | 什么时候用 |
|---|---|---|
| GPU resident | 整个模型常驻显存 | 显存够,追求速度 |
| Component | 按需在 CPU / GPU 之间搬组件 | 显存中等,折中 |
| Sequential · fallback | 进一步降显存,速度变慢 | 显存紧张时兜底 |
显存实在不够,就选 Sequential,或者把出图尺寸调小。另外 Sequential 模式下「编译 DiT」这个加速选项是关掉且不可用的。
📊 和云端方案怎么选
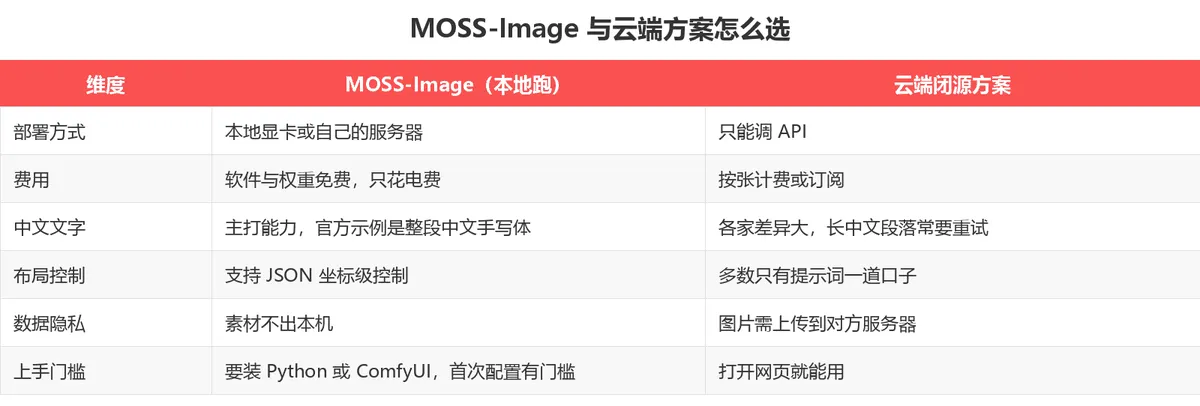
一句话:偶尔出一两张图,云端更省事;要批量出、要数据不外流、要练自己的风格,本地这套才划算。
云端方案打开网页就能用,不用配环境,但它按张收费,图也得上到别人服务器。MOSS-Image 软件和权重都是免费的,成本只剩电费,代价是首次要装 Python 或 ComfyUI。
💡 Base 和 SFT 到底差在哪
官方放了一组对照,同一个提示词、同一个人物和板书:
| MOSS-Image-Base | MOSS-Image-SFT |
|---|---|
| 三行文字挤在一起,层级偏弱 | 层级清楚,排版更整齐 |
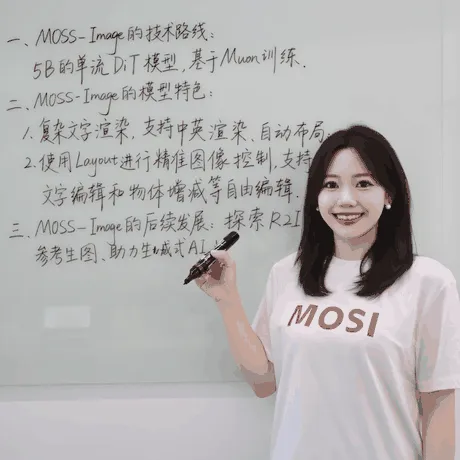
Base 版板书内容是对的,但三行中文挤在一起,字块疏密控制偏弱,行与行之间分不开。
SFT 版层级更清楚:一级标题加粗,正文往里缩进,行间距拉开,整块文字读起来更整齐。
结论很直接:想开箱好用,下 SFT;想自己训 LoRA、要一个"干净"的基座,用 Base。
⚠️ 四个先说清楚的坑
第一,中文提示词不如英文稳。 官方用户指南写得很直白:提示词默认推荐英文,因为训练量最多,中文也支持但不是最优。想要最好效果,用英文描述场景,把要渲染的中文原样放进引号。
第二,自动换行不保证符合你的预期。 官方原话是"支持自动换行,但未必完全符合预期"。要追求文字正确率和精确换行,就在 prompt 里手动加换行符——这一步别省。
第三,Base 版不是开箱即用。 它没做后训练也没蒸馏,参数不配对,出来的图会崩。老老实实按 50 步、CFG 3、Shift 5、Euler、跳过第 22 层这套推荐值来。
第四,它刚发布两天。 412 星、权重 10 月 16 日才公开,生态还在早期,插件、整合包、教程都不如成熟模型多。着急上生产的,先拿它跑一批小样验证,别直接替换现有流程。
💰 定价方案
软件和权重全部免费,Apache-2.0 协议。
- 代码:https://github.com/OpenMOSS/MOSS-Image
- 权重(海外):HuggingFace
OpenMOSS-Team/MOSS-Image-Base/MOSS-Image-SFT - 权重(国内):ModelScope
openmoss/MOSS-Image-Base/MOSS-Image-SFT
💡 你的成本只有电费:不按张计费,出多少张都不加钱。
🎯 总结
MOSS-Image 真正动的是那条最烦人的尾巴——图做完了,字还得人手补。
它把文字渲染和版式控制做成了模型的原生能力:中英混排能画对,位置能用坐标钉死,5B 的身板还能自己训 LoRA。加上 Apache-2.0 和国内可下的权重,对做封面、做海报、做知识图文的自媒体来说,这是一条值得现在就试的路。
推荐指数: ⭐⭐⭐⭐(满分5星,扣一星因为刚发布、生态还薄)
适合人群: 做封面海报的自媒体、需要批量出图文的知识博主、要数据不外流的团队、想训自有风格的开发者
不适合: 只想点一下就出图、完全不想碰环境配置的人
👉 建议的第一步:先下 SFT 版权重,用官方那套 ComfyUI 工作流跑一张带中文标题的图,看看字到底对不对——比看十篇评测都直观。
GitHub 仓库: OpenMOSS/MOSS-Image
数据截至 2026-10-18,最新信息请以官方仓库为准。