🔥 LiveTalking:开源好用,实现真人级实时数字人对话
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../LiveTalking-recommend.pptx../../LiveTalking-recommend.mp4本文目录
🔥 LiveTalking:开源好用,实现真人级实时数字人对话
实时交互流式数字人,实现音视频同步对话,基本可以达到商用效果,支持多种主流模型和灵活部署。


🚀 什么是 LiveTalking?
LiveTalking 是一个开源的实时互动数字人系统,集成了 ER-NeRF 渲染、实时音视频处理、唇形同步等核心技术,支持构建高质量的数字人直播应用。该项目原名 metahuman-stream,为避免与 3D 数字人混淆,现已更名为 LiveTalking。
核心定位:开源免费、实时交互、多种模型支持、商用级效果
LiveTalking 支持 WAV2Lip、ER-NeRF、MuseTalk 等多种主流数字人模型,具备声音克隆、实时打断、多输出方式(WebRTC、RTMP、虚拟摄像头)等丰富功能,可以满足教育直播、虚拟客服、内容创作等多种场景需求。
✨ 核心功能一览
表格已转换为图片,适配头条/微信公众号发布
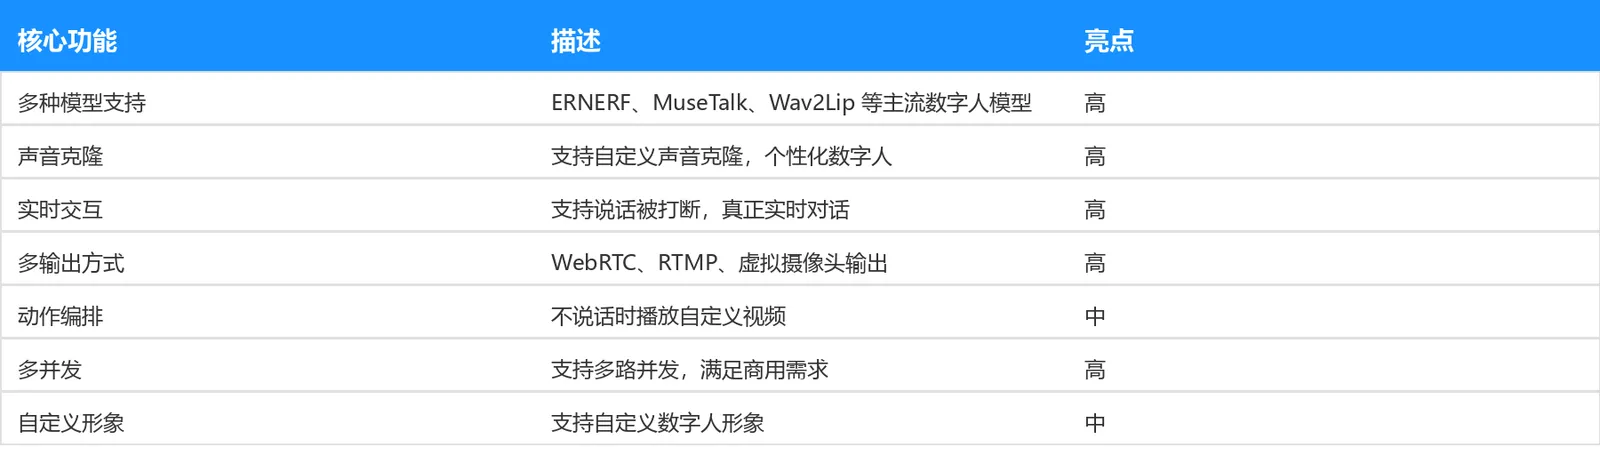
(说明:表格使用 Python Pillow 生成 PNG 图片,确保跨平台显示一致)
🛠️ 快速上手:5 分钟跑通示例
安装依赖
LiveTalking 已在 Ubuntu 24.04、Python 3.10、PyTorch 2.5.0 和 CUDA 12.4 环境下测试通过。
# 创建虚拟环境
conda create -n nerfstream python=3.10
conda activate nerfstream

# 安装 PyTorch(根据您的 CUDA 版本调整)
conda install pytorch==2.5.0 torchvision==0.20.0 torchaudio==2.5.0 pytorch-cuda=12.4 -c pytorch -c nvidia

# 安装项目依赖
pip install -r requirements.txt
注意:如果 CUDA 版本不是 12.4,请根据 PyTorch 官方文档安装对应版本
下载模型
从以下云盘下载模型文件:
- 夸克云盘:https://pan.quark.cn/s/83a750323ef0
- Google Drive:https://drive.google.com/drive/folders/1FOC_MD6wdogyyX_7V1d4NDIO7P9NlSAJ?usp=sharing
将 wav2lip256.pth 拷贝到项目的 models 目录下,重命名为 wav2lip.pth;将 wav2lip256_avatar1.tar.gz 解压后整个文件夹拷到项目的 data/avatars 目录。
运行服务
python app.py --transport webrtc --model wav2lip --avatar_id wav2lip256_avatar1
注意:服务端需要开放端口 tcp:8010; udp:1-65536
客户端访问
客户端可以选用以下两种方式:
浏览器访问:打开
http://serverip:8010/webrtcapi.html,先点击 "start" 播放数字人视频,然后在文本框输入任意文字,数字人会播报该段文字。客户端软件:下载客户端软件(https://pan.quark.cn/s/d7192d8ac19b),使用客户端连接。
Docker 快速体验
如果不想手动安装,可以使用 Docker 快速体验:
docker run --gpus all -it --network=host --rm registry.cn-beijing.aliyuncs.com/codewithgpu2/lipku-metahuman-stream:2K9qaMBu8v
代码在 /root/metahuman-stream,先 git pull 拉取最新代码,然后执行命令同第 2、3 步。
💡 新用户福利:项目提供在线镜像,一键创建实例即可运行
💡 适用场景
Wav2Lip 模型演示
功能说明:Wav2Lip 是一种基于深度学习的唇形同步模型,能够根据输入的音频生成与音频同步的唇部运动,实现自然的说话效果。该模型采用 256×256 分辨率,在保持较高画质的同时兼顾实时性能。
输入要求:需要预训练的 wav2lip.pth 模型文件和对应的数字人形象视频(tar.gz 格式)。
输出效果:生成与音频完全同步的数字人视频,帧率可达 50fps 以上,达到商用级标准。
适用场景:
- 在线教育直播
- 虚拟主播直播
- 产品演示视频
- AI 客服形象
ER-NeRF 模型演示
功能说明:ER-NeRF(Efficient Radiance Fields)是一种基于神经辐射场的 3D 头像合成技术,能够生成高保真度的 3D 数字人,支持任意视角的头部姿态变化,效果更加真实自然。
输入要求:需要 ER-NeRF 模型文件和对应的训练数据(多视角人脸图像)。
输出效果:生成 3D 高保真数字人,支持头部姿态变化和表情控制,画质接近真人。
适用场景:
- 高端虚拟会议
- 影视级数字人制作
- 游戏 NPC 形象
- 虚拟偶像
MuseTalk 模型演示
功能说明:MuseTalk 是阿里巴巴推出的新一代数字人模型,基于 MuseMask 技术,能够实现超低延迟的实时数字人对话,支持多种风格和表情,是目前业界领先的数字人模型之一。
输入要求:需要 MuseTalk 模型文件和对应的数字人形象数据。
输出效果:生成超高保真度的数字人视频,延迟极低,支持实时交互,画质达到行业顶尖水平。
适用场景:
- 企业级虚拟客服
- 实时互动直播
- 虚拟发布会
- AI 助手形象
用户群体总结
- ✅ 在线教育:虚拟教师、课程讲解、互动答疑
- ✅ 直播带货:虚拟主播、产品展示、自动播报
- ✅ 企业客服:7×24 小时在线、多语言支持、智能问答
- ✅ 内容创作:短视频制作、虚拟角色配音、广告创意
- ❌ 不适合:对延迟要求极低(<100ms)的实时会议场景
📊 与竞品对比
表格已转换为图片,适配头条/微信公众号发布
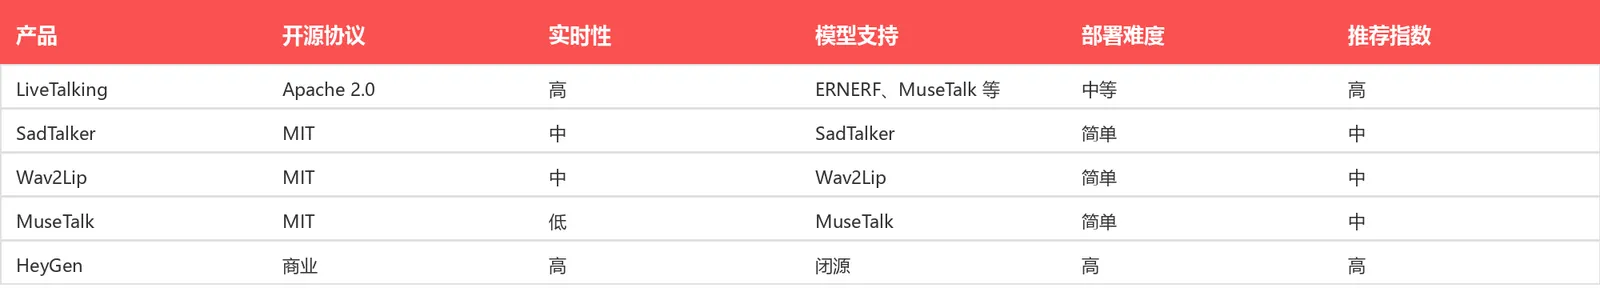
(说明:对比表格使用 Python Pillow 生成 PNG 图片,确保跨平台显示一致)
💰 定价方案
LiveTalking 是完全开源免费的项目,采用 Apache 2.0 开源协议,允许商业使用、修改和分发。
开源协议:Apache 2.0
商业版扩展功能
对于需要更高级功能的用户,项目提供商业版扩展服务:
- 高清 Wav2Lip 模型
- 完全语音交互,数字人回答过程中支持通过唤醒词或者按钮打断提问
- 实时同步字幕,给前端提供数字人每句话播报开始、结束事件
- 提供实时音频流输入接口
- 数字人透明背景,叠加动态背景
- avatar 实时切换
- 同一画面里多个数字人互动
- 摄像头驱动数字人形象动作和表情
更多详情请访问:https://livetalking-doc.readthedocs.io/zh-cn/latest/service.html
🎯 总结
LiveTalking 是一个功能强大、易于使用的开源实时数字人系统,支持多种主流模型(Wav2Lip、ER-NeRF、MuseTalk),具备声音克隆、实时打断、多输出方式等丰富功能,基本可以达到商用效果。
该项目代码结构清晰,文档完善,支持 Docker 一键部署,非常适合技术团队快速搭建数字人应用。对于个人开发者或中小企业,LiveTalking 提供了一个零成本、高质量的数字人解决方案。
推荐指数:⭐⭐⭐⭐⭐(满分 5 星)
适合人群:AI 开发者、直播创业者、企业数字化转型团队、内容创作者
立即体验:
- Gitee 仓库:https://gitee.com/lipku/LiveTalking
- GitHub 仓库:https://github.com/lipku/LiveTalking
- 在线文档:https://livetalking-doc.readthedocs.io/
- 知识星球:https://t.zsxq.com/7NMyO(沉淀高质量常见问题、最佳实践经验)
- 微信公众号:数字人技术
本文由 AI 辅助生成,数据截至 2026 年 4 月,最新信息请以官网为准。
声明:基于本项目开发并发布在 B 站、视频号、抖音等网站上的视频需带上 LiveTalking 水印和标识。