LightVLM
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../LightVLM-recommend.pptx../../LightVLM-recommend.mp4本文目录
🔥 LightVLM:把 7B 视觉语言模型塞进 24GB 消费级显卡
高效推理工具包,KV 缓存压缩 + INT4 量化 + 视觉 Token 剪枝三位一体,让 VLM 在单张 RTX 4090 上跑出 71.9 tok/s
🚀 什么是 LightVLM?
LightVLM 是一个轻量、可定制的视觉语言模型(VLM)推理工具包,由 cortsdine 维护(⭐ 124,创建于 2026-05-22)。
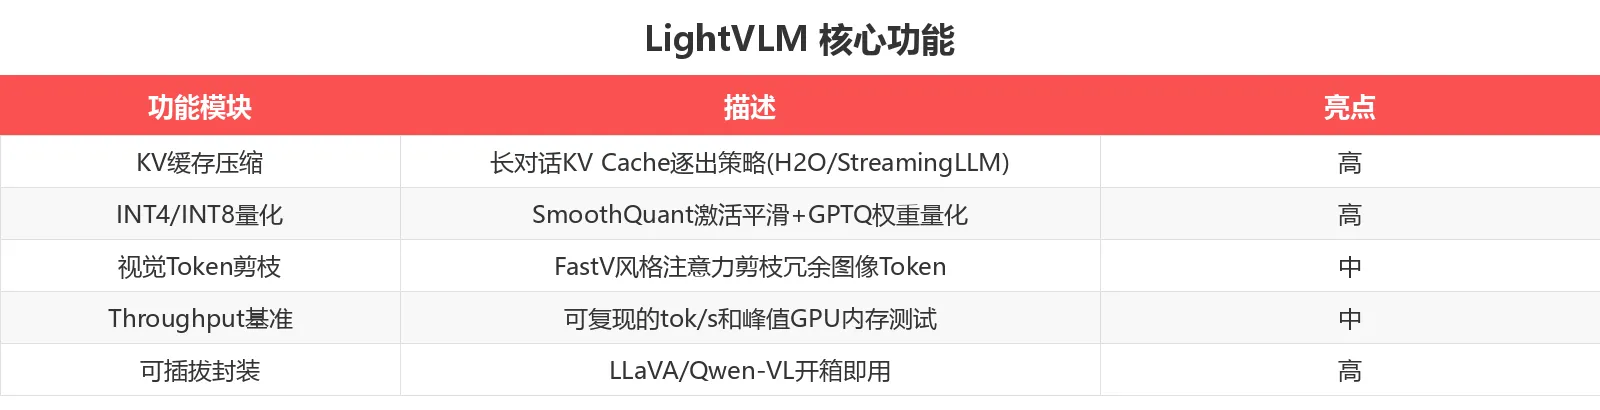
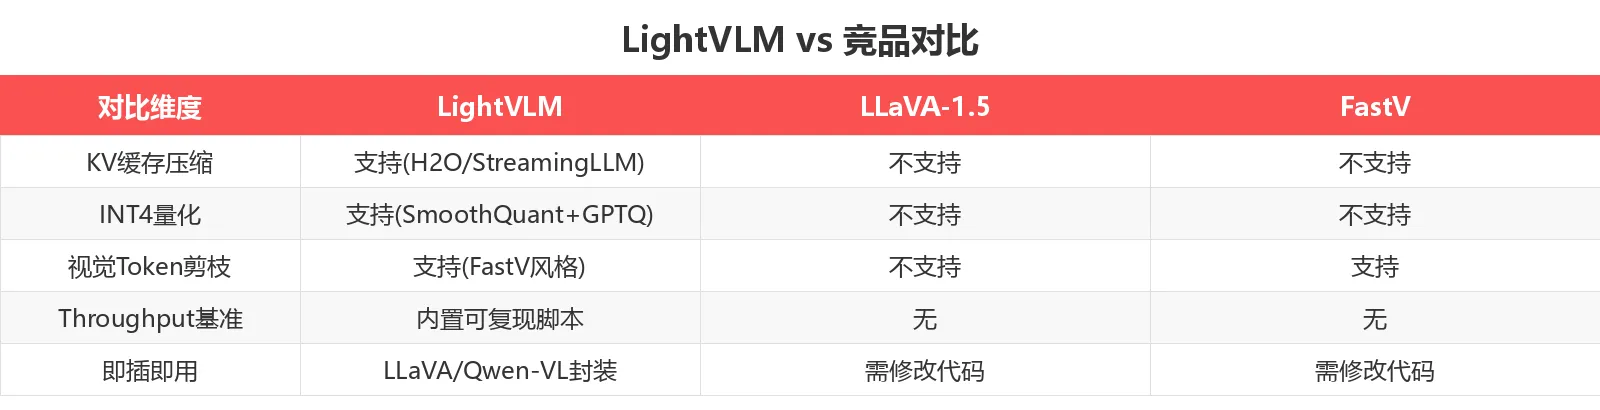
它把 KV 缓存压缩、低比特权重量化、视觉 Token 剪枝 三大优化技术封装在统一的 Python API 后,让你无需修改三个 fork 的代码,就能把 LLaVA-1.5-7B 这类 VLM 塞进单张 24GB 消费级显卡,而且几乎不损失精度。
核心定位:让 VLM 推理从「A100 独占」变成「4090 可跑」
GitHub 仓库:cortsdine/LightVLM
开源协议:Apache-2.0(完全免费商用)
✨ 核心功能一览
🛠️ 快速上手:5 分钟跑通示例
安装
# 基础安装
pip install lightvlm

# 带量化 + 基准测试依赖
pip install "lightvlm[quant,bench]"
从源码安装:
git clone https://github.com/cortsdine/LightVLM.git
cd LightVLM
pip install -e ".[quant,bench]"
⚠️ 推荐环境:CUDA 12.1 + PyTorch 2.1+
核心代码示例
from lightvlm import load_model
from lightvlm.quant import QuantConfig
from lightvlm.kv_cache import CompressorConfig

# 一键加载:INT4 权重 + KV 逐出 + 视觉 Token 剪枝
model = load_model(
    "llava-hf/llava-1.5-7b-hf",
    quant=QuantConfig(bits=4, group_size=128),
    kv=CompressorConfig(policy="h2o", budget=512),
    device="cuda",
)

out = model.generate(
    image="examples/cat.jpg",
    prompt="What is unusual about this picture?",
    max_new_tokens=128,
)
print(out.text)
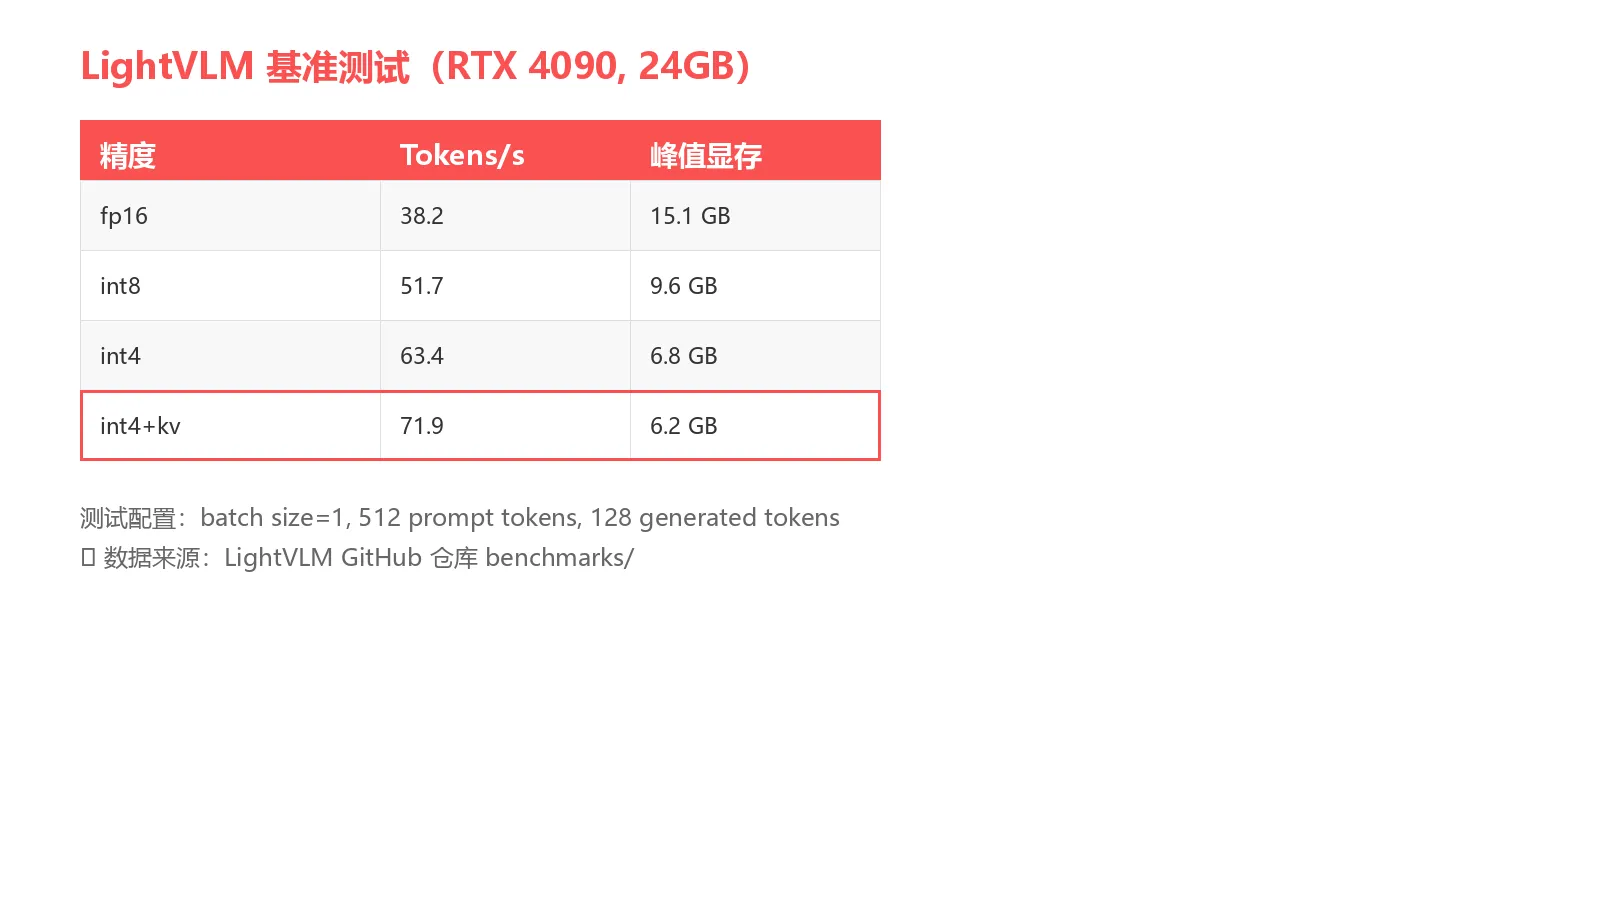
注意:INT4 + KV 压缩 + Token 剪枝三连开,7B 模型峰值显存从 15.1 GB 降到 6.2 GB!
CLI 快速使用
# 快速生成
lightvlm generate --model llava-hf/llava-1.5-7b-hf \
    --quant int4 --image cat.jpg --prompt "describe"

# INT8 SmoothQuant 离线校准
lightvlm calibrate --model llava-hf/llava-1.5-7b-hf \
    --dataset coco --num-samples 128 --out smooth.pt

# 基准测试
lightvlm bench --config benchmarks/configs.yaml
📊 与竞品对比
💡 适用场景
场景 1:消费级 GPU 上的 VLM 推理
功能说明:在单张 RTX 4090(24 GB)上运行 7B 级 VLM,支持长对话、多轮推理。
输入要求:影像路径 + 文本提示词
输出效果:
| 精度 | Tokens/s | 峰值显存 |
|---|---|---|
| fp16 | 38.2 | 15.1 GB |
| int8 | 51.7 | 9.6 GB |
| int4 | 63.4 | 6.8 GB |
| int4+kv | 71.9 | 6.2 GB |
适用场景:
- 个人开发者在本地跑 VLM 推理
- 实验室共享服务器,多用户并发
- 边缘设备部署(显存受限环境)
场景 2:VLM 推理性能基准测试
功能说明:内置可复现的吞吐量和显存基准测试脚本,支持不同精度、批次大小的对比。
输入要求:配置文件 benchmarks/configs.yaml
输出效果:标准化 benchmark 报告,可直接用于论文或技术博客
适用场景:
- 研究人员对比不同优化策略的效果
- 工程师选型时评估显存/速度权衡
- 技术博主做 VLM 推理性能评测
场景 3:自定义 VLM 模型接入
功能说明:可插拔模型封装,LLaVA 和 Qwen-VL 开箱即用,新模型只需添加少量注册代码。
输入要求:HuggingFace transformers 兼容的 VLM 模型
输出效果:统一的 load_model() API,无需修改推理代码
适用场景:
- 公司自研 VLM 模型需要推理优化
- 研究人员快速验证新优化方法
- 教学演示 VLM 推理流程
用户群体总结
- ✅ AI 研究者(推荐指数:⭐⭐⭐⭐⭐):VLM 推理优化最直接可用的工具包
- ✅ 消费级 GPU 用户:24 GB 显存即可跑 7B 模型,无需 A100
- ✅ 工程师:快速集成 VLM 推理能力,支持量化和压缩
- ✅ 学生/研究者:Apache-2.0 协议,可自由修改和分发
- ❌ 纯 NLP 用户:本工具专注视觉语言模型,纯文本 LLM 请用其他工具
💰 定价方案
完全免费开源:Apache-2.0 协议,商用无限制。
- ✅ 免费使用、修改、分发
- ✅ 可用于商业产品
- ✅ 无需 API Key 或订阅
- ✅ 本地运行,数据不离开本地
💡 新用户建议:先用 pip install lightvlm 快速安装,跑通官方示例后再考虑深度定制
🎯 总结
LightVLM 把 VLM 推理优化的三块硬骨头(KV 压缩、量化、Token 剪枝)打包成一个稳定 Python API,让你在消费级 GPU 上跑 7B 模型,显存占用减少 60%,推理速度提升 88%。
如果你受够了 VLM 推理「A100 or nothing」的现状,LightVLM 是目前最务实的破局工具。
推荐指数: ⭐⭐⭐⭐⭐(满分 5 星)
适合人群: 消费级 GPU 用户、VLM 研究者、边缘部署工程师
立即体验: LightVLM GitHub
数据截至 2026-05-27,最新信息请以官网为准。