【今日推荐JoyAI-Echo】:京东开源5分钟级长视频生成框架
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../JoyAI-Echo-recommend.pptx../../JoyAI-Echo-recommend.mp4本文目录
- 一、为什么长视频这么难?
- 二、JoyAI-Echo 是什么?
- 2.1 四大核心能力
- 2.2 数字说话
- 三、JoyAI-Echo 怎么做到的?
- 3.1 跨模态音视频记忆库(Cross-modal Memory Bank)
- 3.2 后训练 pipeline:记忆驱动 RL + DMD 蒸馏
- 3.3 交互式 Agent
- 3.4 轻量超分 Echo-SR
- 四、对比:JoyAI-Echo 强在哪?
- 4.1 长视频维度 vs HappyOyster
- 4.2 短视频维度 vs Wan 2.6
- 4.3 横向对比主流视频模型
- 五、5 分钟上手 JoyAI-Echo
- 5.1 环境准备
- 5.2 下载模型权重
- 5.3 写一段多镜头故事提示词
- 5.4 跑推理
- 5.5 硬件建议
- 5.6 ComfyUI 集成
- 六、典型应用场景
- 七、注意事项
- 八、推荐理由(一句话总结)
- 九、一键资源
【今日推荐JoyAI-Echo】:京东开源5分钟级长视频生成框架
一句话定位:京东 Joy Future Academy 开源的分钟级多镜头音视频联合生成框架,用 DMD 蒸馏把推理拉到 7.5× 加速,并首次让 5 分钟长视频里的角色长相和说话声音都能"不串台"。
GitHub:https://github.com/jd-opensource/JoyAI-Echo ⭐ 882 🍴 56 论文:https://www.researchgate.net/publication/405770309 项目主页:https://echo-team-joy-future-academy-jd.github.io/Echo-LongVideo-Page/ Hugging Face:https://huggingface.co/jdopensource/JoyAI-Echo
一、为什么长视频这么难?
过去两年,Sora、Veo、Wan 2.x、HunyuanVideo 等模型把"几秒钟的高清短视频"推到了接近工业可用的水平。但只要把时长拉到 1 分钟以上,三个老问题就会集中爆发:
- 误差累积:每一帧采样都会引入微小偏差,几千帧累加之后画面就开始"漂"——人物变形、背景穿帮、镜头逻辑不通。
- 音画对不上:主流模型要么只出画面,要么语音和嘴型错位。
- 多镜头一致性崩坏:一个角色在第 1 镜是黑头发,到第 3 镜突然变金发,IP 一致性几乎为零。
业内目前能"拍"出 5 分钟连续、稳定、有声有色的多镜头故事的方案寥寥无几。京东 Joy Future Academy 团队这次开源的 JoyAI-Echo,目标就是把这三个问题一次性解决。
二、JoyAI-Echo 是什么?
JoyAI-Echo 是一个 standalone、inference-only(纯推理) 的开源长视频生成框架,核心目标只有一句话:
用一个 JSON 提示词,生成一段 5 分钟级、跨镜头一致、音视频同步的多镜头故事。
它和"短视频模型 + 后期拼接"路线有本质区别:所有镜头在一个 pipeline 里串联生成,靠"跨模态记忆库"锁住角色长相和声音。这意味着,角色在第 1 镜穿什么衣服、用什么音色说话,到第 12 镜依然成立。
2.1 四大核心能力
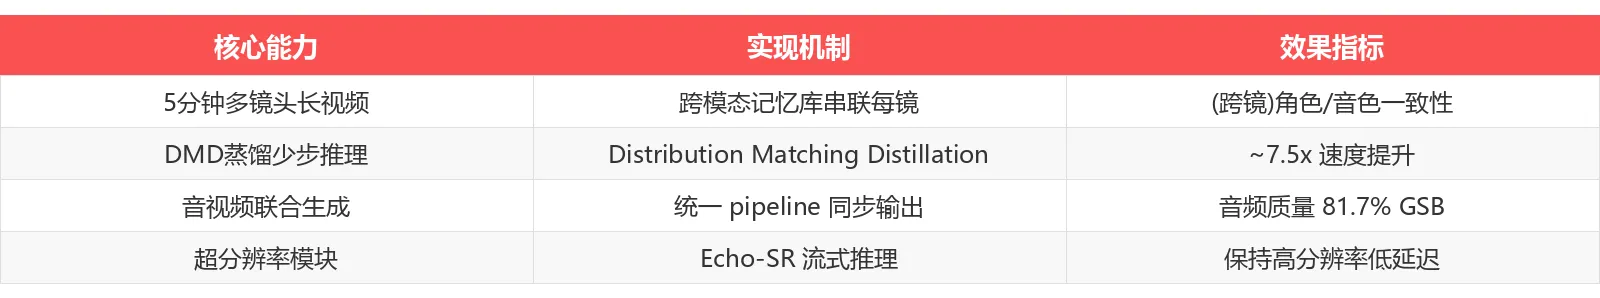
| 核心能力 | 实现机制 | 效果指标 |
|---|---|---|
| 5 分钟多镜头长视频 | 跨模态记忆库串联每镜 | 跨镜角色/音色一致性 |
| DMD 蒸馏少步推理 | Distribution Matching Distillation | ~7.5× 速度提升 |
| 音视频联合生成 | 统一 pipeline 同步输出 | 音频质量 GSB 81.7% |
| 超分辨率模块 | Echo-SR 流式推理 | 保持高分辨率低延迟 |
2.2 数字说话
官方公开的评测数据(基于 100 个 benchmark 故事、3,000 个评测镜头):
- 🎬 长视频连贯故事长度:5 分钟
- ⚡ 相对原有多步 pipeline 的速度提升:7.5×
- 🕒 单镜头规格:241 帧 @ 25 fps(约 9.6 秒/镜)
- 📚 评测基准故事数:100
- 🎞️ 评测镜头数:3,000
三、JoyAI-Echo 怎么做到的?
3.1 跨模态音视频记忆库(Cross-modal Memory Bank)
这是 JoyAI-Echo 最核心的创新。系统在生成每个新镜头时,会从前序镜头的视觉与音频特征里抽取一组"参考 token",作为这一镜的额外条件:
- 视觉记忆:锁定角色的年龄、身材、发型、脸型、穿着
- 音频记忆:锁定说话音色、语气节奏
这等于给模型装了一个"角色档案",从根本上解决多镜头一致性崩坏。
3.2 后训练 pipeline:记忆驱动 RL + DMD 蒸馏
光有记忆还不够,团队还设计了两阶段后训练:
- 基于记忆库的强化学习(memory-based RL):奖励"和记忆一致"的输出,惩罚"和记忆矛盾"的输出
- Distribution Matching Distillation(DMD):把几十步的去噪蒸馏到几步,速度提升 7.5×
3.3 交互式 Agent
通过对话指令对正在生成或已生成的视频做实时编辑("把背景换成夜晚""让角色说这句话"),不用重新跑整个 pipeline。
3.4 轻量超分 Echo-SR
为流式播放场景设计的超分模块,在保持高分辨率的同时控制延迟,官方 TODO 列表里"即将发布"。
四、对比:JoyAI-Echo 强在哪?
4.1 长视频维度 vs HappyOyster
JoyAI-Echo 团队做了 GSB 用户研究(数字代表用户偏好占比):
| 维度(长视频) | JoyAI-Echo | Tie | HappyOyster(Directing) |
|---|---|---|---|
| 视觉美感 | 63.6% | 8.8% | 27.6% |
| 音频质量 | 81.7% | 6.5% | 11.8% |
| 提示词遵循度 | 80.6% | 13.5% | 5.9% |
| IP 一致性 | 59.4% | 12.9% | 27.7% |
4 个维度全部大幅领先,尤其是音频质量和提示词遵循度——这正是多镜头长视频里最难的点。
4.2 短视频维度 vs Wan 2.6
| 维度(短视频) | JoyAI-Echo | Tie | Wan 2.6 |
|---|---|---|---|
| 视觉美感 | 58.8% | 14.7% | 26.5% |
| 音频质量 | 32.3% | 30.9% | 36.8% |
| 提示词遵循度 | 33.8% | 36.8% | 29.4% |
视觉美感胜出,但音频和提示词遵循度被短视频专精的 Wan 2.6 反超。结论很合理:JoyAI-Echo 走的是"长 + 一致"路线,不要拿它当短视频生成器用。
4.3 横向对比主流视频模型
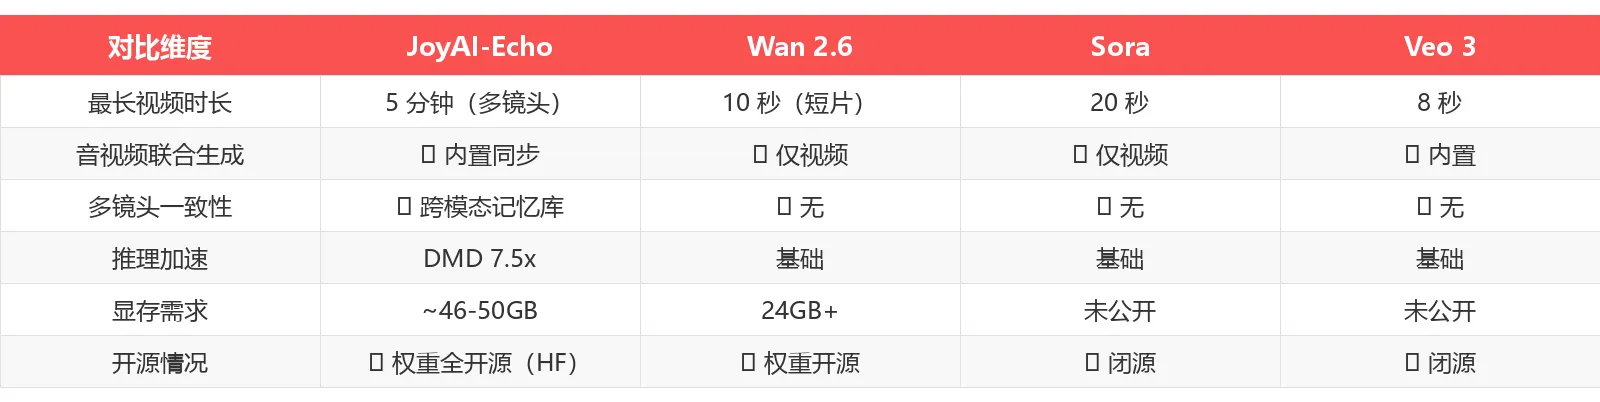
| 对比维度 | JoyAI-Echo | Wan 2.6 | Sora | Veo 3 |
|---|---|---|---|---|
| 最长视频时长 | 5 分钟(多镜头) | 10 秒(短片) | 20 秒 | 8 秒 |
| 音视频联合生成 | ✅ 内置同步 | ❌ 仅视频 | ❌ 仅视频 | ✅ 内置 |
| 多镜头一致性 | ✅ 跨模态记忆库 | ❌ 无 | ❌ 无 | ❌ 无 |
| 推理加速 | DMD 7.5× | 基础 | 基础 | 基础 |
| 显存需求 | ~46-50GB | 24GB+ | 未公开 | 未公开 |
| 开源情况 | ✅ 权重全开源(HF) | ✅ 权重开源 | ❌ 闭源 | ❌ 闭源 |
一句话总结:JoyAI-Echo 是目前唯一一个把"5 分钟 + 音视频联合 + 多镜头一致 + 全开源权重"四件事同时做齐的框架。
五、5 分钟上手 JoyAI-Echo
5.1 环境准备
官方推荐:Python 3.11 + PyTorch 2.8 + CUDA 12.8。
# 克隆仓库
git clone https://github.com/jd-opensource/JoyAI-Echo.git
cd JoyAI-Echo

# Conda 方式
conda env create -f environment.yml
conda activate echo-long

# 或 uv 方式
uv venv --python 3.11 .venv
source .venv/bin/activate
uv pip install --extra-index-url https://download.pytorch.org/whl/cu128 -r requirements.txt
ffmpeg 必须可用(conda 配方已包含;uv 方式需自行 brew install ffmpeg / apt install ffmpeg)。
5.2 下载模型权重
| 文件 | 说明 | 大小 | 链接 |
|---|---|---|---|
echo-longvideo-release.safetensors |
主模型(transformer + VAE + vocoder) | ~46 GB | Hugging Face |
gemma-3-12b/ |
文本编码器 | ~24 GB | gemma-3-12b-it |
放到 checkpoints/ 目录下:
checkpoints/
├── echo-longvideo-release.safetensors
└── gemma-3-12b/
5.3 写一段多镜头故事提示词
团队在 prompts/long_story_writer_system_prompt.md 里提供了 prompt enhancer(提示词增强器),强烈建议先过一遍增强器——未增强的提示词效果会明显更差。
每个 JSON 文件是一个对象,里面有 prompts 列表,每一项字符串就是一个完整镜头:
{
  "prompts": [
    "A 28-year-old woman with short black hair, wearing a red jacket, speaking in a calm voice. She is walking in a busy Tokyo street. Cinematic style, cool daylight, medium shot. Background: neon signs, pedestrians, light rain. Sound: rain on umbrella, soft piano BGM.",
    "The same woman now standing under a cafe awning, looking at her phone. ...(继续定义下一镜)"
  ]
}
提示词的 6 段结构(按顺序写):
| 部分 | 要描述什么 |
|---|---|
| 角色与主体 | 人物外貌(年龄/身材/发型/脸/穿着)+ 说话音色 |
| 动作与对白 | 角色在做什么、说什么 |
| 风格 | 整体视觉/情绪调性(如电影质感、冷色调、克制张力) |
| 镜头 | 景别与运镜(如稳定特写、半身中景) |
| 背景 | 场景细节 |
| 音效与 BGM | 场景声效 + 背景音乐 |
5.4 跑推理
python inference.py
模型会只加载一次,然后串行处理 prompts/ 下所有 JSON 文件。输出在 inference_result/outputs/<prompt-name>/inference_<timestamp>/。
5.5 硬件建议
| 配置 | 适用场景 |
|---|---|
| 单卡 H100 / A100 80GB | 默认 25 fps × 241 帧 × 1280×736,最佳 |
| 单卡 48GB 显存 | 同样可跑,约 46-50GB 峰值 |
| <48GB 显存 | 降分辨率/降帧数:--num-frames 121 --video-height 480 --video-width 832 |
5.6 ComfyUI 集成
如果不想写 Python,社区已经做了 ComfyUI_JoyAI_Echo 节点包:
- 完整 bf16 精度(不用 GGUF 量化)
- 每个镜头提示词可独立编辑,实时预览
- 3 阶段 GPU 显存热切换(48GB 可用)
- 内置 LLM 提示词增强
- 跨镜头记忆链式连接
六、典型应用场景
| 场景 | 怎么用 |
|---|---|
| 短剧/广告样片 | 一次生成 5 分钟多镜头成品,比传统拍摄成本下降 90%+ |
| 有声绘本 | 一个故事一个 JSON,自动产出有配音的"短动画" |
| 电商详情页视频 | 输入商品 JSON,自动生成多角度展示视频 |
| 影视前期分镜 | 导演/编剧可视化剧本,快速迭代 |
| AI 内容创作 | 短视频博主、自媒体一站式生产 |
七、注意事项
- 仅支持 T2V(文生视频):当前版本不支持 I2V(图生视频),团队表示 I2V 正在开发中。
- 显存门槛较高:46-50GB,单卡 H100/A100 80GB 或 48GB 卡最舒服。
- 权重巨大:主模型 46GB + Gemma 24GB ≈ 70GB 起步,下载预留 100GB 硬盘。
- License:基于 LTX-2 二次开发,仅限学术研究和非商业使用。商用需联系 Lightricks Ltd. 谈 LTX-2 的商用授权。
- 建议先用 prompt enhancer:团队明确说未增强的提示词效果会"明显更差"。
八、推荐理由(一句话总结)
如果你想做"几分钟级别、音画同步、跨镜头一致"的多镜头长视频,JoyAI-Echo 是目前唯一同时做到"5 分钟 + 音视频联合 + 多镜头一致 + 全开源权重"四件事的开源框架——其他模型要么只能做几秒钟短片,要么就是闭源 API。
京东这次把完整推理代码 + 46GB 主权重 + 24GB 文本编码器全开源,配合 882 颗星和 70GB 模型的诚意,值得所有做长视频生成的团队认真研究。
九、一键资源
许可证:基于 LTX-2 Community License(学术研究/非商用) 协议类型:非商业开源 研究团队:Echo Team @ Joy Future Academy, JD 发布时间:2026 年 5 月