🔥 HiDream-O1-Image:8B参数击败大模型的原生统一图像生成器
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../HiDream-O1-Image-recommend.pptx../../HiDream-O1-Image-recommend.mp4本文目录
🔥 HiDream-O1-Image:8B参数击败大模型的原生统一图像生成器
全球首个像素级统一Transformer架构,AI图像生成Arena排名第8——用8B参数实现超越更大模型的画质,无需VAE,无需外部文本编码器,一切在一个模型中完成。
🚀 什么是 HiDream-O1-Image?
HiDream-O1-Image(代号 Peanut)是智象未来(HiDream AI)最新开源的图像生成基础模型。它采用了革命性的像素级统一Transformer架构(UiT),彻底摒弃了传统图像生成模型中分离的VAE(变分自编码器)和独立文本编码器,直接在单一共享token空间中联合编码原始像素、文本和任务条件。


核心定位:一个模型搞定文生图、图像编辑、主体驱动个性化——原生支持2048×2048超高分辨率,MIT协议完全开源免费
这个项目最大的亮点在于"做减法":传统图像生成需要VAE压缩图像、CLIP编码文本、再交给Diffusion或DiT模型生成——HiDream-O1-Image把这些全部合并到同一个Transformer里,直接处理原始像素。结果不仅简化了架构,还带来了显著的性能提升。
✨ 核心功能一览
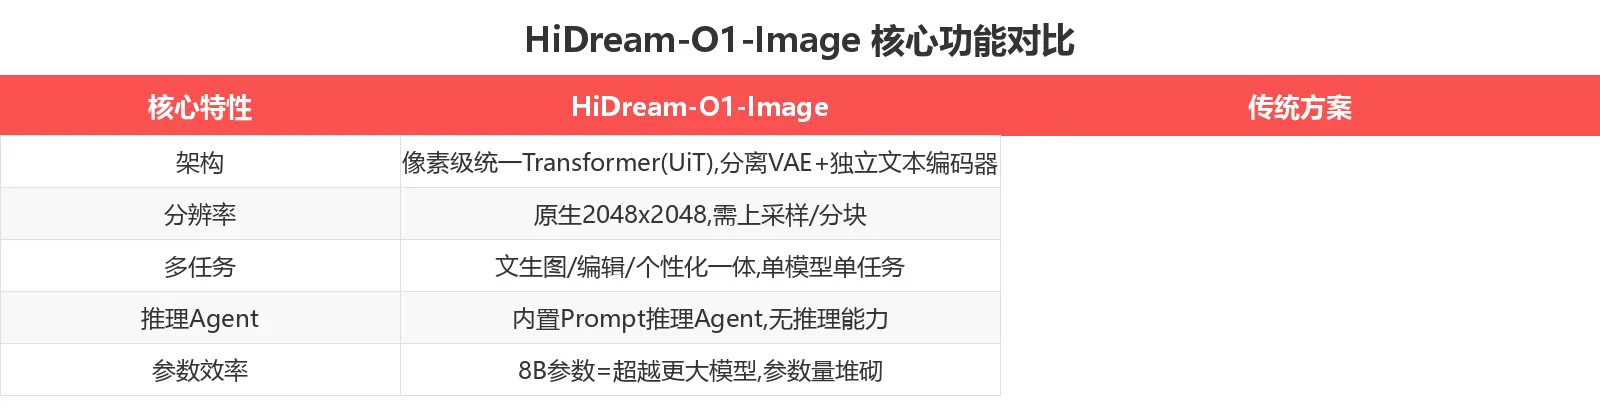
1. 像素级统一Transformer(UiT)
这是HiDream-O1-Image的灵魂架构。传统方案中,图像需要经过VAE编码为潜在空间,文本需要经过CLIP编码为向量,然后由DiT模型在潜在空间中生成。HiDream-O1-Image反其道而行——直接在原始像素层面进行操作,所有模态共享同一个token空间和Transformer网络。
这意味着:
- 零信息损耗(无需VAE压缩)
- 零模态鸿沟(文本和像素在同一空间交互)
- 原生支持超高分辨率
2. 内置推理Prompt Agent
这是项目的一大创新。模型内置了一个"思考引擎"——在生成图像之前,先通过推理Agent分析Prompt中的隐含知识、布局逻辑、物理关系和文本渲染细节,然后自动重写为优化后的Prompt。
相当于每生成一张图,模型都会先"想一想"再动手——大幅提升了图像质量的一致性和可控性
3. 多任务统一
单个模型同时支持:
- 文生图(Text-to-Image)
- 长文本渲染(Long-text Rendering)
- 指令式图像编辑(Instruction-based Editing)
- 主体驱动个性化(Subject-driven Personalization)
- 分镜故事板生成(Storyboard Generation)
🖼️ 生成效果展示
通用水生图能力

功能说明:上图展示了HiDream-O1-Image在通用文本生成任务中的强大能力。从复杂的室内场景到精细的人物肖像,模型均能生成高分辨率、细节丰富的图像。
分辨率优势:原生支持2048×2048分辨率,无需额外的上采样步骤即可获得锐利清晰的细节表现。
长文本渲染与布局控制

功能说明:HiDream-O1-Image在文本渲染方面表现突出。上图展示了模型在复杂布局下的文本渲染能力——包括书法字体、多语言混排、以及精确的布局控制。
输入要求:支持自然语言描述文本内容和布局位置,无需手动标注坐标。
适用场景:海报设计、品牌宣传物料、社交媒体图文内容创作。
主体驱动个性化(IP生成)
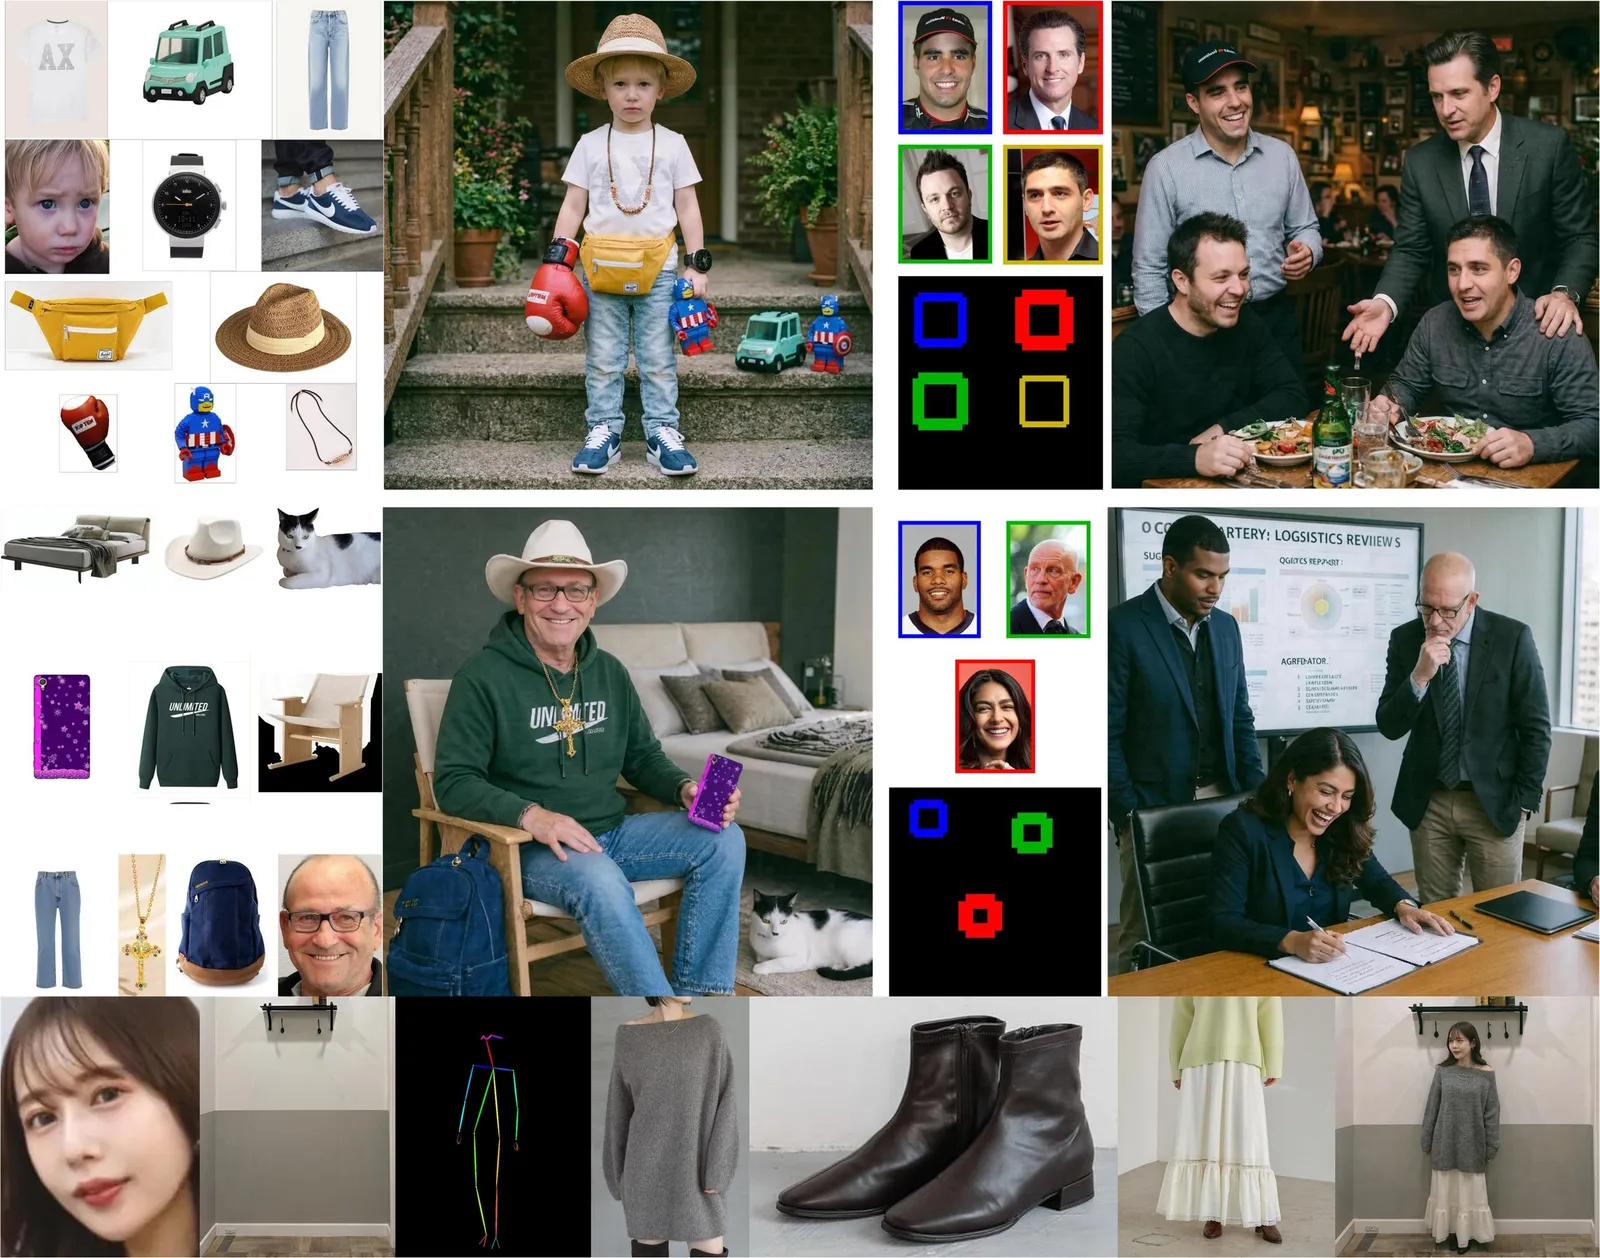
功能说明:这是HiDream-O1-Image最具商业价值的功能之一。用户可以参考特定的主体(人物、物品、风格),让生成的图像保持主体一致性的同时自由变化场景。
上图中可以看到:
- 左侧为参考物品(衣物、配饰、家具等)
- 中间为生成的合成场景(人物穿戴参考物品,背景自然融合)
- 右侧展示了面部一致性保持和多人场景生成
输入要求:提供参考图片+描述性Prompt
输出效果:保持参考主体特征的同时,在任意新场景中高质量生成。
适用场景:电商产品展示、服装虚拟试穿、品牌形象一致性维护、短视频分镜制作。
🛠️ 快速上手:5 分钟跑通示例
安装
# 克隆仓库
git clone https://github.com/HiDream-ai/HiDream-O1-Image.git
cd HiDream-O1-Image

# 安装依赖
pip install -r requirements.txt
注意:flash-attn强烈推荐安装以优化注意力计算。如无法安装,需修改 models/pipeline.py 第291行,将 "use_flash_attn": True 改为 False,否则推理会报错
核心用法示例
文生图(2K分辨率):
python inference.py \
    --model_path /path/to/HiDream-O1-Image \
    --prompt "medium shot, eye-level, front view. A woman is seated in an ornate bedroom..." \
    --output_image results/t2i.png \
    --height 2048 --width 2048
指令式图像编辑:
python inference.py \
    --model_path /path/to/HiDream-O1-Image \
    --prompt "remove the earphones" \
    --ref_images assets/edit/test.jpg \
    --output_image results/edit.png \
    --keep_original_aspect
Prompt推理Agent(本地后端):
python prompt_agent.py \
    --backend local \
    --model_id /path/to/gemma-4-31B-it \
    --prompt "李白的静夜思写在古墙上"
Web Demo
# 启动Web界面(支持full 50步 / dev 28步 两种模式)
python app.py \
    --model_path /path/to/HiDream-O1-Image \
    --host 0.0.0.0 --port 7860
启动后访问 http://localhost:7860,即可在网页中切换不同模式并集成Prompt Agent。
📊 Arena 排行榜表现
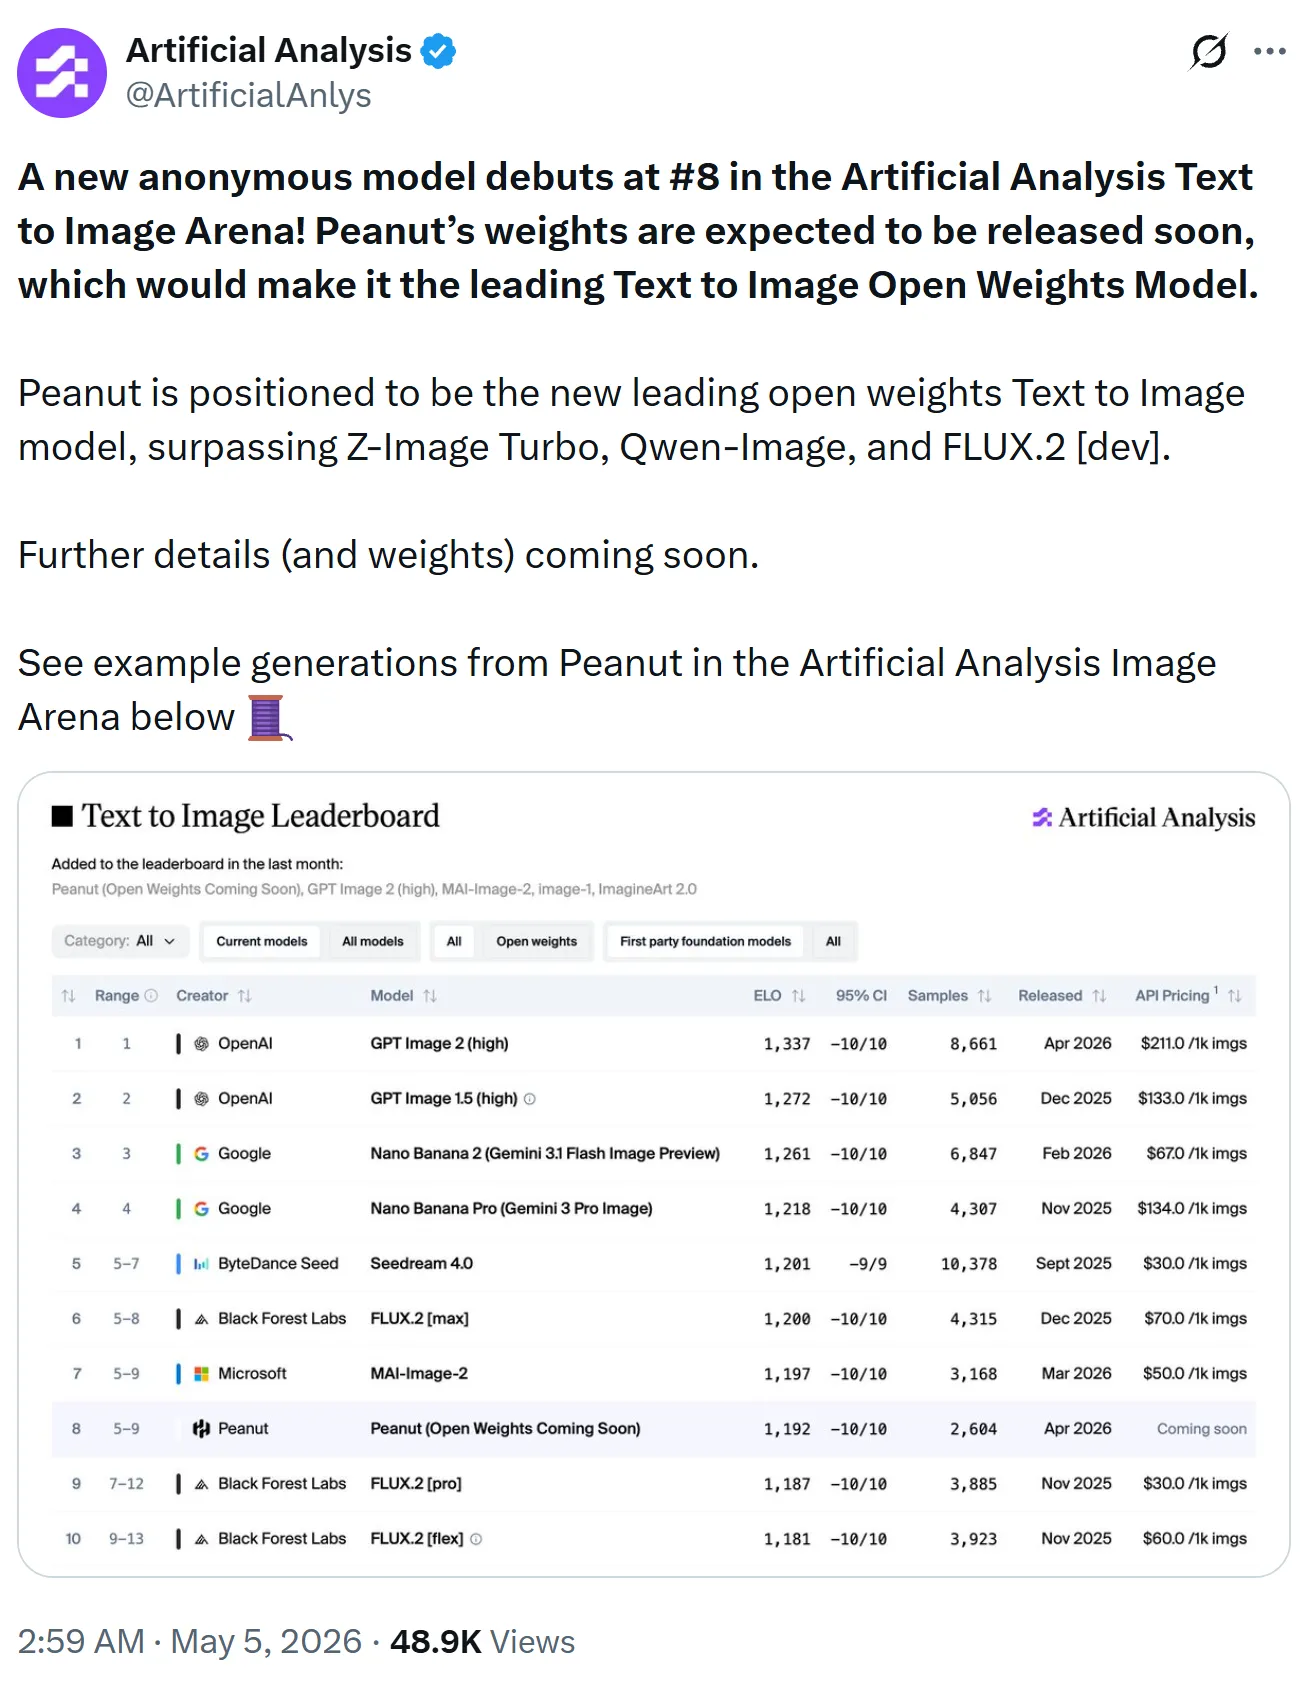
HiDream-O1-Image在Artificial Analysis Text-to-Image Arena中排名第8位——这个排名意味着它在开源模型中处于顶尖水平,与Flux.1等知名模型同台竞技。
以仅8B参数量跻身全球前10,参数效率远超同级别模型
📊 与竞品对比
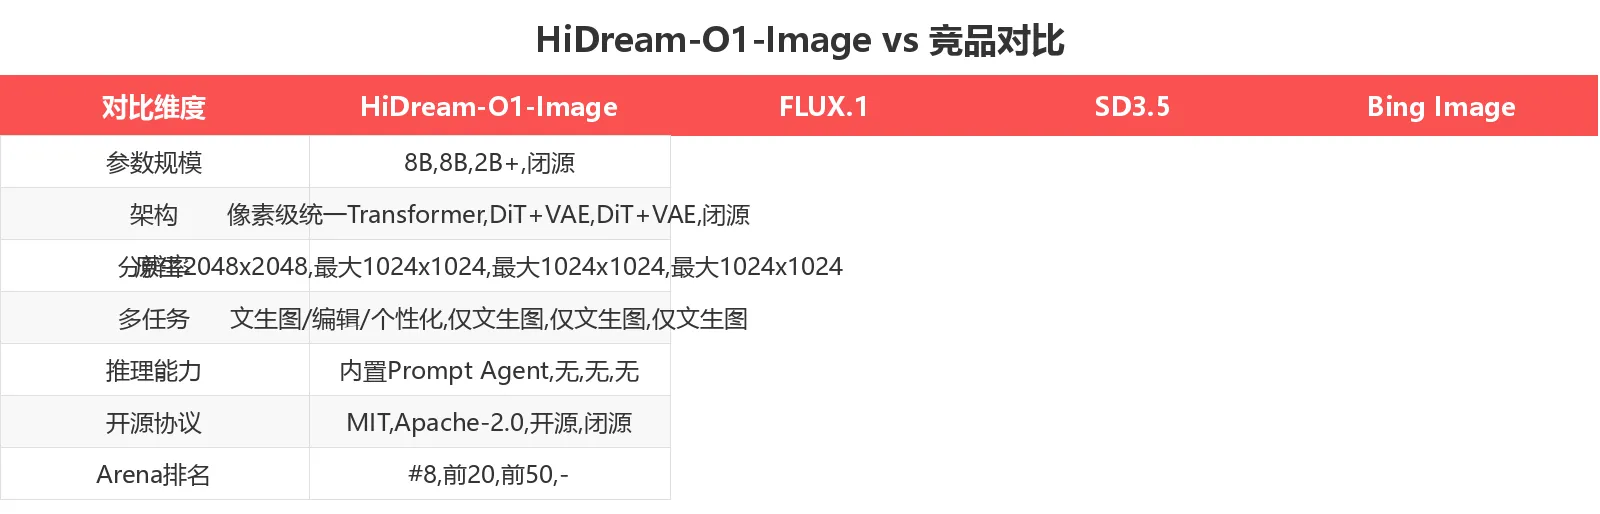
💡 适用场景
1. 电商产品可视化
功能说明:利用主体驱动个性化能力,将产品放入任意场景进行展示,大幅降低拍摄成本。
输入要求:产品参考照片 + 场景描述Prompt
输出效果:高质量产品场景图,保持产品细节与光照一致性
适用场景:电商详情页、社交媒体推广、品牌画册制作
2. 海报与平面设计
功能说明:强大的长文本渲染能力,可在图像中精确控制文字的位置、字体和风格。
输入要求:设计描述 + 需要渲染的文字内容
输出效果:图文并茂的设计稿,中文书法、多语言混排均可胜任
适用场景:活动海报、品牌宣传、社交媒体图文
3. 影视前期制作
功能说明:分镜故事板生成功能,快速将剧本转化为可视化分镜。
输入要求:场景描述、角色设定、镜头语言
输出效果:多场景连贯分镜,保持角色一致性
适用场景:电影/短视频前期规划、剧本可视化、创意提案
用户群体总结
- ✅ AI图像生成研究者:UiT架构开创性设计,具有极高的学术研究价值
- ✅ 电商运营师:产品可视化、虚拟试穿,替代部分拍摄需求
- ✅ 平面设计师:海报生成、文本渲染、快速原型设计
- ✅ 影视从业者:分镜制作、前期视觉规划
- ✅ 内容创作者:社交媒体图文、品牌宣传素材
- ❌ 纯新手零门槛用户:需安装依赖和配置GPU环境,有一定技术门槛
💰 定价方案
开源协议:MIT — 完全免费开源,可商用,无任何限制
模型权重:提供两种版本
- Full版本:完整模型,50步推理,高质量输出
- Dev蒸馏版本:加速版,28步推理,适合快速迭代
💡 新用户福利:MIT协议意味着你可以免费商用,无需任何授权费用——Hugging Face 上已提供在线Demo体验
在线体验:
本地部署需求:需要GPU显存≥24GB(推荐A100/H100),模型约16GB(BF16精度)
🎯 总结
HiDream-O1-Image代表了图像生成领域的一个重要转折点:用更统一的架构替代模块化的拼接方案。其像素级统一Transformer(UiT)架构证明了"简单即是力量"——去除VAE和分离编码器的设计不仅简化了部署流程,还带来了更好的生成质量。内置的推理Prompt Agent更是独步天下的功能,让模型在生成之前先"思考",大幅提升了输出的一致性和可控性。
推荐指数: ⭐⭐⭐⭐⭐(满分5星)
适合人群: AI图像研究者、电商设计师、平面设计师、影视从业者、内容创作者
立即体验: Hugging Face Online Demo
GitHub 仓库: HiDream-ai/HiDream-O1-Image
数据截至 2026-05-14,最新信息请以官网/仓库为准。