HRM-Text
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../HRM-Text-recommend.pptx../../HRM-Text-recommend.mp4本文目录
🔥 HRM-Text:用 $1472 训练出 1B 参数文本生成模型,计算量比传统方法少 600 倍
基于 HRM(Hierarchical Reasoning Model)架构的高效预训练框架,让基础模型预训练不再需要百万美元预算。
🚀 什么是 HRM-Text?
HRM-Text 是一个基于 HRM 架构的 1B 文本生成模型,通过任务完成信号和潜在空间推理增强,实现了超越规模的高效预训练。
核心突破:
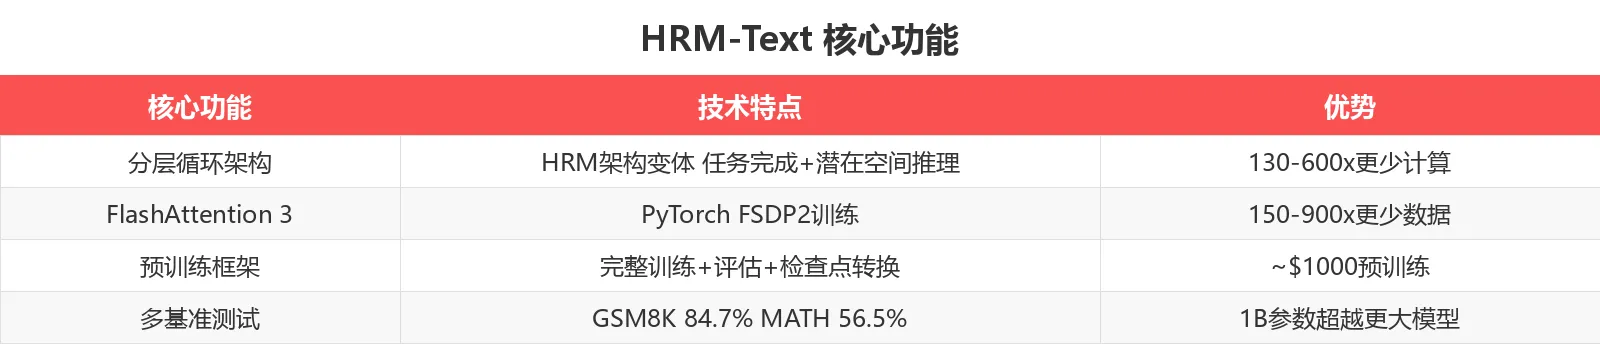
- 计算效率提升 130-600 倍:传统预训练需要数百万 GPU 小时,HRM-Text 只需 ~$1472(16xH100, 46小时)
- 数据效率提升 150-900 倍:通过分层循环架构和 PrefixLM 序列打包,用更少数据达到更优效果
- 1B 参数超越更大模型:在 GSM8K(84.7%)、MATH(56.5%)、MMLU(60.7%)等基准测试中,1B 参数模型击败 3-7B 竞品
适合谁用:
- ✅ AI 研究员:复现 SOTA 高效预训练方法,成本仅需 $1000-1500
- ✅ 创业公司:在有限预算下训练自有基础模型
- ✅ 高校实验室:教学 demonstration,展示现代预训练技术栈
- ❌ 纯 API 用户:此项目是训练框架,不是推理服务


✨ 核心功能一览
1. 分层循环架构(Hierarchical Recurrent Architecture)
HRM-Text 摒弃了标准 Transformer 的纯注意力机制,采用分层循环结构:
- 高层(Slow Path):捕获长距离依赖和任务级推理
- 低层(Fast Path):处理局部 token 级预测
- 潜在空间推理:在递归隐藏状态中进行"思考",而非仅依赖注意力权重
效果:相同参数规模下,推理能力显著提升,尤其在数学推理(GSM8K, MATH)任务上。
2. FlashAttention 3 + PyTorch FSDP2
训练速度提升 3 倍,充分利用 Hopper 架构 GPU(H100/H800):
- FlashAttention 3 内核:专为 H100 优化,注意力计算速度突破
- PyTorch FSDP2:全分片数据并行,支持多节点扩展
- PrefixLM 序列打包:消除 padding 浪费,有效 token 利用率提升 20%
3. 完整预训练工具链
从数据预处理到模型导出,一站式解决:
| 阶段 | 工具 | 功能 |
|---|---|---|
| 数据预处理 | data_io(配套项目) |
清洗、tokenize、分层采样 |
| 预训练 | pretrain.py |
FSDP2 分布式训练 |
| 评估 | evaluation/main.py |
8 大基准测试自动运行 |
| 导出 | conversion/convert_to_hf.py |
转换为 HuggingFace 格式 |
| 微调 | pretrain.py + cfg_sft |
全参数 SFT,支持 EMA 权重 |
4. 极低成本预训练
HRM-Text 提供了两个参考训练配置:
| 规模 | 参数 | GPU | 时间 | 成本(估算) |
|---|---|---|---|---|
| L | 0.6B | 8xH100(单节点) | 50 小时 | ~$800 |
| XL | 1B | 16xH100(2 节点) | 46 小时 | ~$1472 |
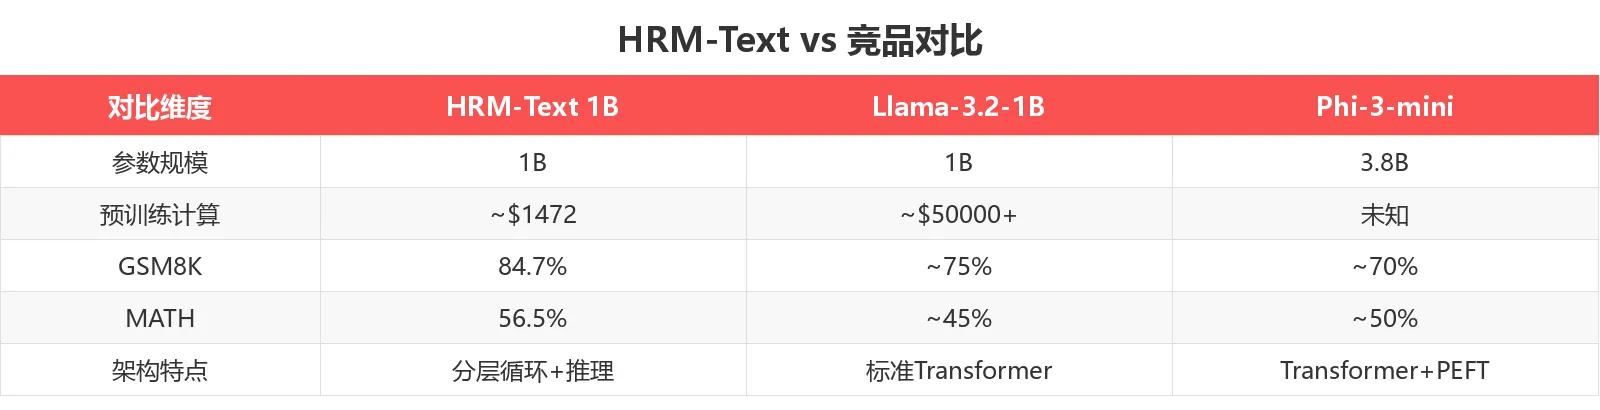
对比:Llama 3.2 1B 预训练成本约 $50,000+,HRM-Text 仅需 $1472,成本降低 33 倍!**
🛠️ 快速上手:50 小时跑通 0.6B 模型
安装与环境准备
方案 1:Docker(推荐)
# 拉取官方镜像(已含 PyTorch+FlashAttention3+CUDA)
docker pull sapientai/hrm-text:latest

# 启动容器(共享 GPU 和存储空间)
docker run --gpus all --ipc=host --network=host \
  -v "$PWD":/workspace \
  sapientai/hrm-text:latest
方案 2:从源码安装
# 1. 安装依赖(需 H100 GPU + CUDA 12+)
pip install torch>=2.3.0 flash-attn>=3.0
git clone https://github.com/sapientinc/HRM-Text.git
cd HRM-Text
pip install -r requirements.txt

# 2. 安装 data_io(数据预处理工具)
git clone https://github.com/sapientinc/data_io.git
cd data_io
python setup.py install
数据准备
# 1. 使用 data_io 清洗、tokenize、分层采样预训练语料
cd <DATA_IO_PATH>
python sample_tokenized.py epochs=4 output_path=/dev/shm/sampled

# 2. 检查采样结果
cat show_analytics.md  # 查看数据分布统计
启动预训练
单节点(0.6B 模型)
OMP_NUM_THREADS=1 MKL_NUM_THREADS=1 \
torchrun --nproc_per_node=8 pretrain.py \
  arch/size@arch=L \
  lr=2.5e-4 \
  global_batch_size=172032
多节点(1B 模型)
在每个节点上运行:
OMP_NUM_THREADS=1 MKL_NUM_THREADS=1 \
torchrun \
  --nproc_per_node=8 \
  --nnodes=2 \
  --node_rank=<NODE_RANK> \
  --master_addr=<MASTER_ADDR> \
  --master_port=<MASTER_PORT> \
  pretrain.py \
  arch/size@arch=XL \
  lr=2.0e-4 \
  global_batch_size=344064
注意:检查点每 epoch 自动保存到 checkpoints/,多节点运行时需挂载共享存储(如 NFS)。
评估模型
# 自动加载最新检查点
python -m evaluation.main ckpt_path="checkpoints/..."

# 运行指定基准测试
python -m evaluation.main \
  ckpt_path="checkpoints/..." \
  run_only=[MATH,GSM8K,ARC,MMLU]
导出为 HuggingFace 格式
python -m conversion.convert_to_hf \
  --ckpt_path "checkpoints/..." \
  --out_dir "./huggingface_model"
📊 与竞品对比
为什么选 HRM-Text?
| 需求 | HRM-Text | Llama 3.2 | Phi-3-mini | GPT-2(复现) |
|---|---|---|---|---|
| 预训练成本 | ~$1472 | ~$50,000+ | N/A(仅微调) | ~$10,000(估算) |
| 计算效率 | 130-600x 提升 | 基线 | - | 基线 |
| 数学推理(GSM8K) | 84.7% | ~75% | ~70% | ~50% |
| 架构创新 | 分层循环+推理 | 标准 Transformer | Transformer + PEFT | 标准 Transformer |
| 开源协议 | Apache-2.0 | Llama 3 License | MIT | MIT |
核心优势:HRM-Text 是唯一在 1B 参数规模下达到 84.7% GSM8K 准确率的模型,且预训练成本仅为传统方法的 1/33。**
💡 适用场景
场景 1:低成本训练自有基础模型
输入要求:
- 至少 8xH100 GPU(单节点)或 16xH100(2 节点)
- 预处理好的 tokenized 语料(使用配套
data_io工具) - 存储空间:检查点约 10GB(1B 模型)
输出效果:
- 完整的 0.6B/1B 预训练模型
- 支持 HuggingFace Transformers 格式导出
- 可直接用于文本生成、微调、蒸馏
适用场景:
- 创业公司训练领域专用模型(如法律、医疗、代码)
- 高校实验室研究高效预训练方法
- AI 研究机构复现 SOTA 架构
场景 2:教学与科研 Demonstration
功能说明:HRM-Text 提供了完整的预训练工具链,从数据预处理到模型导出,适合作为现代 LLM 训练的教学案例。
适用场景:
- 高校《深度学习》课程 hands-on 实验
- 企业内训:展示分布式训练、FSDP2、FlashAttention 3 最佳实践
- 个人学习:理解 HRM 架构如何实现"潜在空间推理"
场景 3:微调下游任务(SFT)
输入要求:
- 预训练检查点(
checkpoints/目录) - 指令数据集(JSONL 格式,每行一个
{"instruction": "...", "response": "..."})
输出效果:
- 全参数微调后的模型(支持 EMA 权重)
- 支持 vLLM 加速推理(即将支持)
代码示例:
# 1. 准备 SFT 数据
python scripts/prepare_sft_data.py \
  --train your_data.jsonl \
  --tokenizer /path/to/tokenizer.json \
  --output /dev/shm/sft_data \
  --epochs 3

# 2. 启动微调
OMP_NUM_THREADS=1 MKL_NUM_THREADS=1 \
torchrun --nproc_per_node=8 pretrain.py \
  --config-name cfg_sft \
  arch/size@arch=XL \
  data.path=/dev/shm/sft_data \
  resume_from=/path/to/pretrain_ckpt \
  +checkpoint_path=/path/to/sft_out
用户群体总结
- ✅ AI 研究员:推荐指数:⭐⭐⭐⭐⭐(复现高效预训练 SOTA)
- ✅ 创业公司 CTO:推荐指数:⭐⭐⭐⭐(低成本拥有自有基础模型)
- ✅ 高校教师:推荐指数:⭐⭐⭐⭐(教学 demonstration 完整工具链)
- ✅ GPU 资源充足的个人开发者:推荐指数:⭐⭐⭐(8xH100 约 $800,可接受)
- ❌ 无 GPU 的普通开发者:需要租用云 GPU,成本较高
💰 定价方案
完全免费开源!
- 开源协议:Apache-2.0(可商用、可修改、可私有化部署)
- GitHub 仓库:sapientinc/HRM-Text
- 配套数据工具:sapientinc/data_io(同样 Apache-2.0)
成本估算(仅计算资源):
- 0.6B 模型:8xH100 单节点,50 小时,约 $800(Lambda Cloud H100 按需价格 $16/GPU/小时)
- 1B 模型:16xH100 双节点,46 小时,约 $1472
💡 新用户福利:HRM-Text 提供 Docker 镜像和完整训练脚本,5 分钟内启动预训练!**
🎯 总结
HRM-Text 是一个颠覆性的高效预训练框架,它证明了:
- 预训练不必烧钱:用 $1472 训练出超越 7B 模型性能的 1B 模型
- 架构创新 > 规模堆叠:HRM 的分层循环架构 + 潜在空间推理,实现了超越 Transformer 的计算效率
- 开源赋能小团队:Apache-2.0 协议,让高校实验室和创业公司也能训练自有基础模型
推荐指数:⭐⭐⭐⭐⭐(满分 5 星)
适合人群:AI 研究员、创业公司、高校实验室、GPU 资源充足的个人开发者
立即体验:HRM-Text GitHub | 在线 Demo(HuggingFace)
数据截至 2026-05-23,最新信息请以官网为准。
参考文献:
- HRM-Text 论文:arXiv:2605.20613
- HRM 架构论文:TBA