【今日推荐 GLM-OCR】:智谱开源 OCR 精度全球第一,0.9B 参数却碾压所有竞品!
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../GLM-OCR-recommend.pptx../../GLM-OCR-recommend.mp4本文目录
【今日推荐 GLM-OCR】:智谱开源 OCR 精度全球第一,0.9B 参数却碾压所有竞品!
你有没有遇到过这样的痛点:一份复杂的 PDF 报告,扫描图里有表格、公式、印章,用 OCR 工具提取出来乱七八糟?智谱 AI 今天给出了答案——GLM-OCR,OmniDocBench V1.5 全球综合排名第一,仅 0.9B 参数,完全开源免费商用!



🚀 什么是 GLM-OCR?
GLM-OCR 是智谱 AI(ZhipuAI)开源的新一代多模态 OCR 模型,专为复杂文档理解而生。它基于 GLM-V 编码器-解码器架构,集成了 CogViT 视觉编码器 + 轻量跨模态连接器 + GLM-0.5B 语言解码器,采用独创的两阶段流水线:先用 PP-DocLayout-V3 做版面分析,再对各区域并行 OCR 识别。
项目于 2026 年 2 月开源,在 GitHub 上已收获 5,700+ Stars,今日单日新增超过 238 Stars,热度飙升!
核心亮点:在 OmniDocBench V1.5 基准测试中取得 94.62 分,综合排名全球第一,超越 MinerU、PaddleOCR 等所有主流竞品!
✨ 核心功能一览
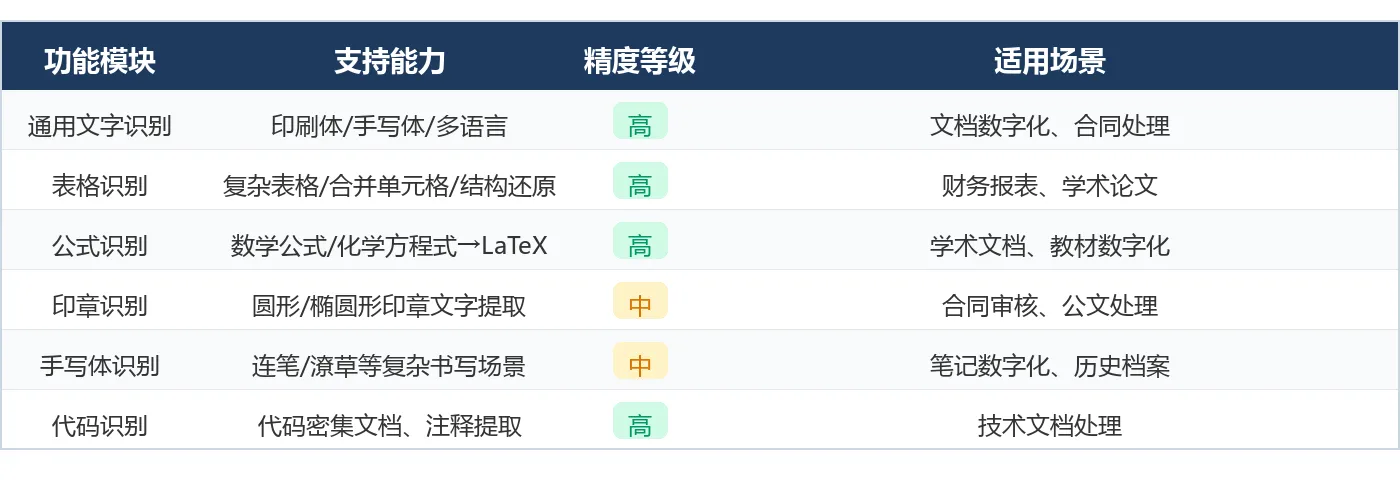
GLM-OCR 支持六大核心能力,覆盖企业级文档处理的方方面面:
- 通用文字识别:印刷体、手写体、中英文混排、多语言文档,一个模型全搞定
- 表格识别:精准还原复杂表格的行列结构、合并单元格,输出可直接导入 Excel
- 公式识别:数学公式、化学方程式直接转 LaTeX 代码,告别手动录入
- 印章识别:圆形/椭圆形印章文字一键提取,合同审核效率翻倍
- 手写体识别:适应连笔、潦草等复杂书写,历史档案数字化的利器
- 代码识别:代码密集文档、注释完整提取,技术文档处理专属优化
🏗️ 技术架构:两阶段流水线
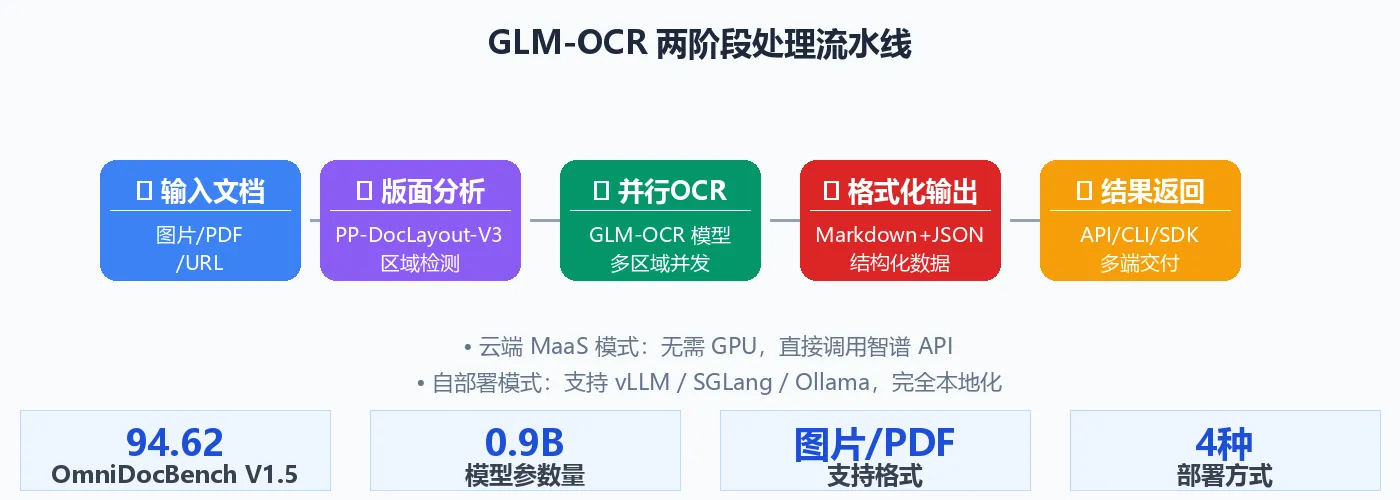
GLM-OCR 的两阶段设计是其高精度的秘密武器:
第一阶段 — 版面分析:使用 PP-DocLayout-V3 对文档进行区域检测,将页面分割为文本区域、表格区域、公式区域、图片区域等不同类型
第二阶段 — 并行识别:对各区域同时调用 GLM-OCR 模型进行并行 OCR,显著提升处理速度,同时保证各区域精度最优
这种设计使得 GLM-OCR 在处理复杂的混合版面文档时,性能远超传统端到端 OCR 方案。
🛠️ 快速上手:3 步跑通第一个示例
第一步:安装 SDK
# 最轻量安装(云端 MaaS 模式,无需 GPU)
pip install glmocr

# 自部署完整流水线(包含版面检测)
pip install "glmocr[selfhosted]"

# 启用 Flask 服务
pip install "glmocr[server]"
第二步:配置 API Key(MaaS 模式最快上手)
# config.yaml
pipeline:
  maas:
    enabled: true
    api_key: your-api-key  # 在 https://open.bigmodel.cn 免费获取
第三步:一行代码识别文档
from glmocr import parse

# 识别本地图片
result = parse("invoice.png")

# 识别 PDF(多页)
result = parse(["page1.png", "page2.png", "page3.png"])

# 识别网络图片
result = parse("https://example.com/document.png")

# 保存结果(自动生成 Markdown + JSON)
result.save(output_dir="./results")

# 直接打印 JSON 结构
print(result.json_result)
注意:MaaS 模式下完全无需 GPU,直接在笔记本上也能跑!如果需要本地部署,可以用 vLLM/SGLang/Ollama,参数仅 0.9B,一张消费级显卡轻松搞定。
💡 三大核心使用场景
场景一:企业合同 & 财务报表自动化处理
功能说明:GLM-OCR 能精准识别合同中的印章、手写签名、表格条款,将扫描件一键转为结构化数据,大幅减少人工录入工作量。
输入要求:扫描版合同 PDF 或拍照图片,支持多页批量处理
输出效果:Markdown 格式的文字内容 + JSON 格式的版面结构信息,表格直接还原为可编辑格式
适用场景:
- 法务部门批量处理合同存档
- 财务报表数字化,自动提取关键数字
- 企业档案管理系统智能录入
场景二:学术论文 & 教材公式识别
功能说明:GLM-OCR 的公式识别能力在业界处于领先地位,能将图片中复杂的数学公式、积分、矩阵等直接转换为标准 LaTeX 代码,支持化学方程式识别。
输入要求:包含公式的学术论文图片、教材页面、物理化学笔记
输出效果:标准 LaTeX 代码,可直接粘贴到 LaTeX 编辑器或 Overleaf 使用
适用场景:
- 学术论文数字化存档
- 教材公式快速录入 LaTeX 系统
- 科研数据整理与知识库构建
场景三:历史文档 & 手写笔记数字化
功能说明:专门针对手写体、连笔字、潦草书写进行了优化,能识别各种非标准书写格式,对历史档案、田野调查记录等场景尤为有效。
输入要求:手写笔记图片、历史文档扫描件、连笔书写样本
输出效果:结构化文字内容,支持中英文混排识别
适用场景:
- 历史档案馆数字化工程
- 研究人员田野笔记整理
- 医疗手写病历电子化
用户群体总结
- ✅ 企业开发者:需要高精度文档 OCR 的业务系统,通过 API 快速集成
- ✅ 数据处理团队:批量处理 PDF、扫描文档,提取结构化数据
- ✅ 学术研究者:论文公式识别、文献数字化
- ✅ AI/Agent 开发者:作为 Agent 工具链的 OCR 模块,支持 Skill 模式
- ❌ 不适合:对实时性要求极高(毫秒级)的场景,以及简单纯文本文档的低成本处理
🚀 四种部署方式,按需选择
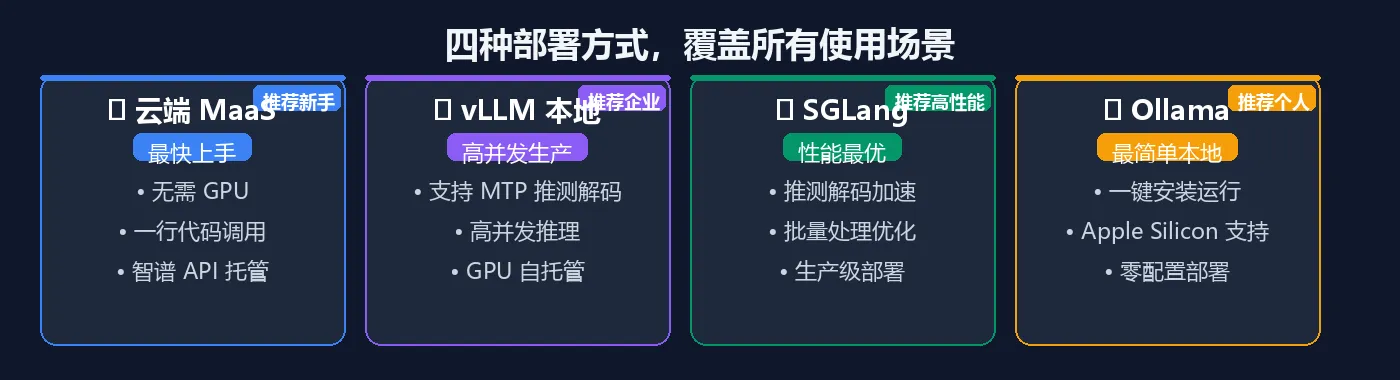
方式一:智谱 MaaS API(零门槛首选)
pipeline:
  maas:
    enabled: true
    api_key: your-api-key
无需 GPU,注册即用,适合快速验证和轻量级应用。
方式二:vLLM 本地部署(生产推荐)
# 启动 vLLM 服务(支持 MTP 推测解码,速度更快)
vllm serve zai-org/GLM-OCR \
  --port 8080 \
  --speculative-config '{"method": "mtp", "num_speculative_tokens": 3}' \
  --served-model-name glm-ocr
方式三:Ollama 一键运行(个人开发者)
# 使用 Ollama 极简部署
ollama run glm-ocr
详见官方 Ollama 部署指南
方式四:Flask 服务 + 远程客户端
# 服务端(GPU 机器)
pip install "glmocr[server]"
python -m glmocr.server

# 客户端调用(无需 GPU)
curl -X POST http://localhost:5002/glmocr/parse \
  -H "Content-Type: application/json" \
  -d '{"images": ["./document.png"]}'
📊 与竞品对比
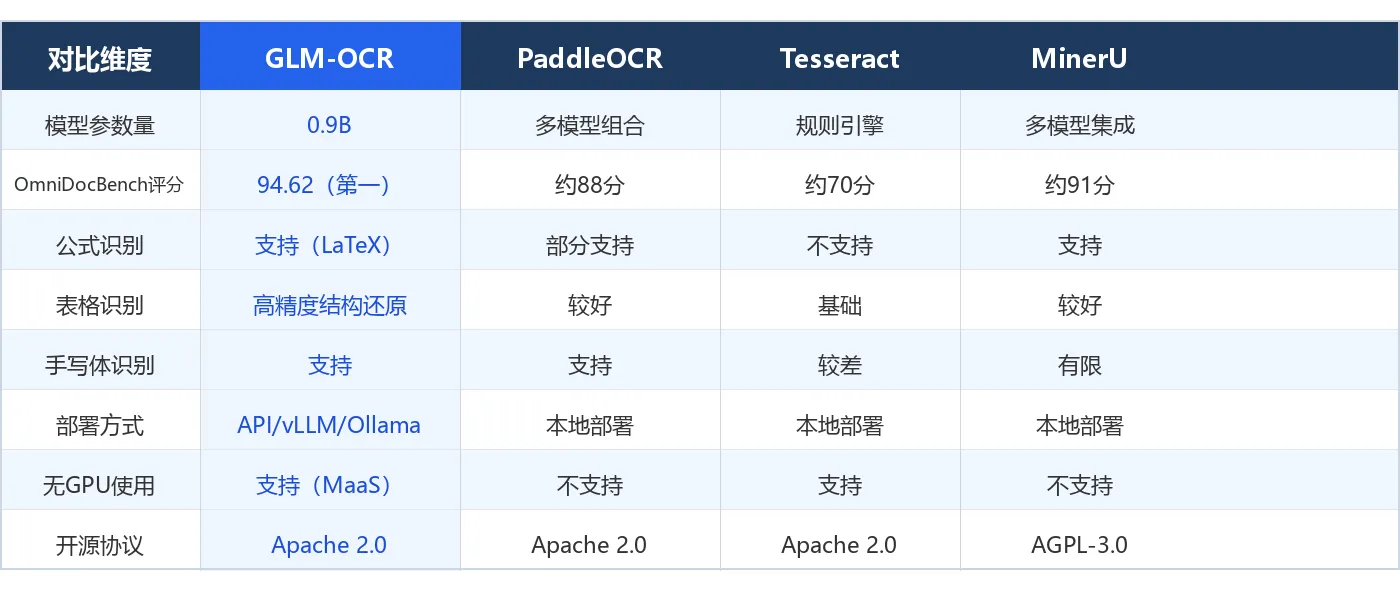
GLM-OCR 相比其他主流 OCR 方案有以下显著优势:
- 精度最高:OmniDocBench V1.5 综合得分 94.62,全球第一
- 最轻量:0.9B 参数,是行业同等精度模型中最小的
- 部署最灵活:支持 MaaS(无 GPU)/ vLLM / SGLang / Ollama 四种方式
- 功能最全:表格/公式/印章/手写体一体化,无需多模型拼接
特别注意:GLM-OCR 同时支持无 GPU 的云端调用和有 GPU 的本地部署,真正做到零门槛到高性能的全覆盖。
💰 使用成本
GLM-OCR 完全开源,模型权重和代码均可免费商用:
- 开源协议(代码):Apache License 2.0
- 模型协议:MIT License
- 自部署:完全免费,仅需承担 GPU 成本
- MaaS 云端 API:在智谱开放平台按量计费,新用户可免费试用
下载地址:
- 🤗 Hugging Face
- 🤖 ModelScope(国内推荐,速度快)
💡 福利:ModelScope 国内下载无需代理,速度极快!新用户注册智谱开放平台还有免费额度。
🎯 总结
GLM-OCR 是目前开源 OCR 领域精度最高、参数最小、部署最灵活的方案。智谱 AI 凭借 GLM-V 多模态架构的深厚积累,配合创新的两阶段流水线设计,让这个仅 0.9B 的小模型在全球 OCR 基准上登顶第一。
无论你是需要处理企业文档的开发者,还是做学术论文数字化的研究者,GLM-OCR 都值得成为你工具箱里的必备工具。
推荐指数: ⭐⭐⭐⭐⭐(满分5星)
适合人群: 企业文档处理开发者、AI Agent 构建者、数据处理工程师、学术研究者
GitHub 仓库: zai-org/GLM-OCR
技术报告: GLM-OCR Technical Report (arXiv:2603.10910)
本文由 AI 辅助生成,数据截至 2026年4月9日,最新信息请以官网为准。