🔥【今日推荐 FlashQLA】:通义千问开源线性注意力加速器,前向 2-3x、反向 2x,零精度损失!
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../FlashQLA-recommend.pptx../../FlashQLA-recommend.mp4本文目录
🔥【今日推荐 FlashQLA】:通义千问开源线性注意力加速器,前向 2-3x、反向 2x,零精度损失!
阿里 QwenLM 团队开源的高性能线性注意力内核库,基于 TileLang 构建,在 NVIDIA Hopper GPU 上实现前向 2-3x、反向 2x 的性能飞跃,零精度损失。
🚀 什么是 FlashQLA?
FlashQLA(Flash Qwen Linear Attention)是阿里通义千问(QwenLM)团队开源的高性能线性注意力内核库,专为 Qwen3.5/Qwen3.6 系列模型的 GDN(Gated Delta Rule)Chunked Prefill 操作优化。
传统 Transformer 的注意力机制是 O(n^2) 复杂度,而线性注意力将复杂度降至 O(n),在长序列处理中优势巨大。但线性注意力的工程实现远比理论复杂——FlashQLA 正是解决这个"最后一公里"问题的关键工具。
核心定位:Qwen 官方出品的线性注意力加速方案,前向 2-3x、反向 2x 加速,零精度损失


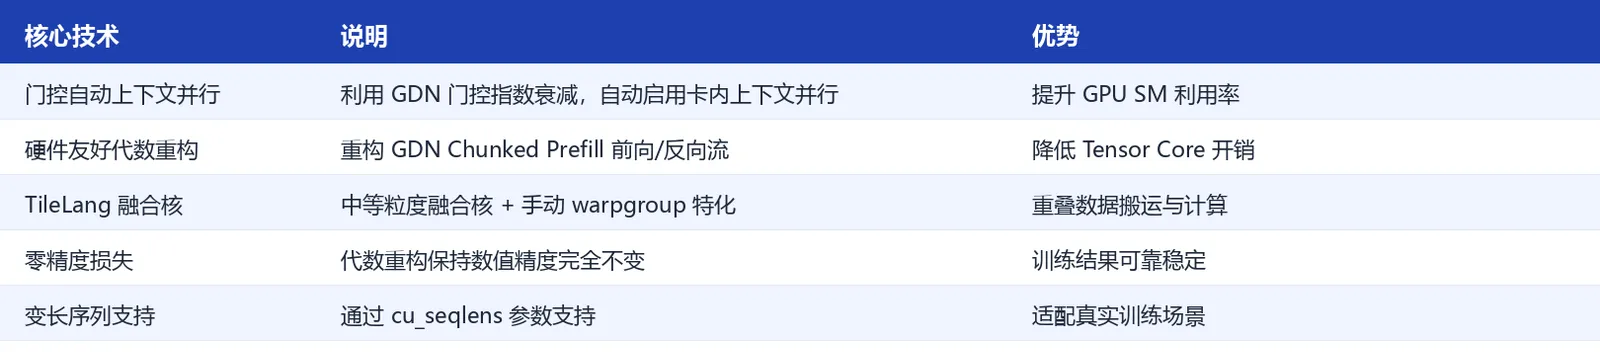
✨ 核心功能一览
🛠️ 快速上手:5 分钟跑通示例
安装
# 克隆仓库
git clone https://github.com/QwenLM/FlashQLA.git
cd FlashQLA

# 安装(需要 NVIDIA Hopper GPU,即 H100/H200)
pip install -v .

# 可选:安装验证依赖
pip install flash_linear_attention==0.5.0

# 可选:安装基准测试依赖
pip install flash_linear_attention==0.5.0 flashinfer-python==0.6.9
环境要求
- GPU:NVIDIA Hopper(SM90)及以上,即 H100 / H200
- CUDA:12.8+
- PyTorch:2.8+
高级 API 示例
import torch
from flash_qla import chunk_gated_delta_rule

# 输入张量
# q: [B, T, H_q, K]  查询
# k: [B, T, H_q, K]  键
# v: [B, T, H_v, V]  值
# g: [B, T, H_v]     门控
# beta: [B, T, H_v]  衰减因子

o, final_state = chunk_gated_delta_rule(
    q=q,
    k=k,
    v=v,
    g=g,
    beta=beta,
    scale=scale,
    initial_state=initial_state,   # 可选,初始状态
    output_final_state=True,
    cu_seqlens=cu_seqlens,         # 可选,变长序列
)
底层 API(自定义训练循环)
from flash_qla import (
    chunk_gated_delta_rule_fwd,
    chunk_gated_delta_rule_bwd
)

# 前向传播
g, A, o, h, final_state = chunk_gated_delta_rule_fwd(
    q, k, v, g, beta,
    scale=scale,
    initial_state=h0,
    cu_seqlens=cu_seqlens
)

# 反向传播
dq, dk, dv, db, dg, dh0 = chunk_gated_delta_rule_bwd(
    q, k, v, g, beta, A, do,
    dht=dht,
    scale=scale,
    initial_state=h0,
    cu_seqlens=cu_seqlens
)
注意:FlashQLA 目前仅支持 NVIDIA Hopper(H100/H200)及以上架构 GPU,需要 CUDA 12.8+ 和 PyTorch 2.8+
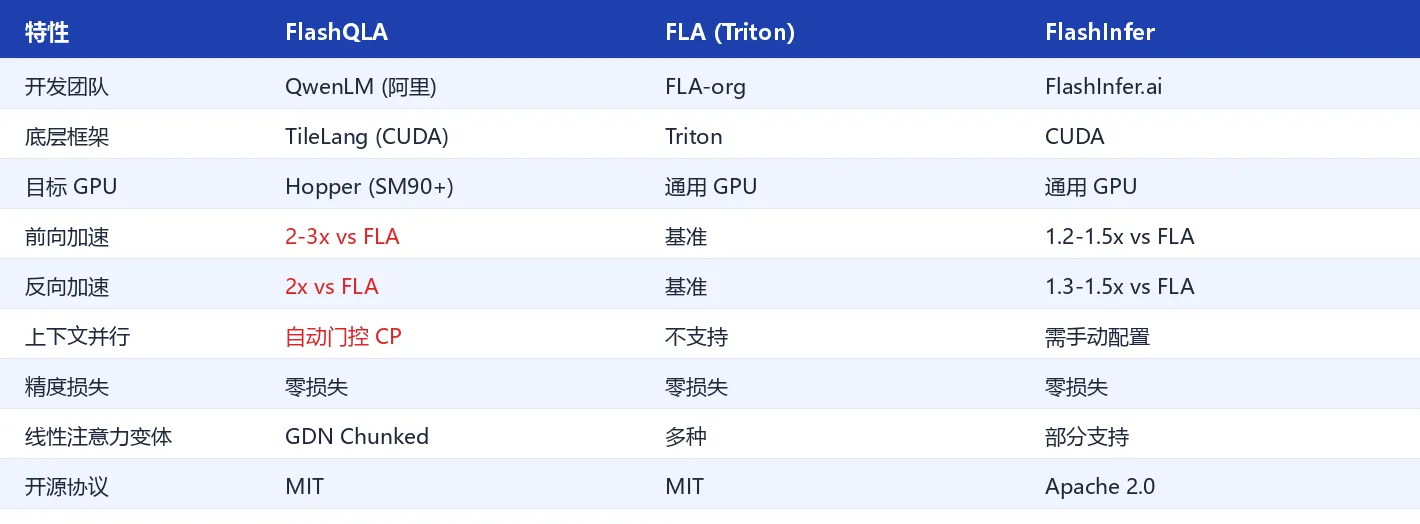
📊 与竞品对比
💡 适用场景
性能基准测试
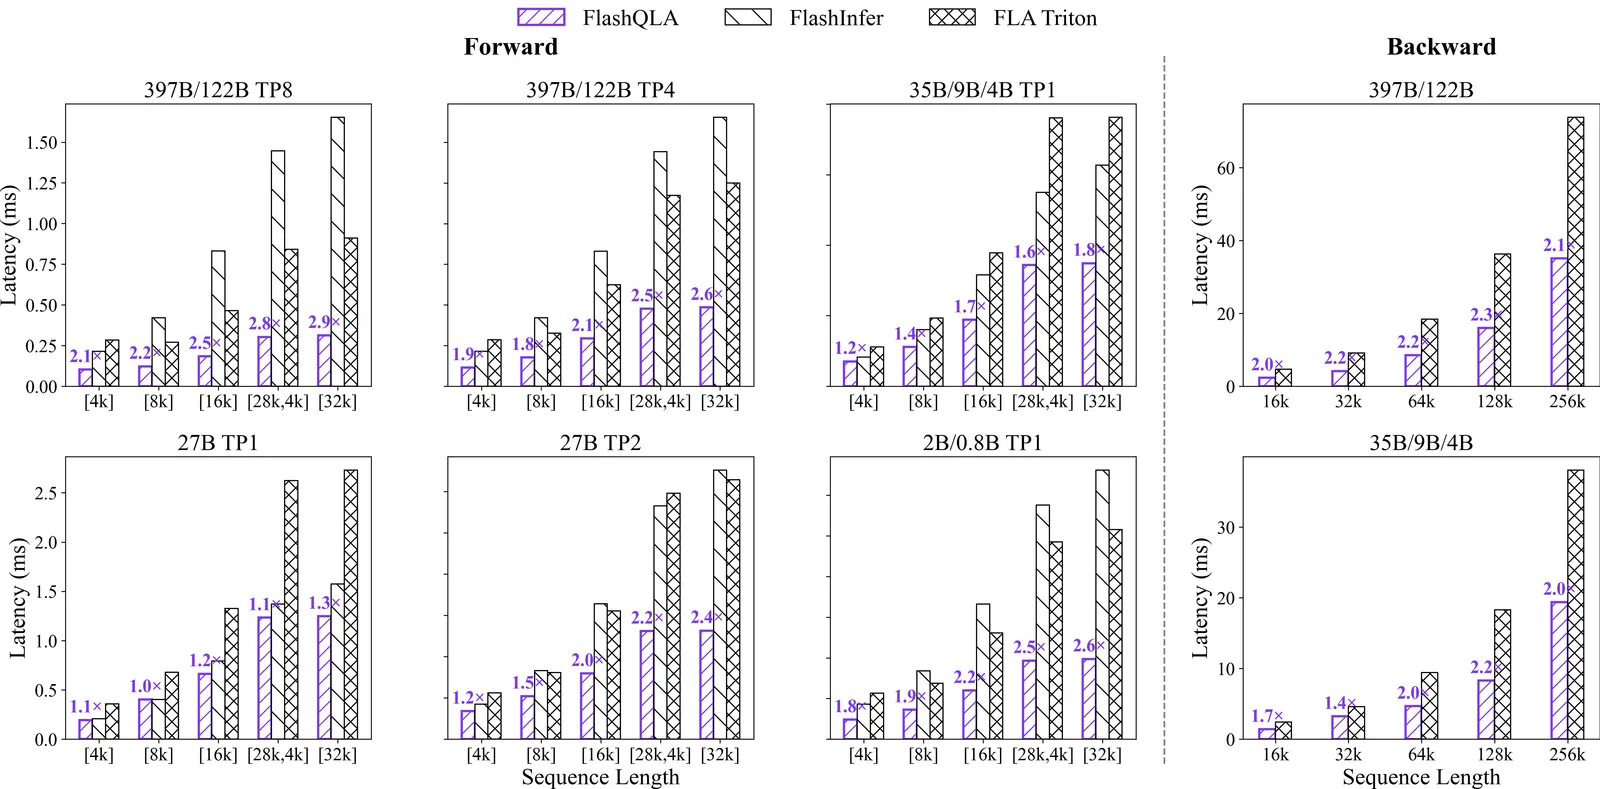
功能说明:FlashQLA 在多个模型配置和 TP(张量并行)设置下,展示了显著的性能优势。基准测试在 H200 GPU 上进行,对比了 FLA Triton 内核和 FlashInfer。
测试配置:Qwen3.5/Qwen3.6 系列头维度 h_k,v 取值 {64, 48, 32, 24, 16, 8},对应 TP1 到 TP8 设置
性能亮点:
- 前向传播:比 FLA Triton 内核快 2-3 倍
- 反向传播:比 FLA Triton 内核快 2 倍
- 支持变长序列处理
FlashQLA 架构图
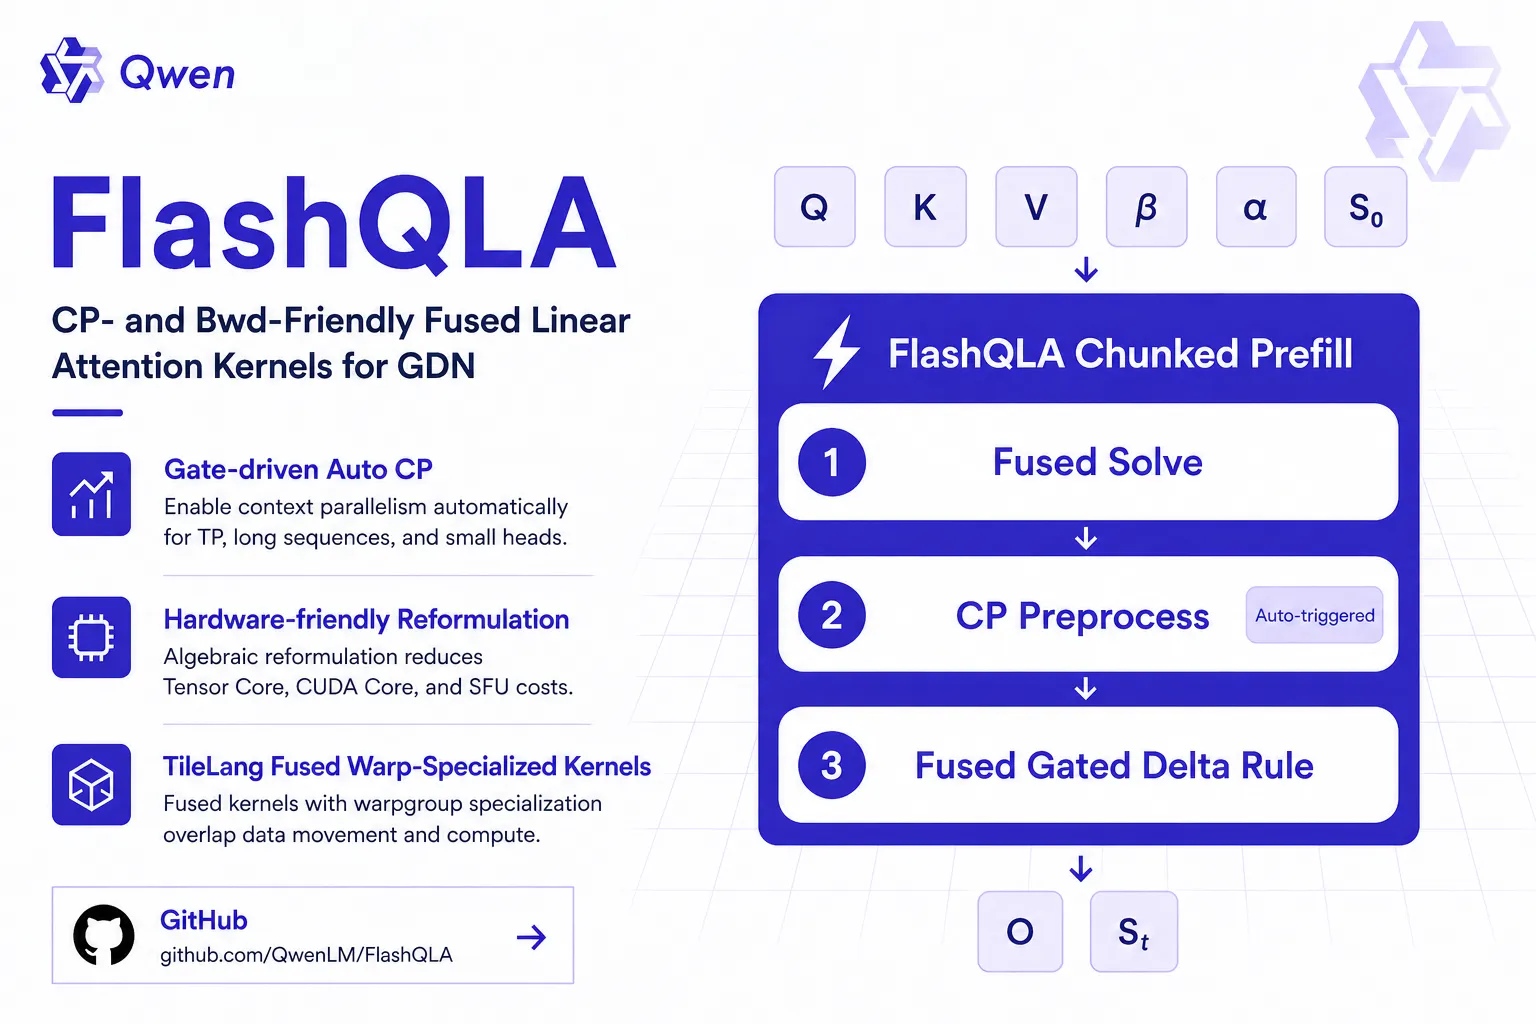
功能说明:FlashQLA 的技术架构展示,包括门控自动上下文并行、硬件友好代数重构、TileLang 融合核三大核心技术。
设计理念:采用中等粒度融合核策略,避免全分解独立核的单体融合核的弊端,通过手动 warpgroup 特化实现数据搬运、Tensor Core 计算和 CUDA Core 计算的重叠执行。
适用场景:大语言模型预训练、长序列推理、边缘端 Agent 推理、张量并行部署
用户群体总结
- ✅ 大模型训练团队:Qwen3.5/Qwen3.6 系列模型训练,直接替代 FLA 内核,训练速度翻倍
- ✅ AI 基础设施开发者:构建高性能推理服务,降低延迟和成本
- ✅ 学术研究者:线性注意力机制研究,零精度损失的设计保证实验可靠性
- ✅ 边缘端 AI 开发者:资源受限场景下的高效 Agent 推理
- ❌ 不适合:无 Hopper GPU 的个人开发者(暂不支持消费级 GPU)
💰 定价方案
FlashQLA 是完全免费开源项目。
开源协议: MIT License
MIT 开源协议,可自由用于商业项目,无任何限制
🎯 总结
FlashQLA 是阿里 QwenLM 团队精心打造的线性注意力加速方案,通过三大核心技术(门控自动上下文并行、硬件友好代数重构、TileLang 融合核),在 NVIDIA Hopper GPU 上实现了前向 2-3x、反向 2x 的性能飞跃,且保持零精度损失。
虽然目前仅支持 Hopper GPU,但对于拥有 H100/H200 的训练集群来说,这是一款"即插即用"的性能倍增器。考虑到 Qwen 系列模型的广泛应用,FlashQLA 的实用价值极高。
推荐指数: 4.5/5(满分5星,扣分仅因 GPU 门槛较高)
适合人群: 大模型训练工程师、AI 基础设施团队、线性注意力研究者
立即体验: QwenLM/FlashQLA
GitHub 仓库: QwenLM/FlashQLA
数据截至 2026-04-29,最新信息请以官网为准。