DeepSpec
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../DeepSpec-recommend.pptx../../DeepSpec-recommend.mp4本文目录
📌 核心价值:让大模型推理提速 60-85%,DeepSeek 把推测解码训练+评估全栈工具一次性开源了。
自从 DeepSeek-V3.1 把价格打到「一天一杯奶茶钱」之后,AI 圈就一直在追问同一个问题:凭什么能这么便宜?现在答案揭晓了——DeepSeek 正式开源了 DeepSpec(GitHub Trending 6,729 ⭐),一口气把推测解码(Speculative Decoding)的训练、评估、9 套预训练权重、9 个评测基准全部公开。
🚀 什么是 DeepSpec?
DeepSpec 是 DeepSeek 团队在 2026 年 6 月底正式开源的「推测解码全栈工具库」,目标是让你也能为自家大模型训练一个「草稿模型」,把推理速度直接拉高 2-3 倍,运营成本砍半。
为什么这件事重要?在大模型落地的所有环节里,推理(Inference)几乎占用了 80% 以上的算力预算。传统大模型生成属于自回归串行输出——一次只能生成 1 个 token,下一个 token 必须等前一个算完,GPU 算力利用率长期低于 20%。
而 DeepSpec 集成的核心算法 DSpark(DeepSeek 自研,已写入 arxiv 2607.05147 论文)已经在 DeepSeek-V4 线上生产环境跑通:
- 用户响应速度提升 60-85%
- 引擎吞吐量提升 51%
- 高并发场景下吞吐量甚至暴涨 661%
这不是「理论加速」,是DeepSeek 自己万卡集群在用的同款技术。


核心定位:DeepSpec 不是单一模型,而是一套完整的「推测解码训练+评估工具链」——你能用它训练自己的 draft model,也能用现成的 9 个 HuggingFace checkpoint 直接给自己的 Qwen3 加速。
✨ 核心机制:让小模型「猜」,大模型「验」
很多读者第一次听说「推测解码」会一脸懵,我用一个职场类比讲清楚:
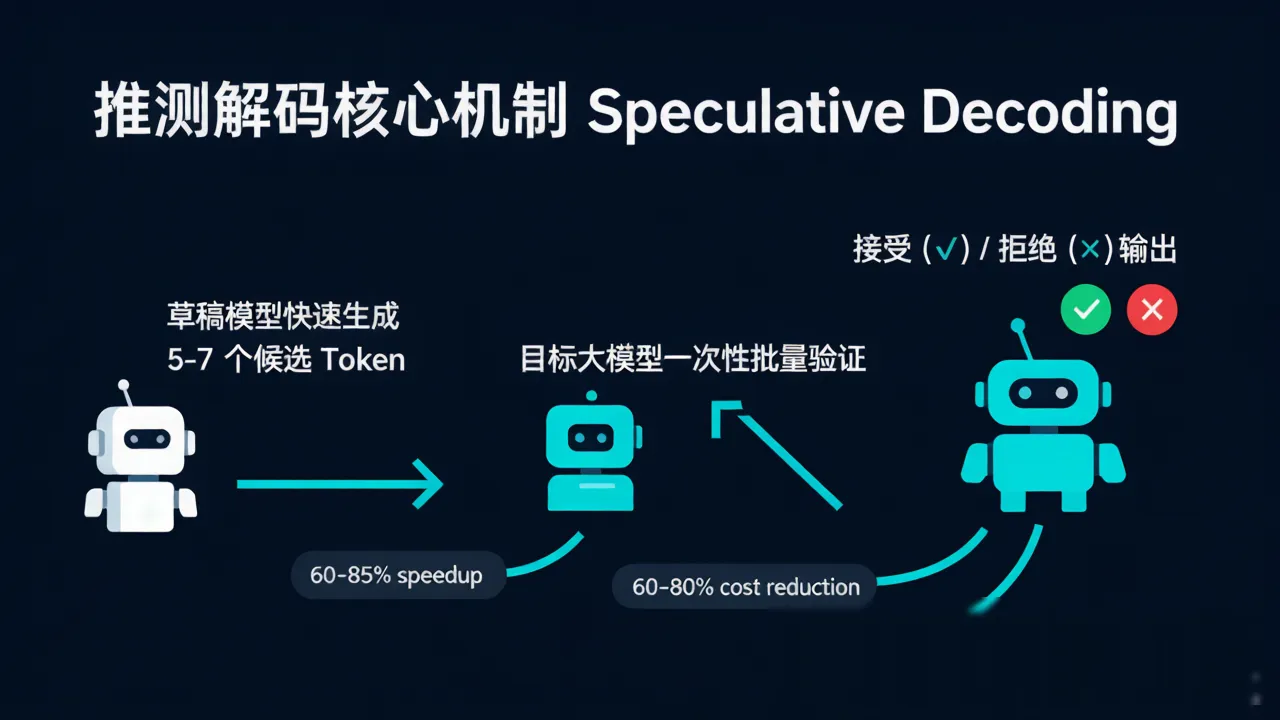
让实习生(Draft Model)先写 5-7 份草稿,老板(Target Model)一次批量签字。
具体流程三步走:
- 草稿阶段:一个参数量只有目标大模型 1/10 的小模型(draft model),用极快的速度一次生成 5-7 个候选 token。
- 验证阶段:目标大模型把这一批 token 打包成一个 batch,一次前向传播就完成验证——因为矩阵乘法一次算 7 个 token 和一次算 1 个 token,GPU 耗时差距远小于 7 倍。
- 筛选输出:通过拒绝采样(Rejection Sampling)保证输出分布与原大模型完全一致(数学上无损),被接受的 token 直接输出,被拒绝的回滚让大模型重写。
关键洞察:只要草稿模型的「命中率」足够高,整体推理速度就能成倍提升。而 DeepSpec 干的事,就是把这套「草稿模型训练 + 命中率评估」的全流程标准化。
✨ 三大算法一站式集成
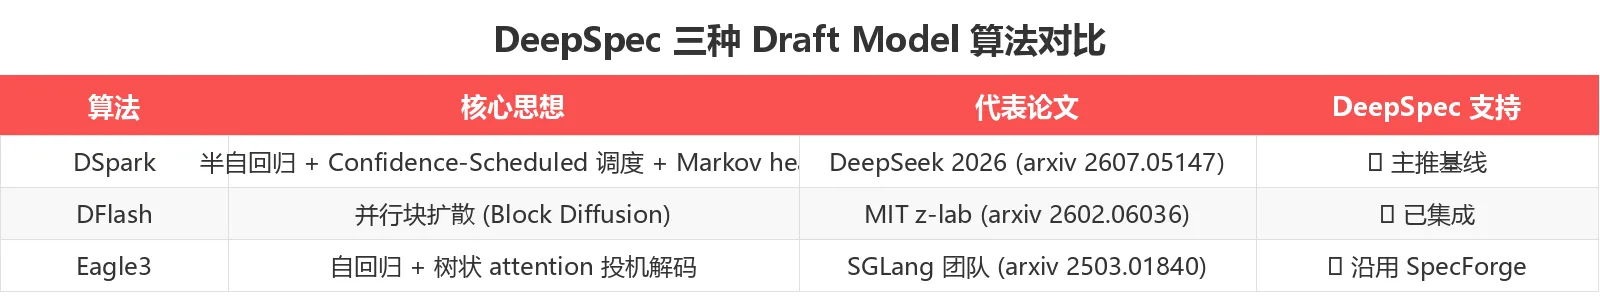
DeepSpec 最狠的地方是一次性把当前学术界/工业界三大主流 draft model 算法全部集成——你不用分别去 GitHub 找三套仓库、分别踩三套依赖。
| 算法 | 出身 | 一句话核心 | 适用场景 |
|---|---|---|---|
| DSpark | DeepSeek 2026 自研 | 半自回归 + Confidence-Scheduled 调度 + Markov head | 高并发生产环境、DeepSeek-V4 同款 |
| DFlash | MIT z-lab | 并行块扩散(Block Diffusion) | 单卡本地、低并发场景 |
| Eagle3 | SGLang 团队 | 自回归 + 树状 attention 投机解码 | 多候选探索、灵活度优先 |
重点:DSpark 配合置信度调度,让高并发时也不会因为「草稿太烂」反而拖累系统——这是 DeepSeek 线上能跑到 661% 吞吐暴涨的核心原因。
🛠️ 5 分钟跑通示例
第一步:环境准备
git clone https://github.com/deepseek-ai/DeepSpec.git
cd DeepSpec
python -m pip install -r requirements.txt
硬件要求:默认配置假设单节点 8 张 GPU(≥ A100/H100),如果只有少量显卡,修改 CUDA_VISIBLE_DEVICES 即可。
第二步:拉取预训练权重(跳过训练也能用)
from huggingface_hub import snapshot_download

# 下载 DSpark 适配 Qwen3-8B 的草稿模型
draft_path = snapshot_download(
    repo_id="deepseek-ai/dspark_qwen3_8b_block7",
    local_dir="./draft_model"
)
print(f"草稿模型已下载到: {draft_path}")
第三步:跑评测(看命中率到底能加速多少)
# 设置目标模型 + 草稿模型路径
export target_name_or_path=Qwen/Qwen3-8B
export draft_name_or_path=./draft_model

bash scripts/eval/eval.sh
输出会列出 9 个基准的「接受率」和「加速比」——比如 gsm8k 接受率 78% 加速 2.3x、humaneval 接受率 82% 加速 2.5x。
第四步:接入 vLLM 直接上线(已合并到 nightly build)
# vLLM 已支持 DSpark(PR #46995 已合并)
vllm serve Qwen/Qwen3-8B \
  --speculative-model deepseek-ai/dspark_qwen3_8b_block7 \
  --num-speculative-tokens 5
注意:DeepSpec 的目标 cache 准备阶段默认要 38TB 存储(Qwen3-4B 配置)——大团队用 S3 / OSS 解决,小团队建议用「拉现成 checkpoint + 直接推理」的方式绕过。
🎁 9 个 HuggingFace 预训练 Checkpoint
这是 DeepSpec 最「慷慨」的部分——9 套开箱即用的 draft model 权重直接发到 HuggingFace,覆盖 4 个目标模型 × 3 种算法:
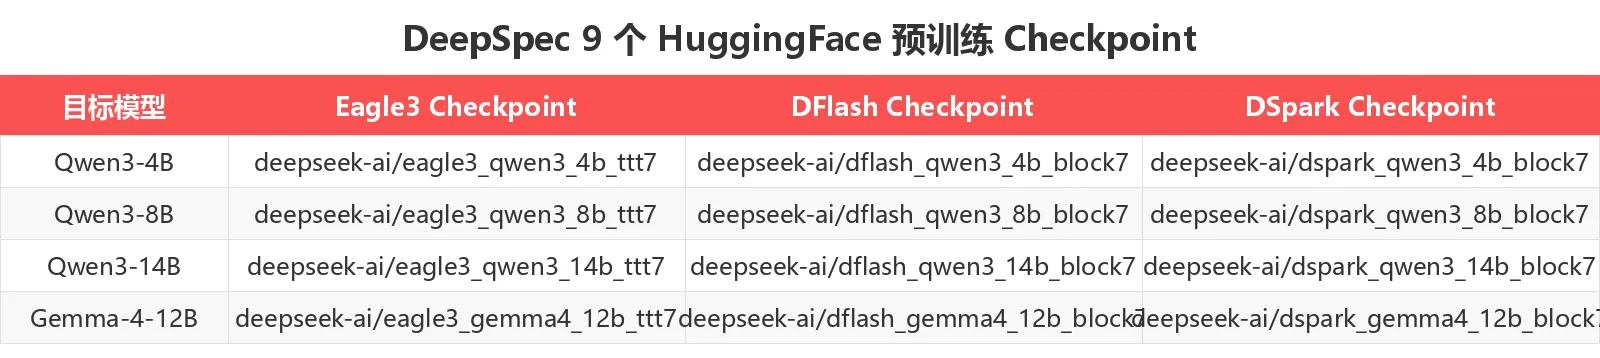
每个权重都是论文 Table 1 复现实验直接用的版本,使用 open-perfectblend 数据集 + 对应 target model 在 non-thinking 模式训练。只要你的目标模型在列表里,直接拉下来就能用。
📊 9 个评测基准
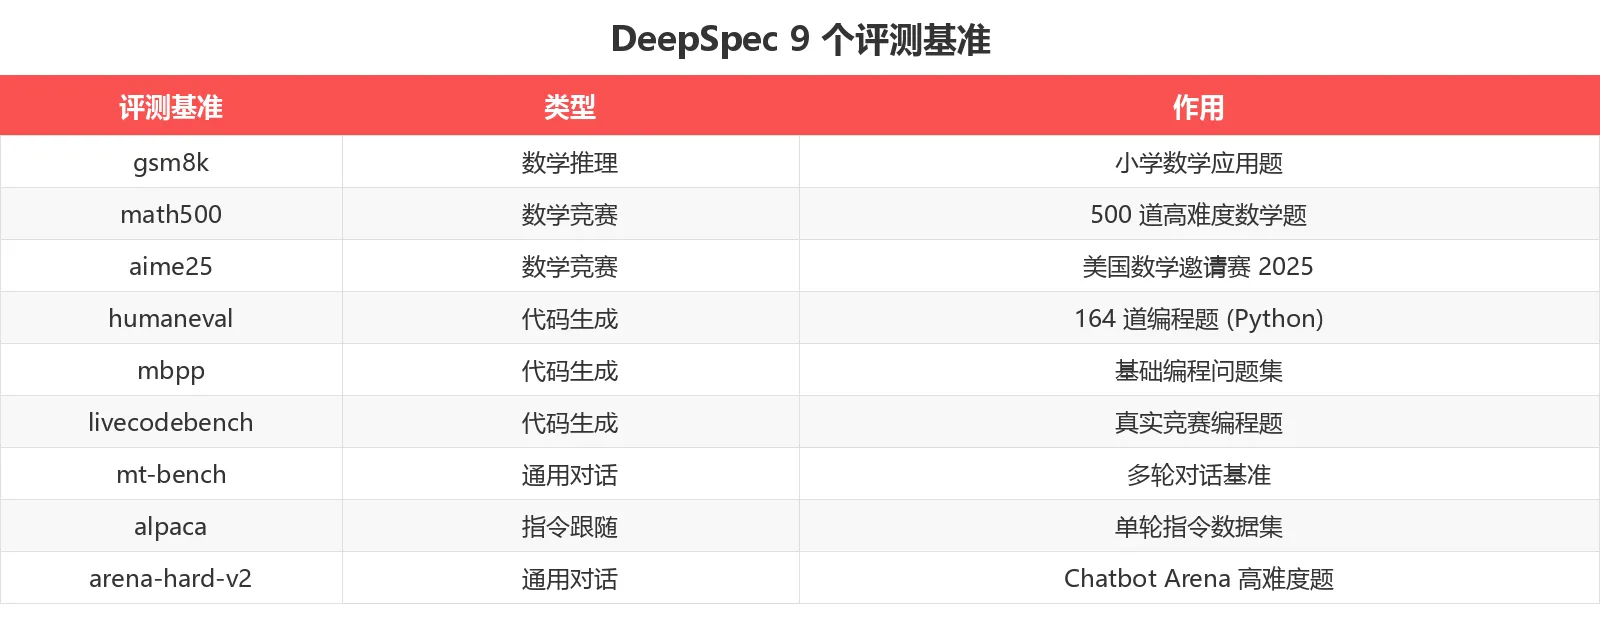
DeepSpec 不是「跑分专用」仓库,它内置 9 个跨任务基准,确保你训练出来的草稿模型不偏科: