AnyCrawl
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../AnyCrawl-recommend.pptx../../AnyCrawl-recommend.mp4本文目录
🔥 AnyCrawl:AI时代的高性能爬虫框架,让网页数据直接变成LLM就绪格式
一个基于Node.js/TypeScript的多引擎爬虫工具,支持Cheerio/Playwright/Puppeteer三种渲染引擎,原生支持SERP爬取和LLM结构化数据提取,让AI应用的数据采集变得简单高效。
🚀 什么是 AnyCrawl?
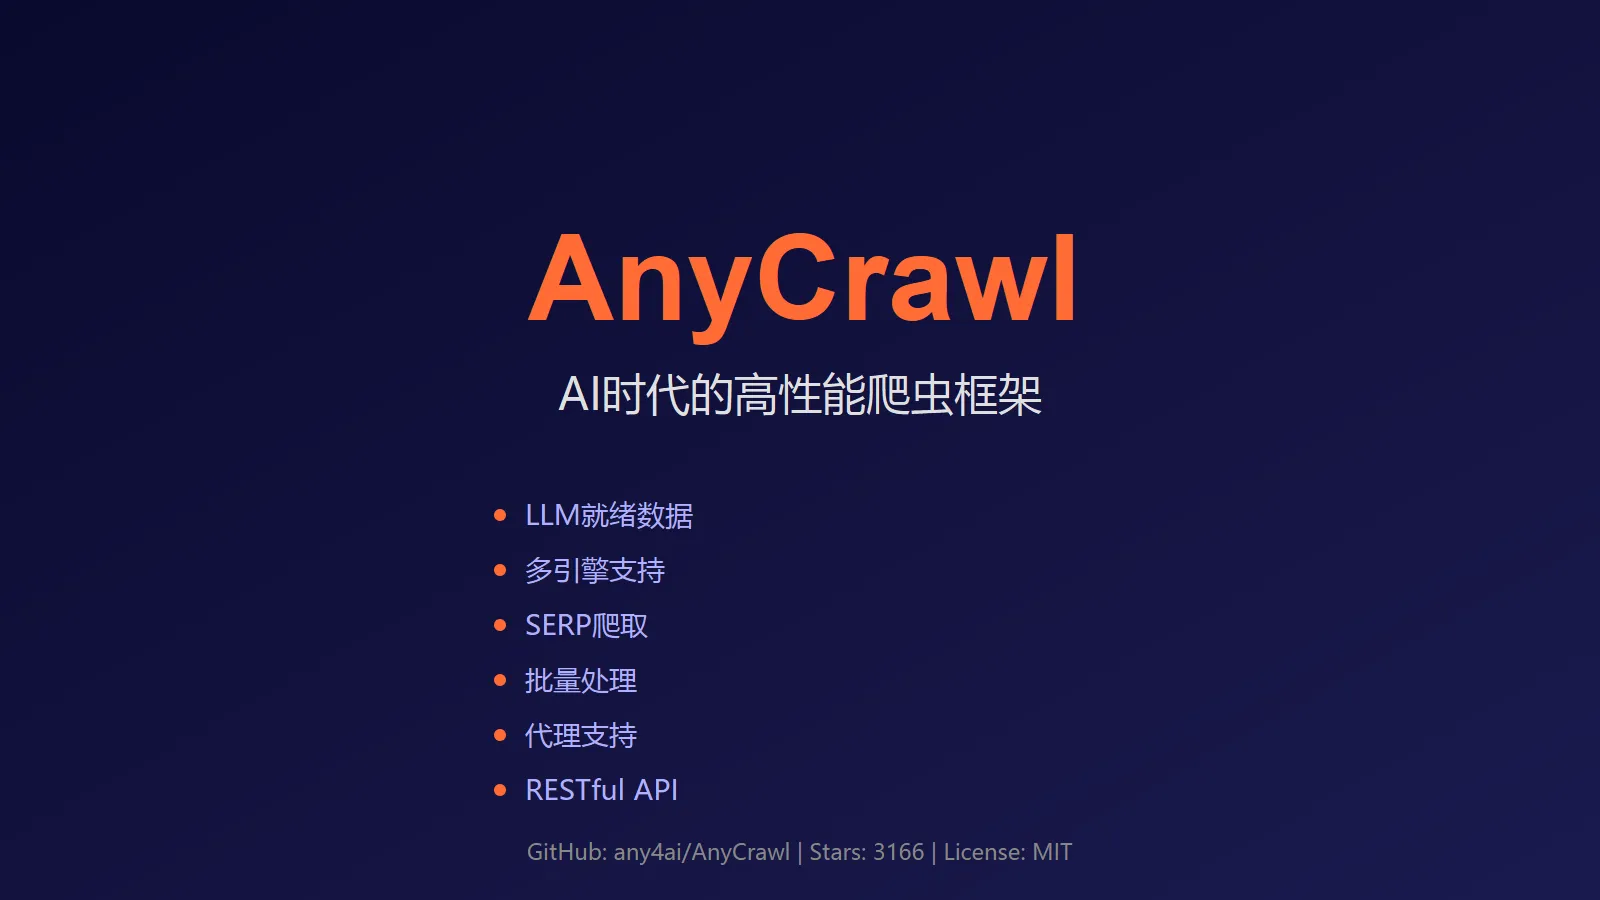
AnyCrawl 是一个专为AI时代设计的高性能网络爬虫和数据抓取工具。它不是传统的爬虫框架,而是为LLM应用量身定制的数据管道——你给它一个URL,它直接返回Markdown、JSON等LLM友好格式,甚至支持按照你定义的JSON Schema自动提取结构化数据。


核心定位: 直接将网页内容转换为LLM就绪数据,无需手动解析HTML
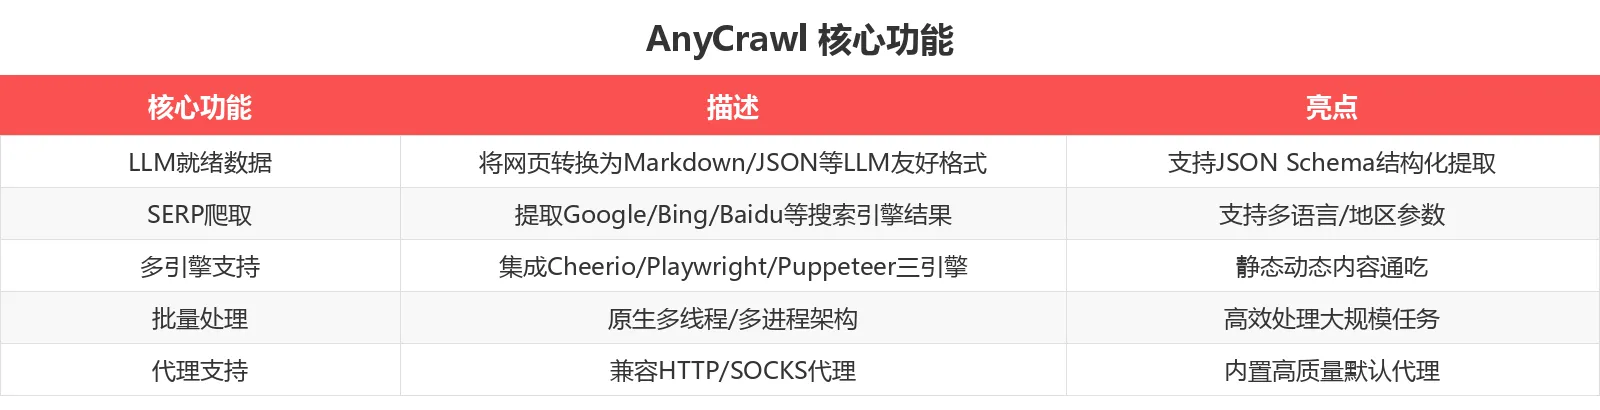
AnyCrawl 集成了三大爬虫引擎(Cheerio/Playwright/Puppeteer),既能快速处理静态页面,也能应对复杂的JavaScript渲染内容,还支持从Google、Bing、Baidu等搜索引擎提取结构化SERP结果。原生多线程/多进程架构,轻松应对大规模批量处理任务。
✨ 核心功能一览
🛠️ 快速上手:5 分钟跑通示例
安装(自托管)
AnyCrawl 支持Docker部署和本地开发两种模式:
# 方法1:Docker部署(推荐)
git clone https://github.com/any4ai/AnyCrawl.git
cd AnyCrawl
docker compose up -d

# 方法2:本地开发(需要pnpm)
git clone https://github.com/any4ai/AnyCrawl.git
cd AnyCrawl
pnpm install
pnpm dev
核心功能示例
示例1:单页抓取(转换为Markdown)
curl -X POST https://api.anycrawl.dev/v1/scrape \
  -H 'Content-Type: application/json' \
  -H 'Authorization: Bearer YOUR_ANYCRAWL_API_KEY' \
  -d '{
    "url": "https://example.com",
    "engine": "cheerio",
    "formats": ["markdown", "html"]
  }'
返回结果:直接获取LLM友好的Markdown格式,无需手动解析HTML。
示例2:LLM驱动的结构化数据提取
curl -X POST "https://api.anycrawl.dev/v1/scrape" \
  -H "Authorization: Bearer YOUR_ANYCRAWL_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "url": "https://example.com",
    "json_options": {
      "schema": {
        "type": "object",
        "properties": {
          "company_mission": { "type": "string" },
          "is_open_source": { "type": "boolean" },
          "employee_count": { "type": "number" }
        },
        "required": ["company_mission"]
      }
    }
  }'
亮点:按照JSON Schema自动提取结构化数据,直接喂给LLM使用
示例3:全站遍历爬取
curl -X POST https://api.anycrawl.dev/v1/crawl \
  -H 'Content-Type: application/json' \
  -H 'Authorization: Bearer YOUR_ANYCRAWL_API_KEY' \
  -d '{
    "url": "https://example.com",
    "engine": "playwright",
    "max_depth": 2,
    "limit": 10,
    "strategy": "same-domain"
  }'
示例4:SERP搜索结果提取
curl -X POST https://api.anycrawl.dev/v1/search \
  -H 'Content-Type: application/json' \
  -H 'Authorization: Bearer YOUR_ANYCRAWL_API_KEY' \
  -d '{
    "query": "AnyCrawl tutorial",
    "limit": 10,
    "engine": "google",
    "lang": "en"
  }'
注意:AnyCrawl提供官方托管API(https://api.anycrawl.dev),也支持自托管部署,按需选择
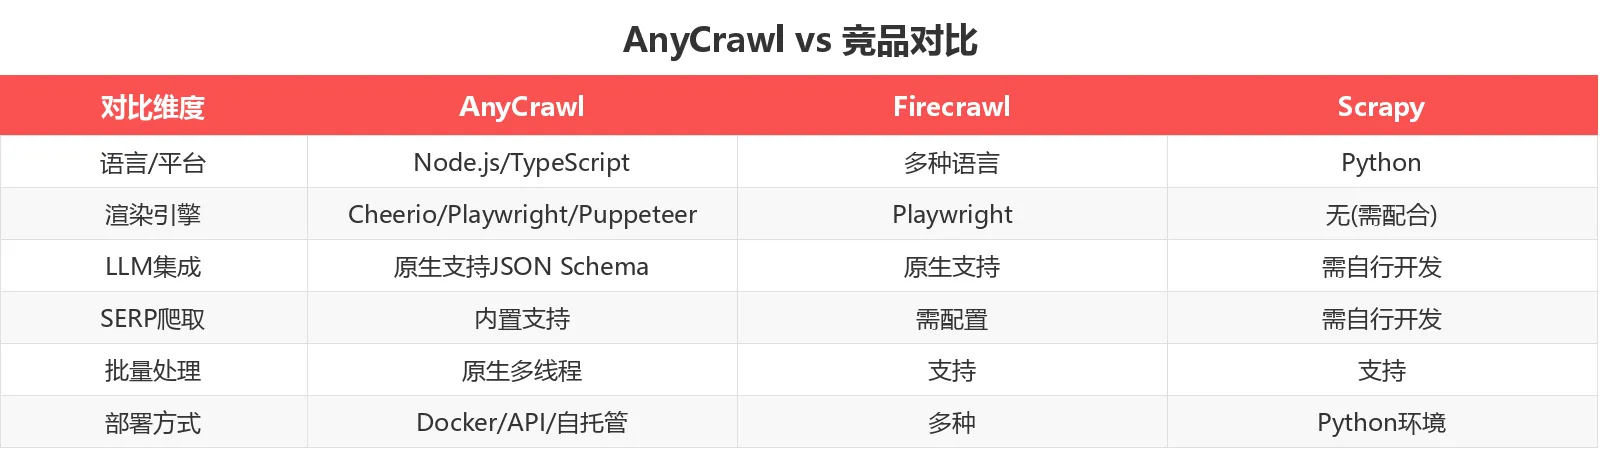
📊 与竞品对比
💡 适用场景
场景1:RAG应用的数据采集
功能说明:将网页内容转换为Markdown/JSON格式,直接用于RAG(检索增强生成)应用的知识库构建。
输入要求:目标网页URL,可选指定渲染引擎(cheerio/playwright/puppeteer)
输出效果:LLM友好的Markdown文本,或按照JSON Schema提取的结构化数据
适用场景:
- ✅ 企业知识库构建:自动抓取官网文档、帮助中心内容
- ✅ AI聊天机器人:实时获取最新网页信息并转换为LLM输入
- ✅ 内容聚合平台:批量抓取多个来源的内容并统一格式
场景2:搜索引擎结果页(SERP)爬取
功能说明:从Google、Bing、Baidu等搜索引擎提取结构化搜索结果,支持多语言/地区参数。
输入要求:搜索关键词、搜索引擎选择、结果数量限制
输出效果:结构化的搜索结果JSON,包含标题、URL、摘要等字段
适用场景:
- ✅ SEO监控:定期抓取关键词排名变化
- ✅ 竞品分析:监控竞品在搜索结果中的表现
- ✅ 市场调研:批量获取行业相关搜索结果
场景3:大规模批量爬虫任务
功能说明:原生多线程/多进程架构,支持大规模批量爬取任务,内置代理支持和缓存机制。
输入要求:URL列表、并发参数、代理配置(可选)
输出效果:批量抓取的网页内容,支持多种输出格式(Markdown/HTML/JSON)
适用场景:
- ✅ 电商价格监控:批量抓取竞品价格信息
- ✅ 新闻聚合:定时抓取多个新闻网站的最新内容
- ✅ 学术研究:批量下载论文页面并提取元数据
用户群体总结
- ✅ AI应用开发者:需要为LLM/RAG应用采集网页数据(推荐指数:⭐⭐⭐⭐⭐)
- ✅ 数据分析师:快速采集网络数据用于分析和建模
- ✅ SEO从业者:监控搜索引擎排名和竞品表现
- ✅ 电商运营:价格监控、竞品分析、内容聚合
- ❌ 纯前端新手:需要一定Node.js/TypeScript基础
💰 定价方案
AnyCrawl 采用 MIT 协议开源,完全可以免费使用和修改。
官方托管API:
- 提供免费试用额度(具体参考官网)
- 付费套餐按请求量计费,适合不想自建服务器的用户
自托管部署:
- 完全免费,仅需承担服务器成本
- 支持Docker一键部署,降低运维门槛
开源协议: MIT
💡 新用户福利:官方提供在线Playground(https://anycrawl.dev/playground),无需安装即可测试所有功能
🎯 总结
AnyCrawl 是为AI时代量身定制的高性能爬虫框架,将网页数据直接转换为LLM就绪格式是其最大亮点。三大渲染引擎、原生多线程架构、内置SERP爬取和LLM结构化数据提取,让数据采集变得前所未有的简单高效。
推荐指数: ⭐⭐⭐⭐⭐(满分5星)
适合人群: AI应用开发者、数据分析师、SEO从业者、电商运营
立即体验: AnyCrawl 官网
GitHub 仓库: any4ai/AnyCrawl
文档地址: docs.anycrawl.dev
在线测试: anycrawl.dev/playground
数据截至 2026-05-19,最新信息请以官网为准。