4DAnyone
配套媒体
本页对应的 PPT 与演示视频
下载没反应?点这里复制直链
侧边栏预览窗口(Electron webview)会拦截下载,把下面的链接复制到 Chrome / Edge 地址栏打开即可保存。
../../4danyone-recommend.pptx../../4danyone-recommend.mp4本文目录
📌 核心价值:一段随意拍的手机视频,AI 帮你重建出可 360° 旋转、还带时间轴的 4D 数字人——不用相机阵列、不用标定、不用三脚架。
以前要重建一个能任意转视角看的真人 4D 模型,得进专业摄影棚、用几十台同步相机围着拍。现在,浙大联合蚂蚁研究院把这个门槛砍到了「一段竖屏手机视频」。
🚀 什么是 4DAnyone?
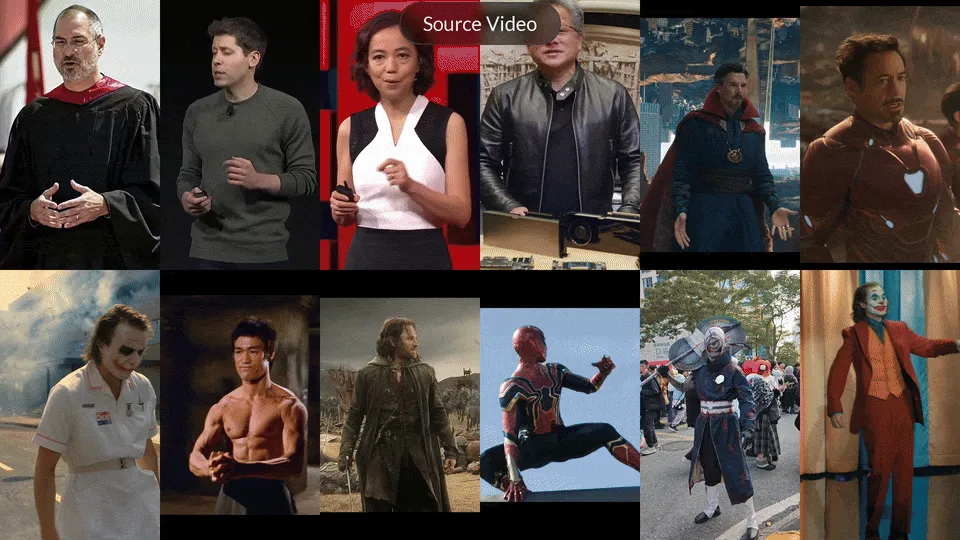
4DAnyone 是蚂蚁研究院(Ant Research)联合浙江大学、香港科技大学、香港中文大学、Robbyant 共同开源的项目,论文已被 SIGGRAPH Asia 2026 接收,代码与模型全部以 Apache-2.0 协议开源。
它的目标一句话就能说清:输入一段普通的单目视频(比如你手机随手拍的一段跳舞/走路),输出一个可以从任意角度观看、并且保留动作时间轴的 4D 数字人。
这里的「4D」= 3D 空间 + 时间维度。普通 3DGS 是静态的「扫描件」,而 4DGS 重建出的是会动的人——你可以在三维空间里自由拖动镜头环绕他,人物动作还在继续播放。
传统做法的痛点非常硬:想重建一个逼真 4D 人体,行业基准数据集 DNA-Rendering 用了 48 台同步标定相机同时拍摄。这就是为什么「体积视频/数字人」多年来被锁在 studios 里。4DAnyone 的聪明之处在于:它不要求你真的架起相机阵列,而是用视频扩散模型「生成」出那套相机阵列本该拍到的多视角视频,再拿这些生成视频去做 4DGS 重建——绕开了专业硬件。


核心定位:把「48 台相机才能干的事」压缩到「一段手机视频」,这是消费级数字人生产的范式转变。
✨ 核心功能一览
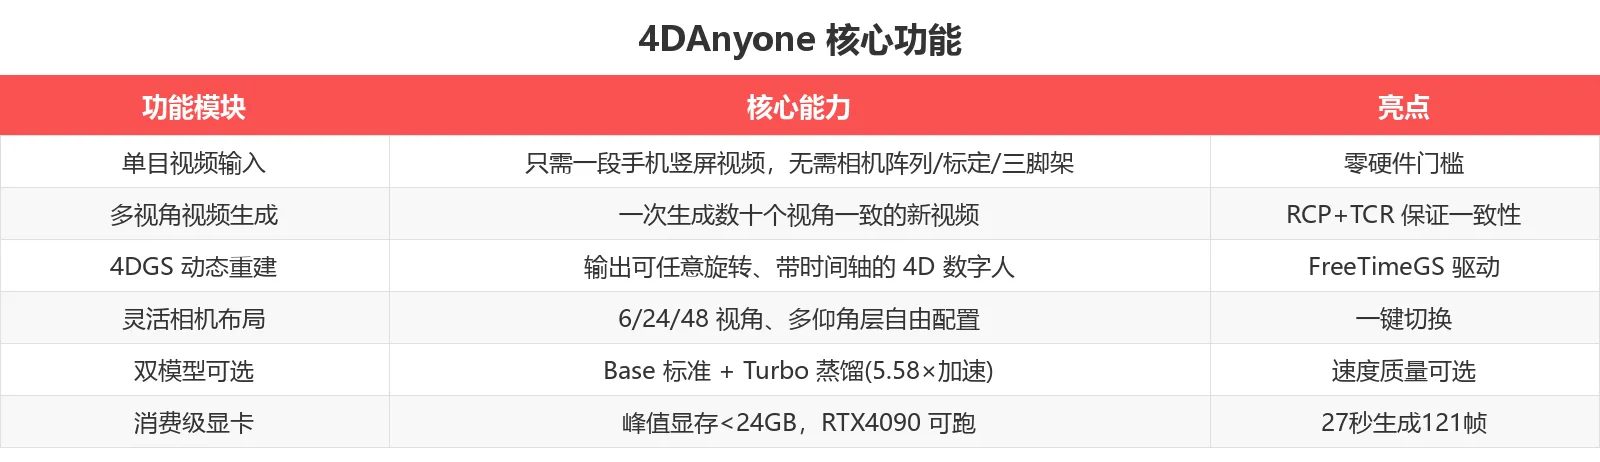
几个关键能力值得单独拎出来说:
- 单目视频输入:只要求单人出镜、轻微相机运动、未知相机内参和位姿——也就是「随手拍」级别的素材也能用,泛化到野外(in-the-wild)场景。
- 多视角视频生成:一次生成数十个视角一致的新视频,且支持灵活的相机布局(视角数、仰角层数、偏航范围全可配)。
- 4DGS 动态重建:生成的视角视频喂给 FreeTimeGS,得到可自由转视角的动态 4D 人体。
- 双模型可选:标准版 4DAnyone-Base + 蒸馏加速版 4DAnyone-Turbo(4 步去噪,官方称 5.58× 加速),速度与质量按需切换。
- 消费级显卡可跑:峰值显存压到 <24GB,单张 RTX 4090 即可完成推理。
🧠 技术原理:单目视频 → 多视角视频 → 4DGS
整个管线分三步,难点全在第二步的「一致性」。
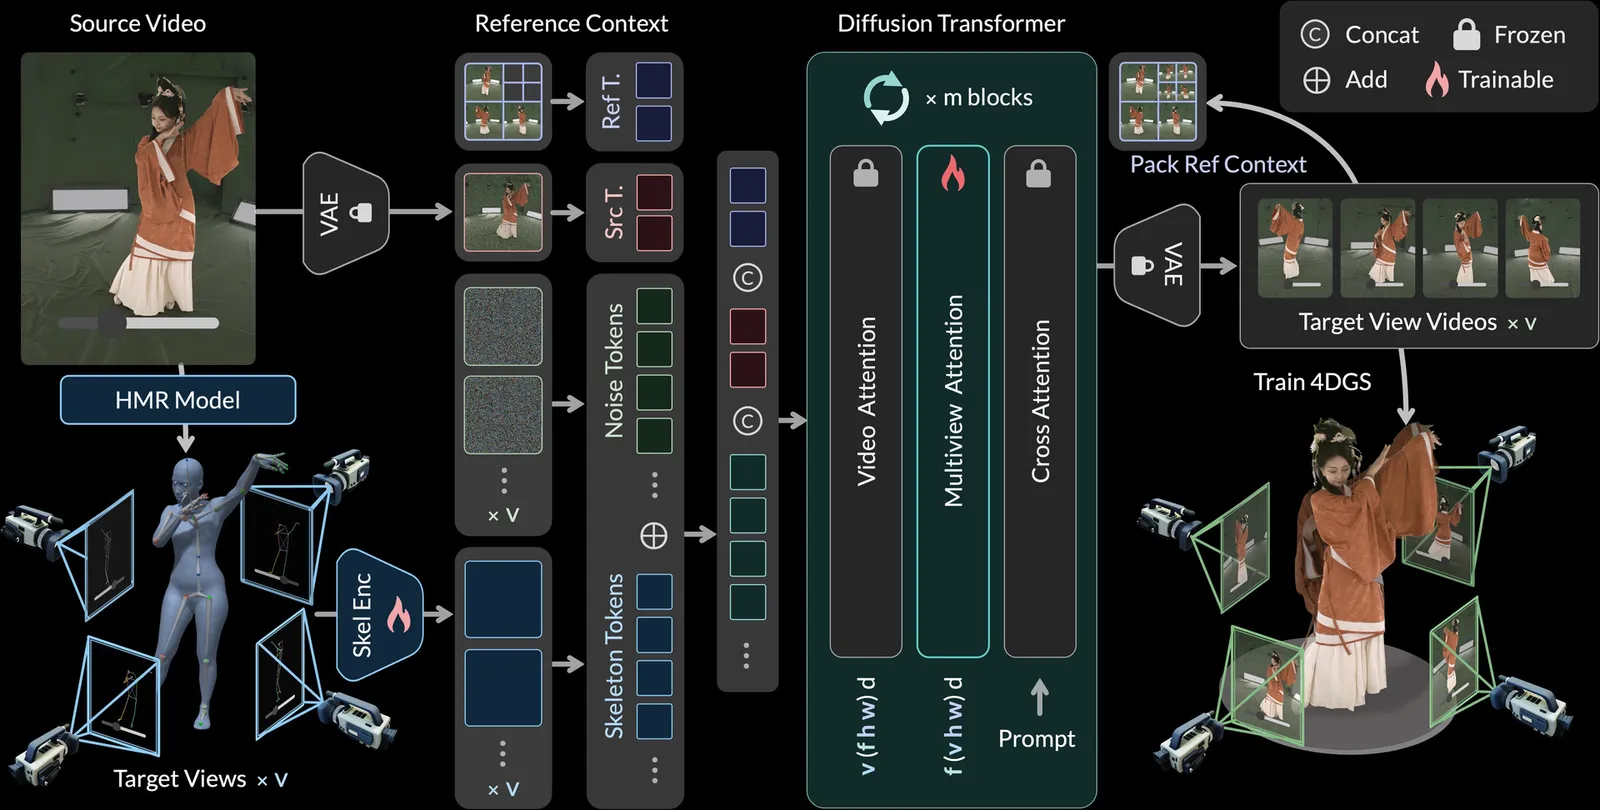
第一步:运动恢复。 用 GVHMR 从单目视频估出 SMPL-X 网格与 3D 骨架,并把骨架渲染成带深度信息的多视角条件图。这一步结果可缓存复用。
第二步:多视角视频生成(核心创新)。 问题是:4DGS 重建需要几十条视角,但视频扩散模型的 DiT 单趟能处理的视角数有限,视角一多就只能分批(分组)生成,于是出现两个坑:
- 参考视角越多,每个新视角的条件成本线性增长 O(N),把外观引导「稀释」掉;
- 分组后各组之间无法交换信息,导致跨组结构漂移——同一张脸在不同批次里长得不一样。
4DAnyone 用两个机制精准解决:
- RCP(Reference Context Packing):把线性增长的参考上下文压缩进固定预算的混合分辨率上下文,参考成本从 O(N) 降到 O(1)。
- TCR(Target Context Routing):在去噪过程中动态轮换目标视角的分组——高噪声阶段频繁换组以确定全局结构,低噪声阶段固定相邻组以稳住局部细节,实现跨组结构通信。
- 3D 骨架几何条件:用稀疏但精准的 3D 骨架(而非脆弱的稠密深度图/噪声相机参数)做条件,换来了强泛化能力。
一句话总结创新点:用 RCP 把参考上下文压成定长,用 TCR 让分组之间能「对话」,再用 3D 骨架兜底几何精度——彻底干掉了多视角扩散的结构漂移。
第三步:4DGS 重建。 生成的多视角视频 + 相机参数,用 FreeTimeGS 训练 4D 高斯泼溅模型,得到最终可自由查看的动态人体。
🛠️ 快速上手:跑通你的第一个 4D 数字人
安装
git clone https://github.com/ant-research/4DAnyone.git
cd 4DAnyone
git submodule update --init third_party/GVHMR

conda create -n 4danyone python=3.11 -y
conda activate 4danyone
pip install -r requirements.txt
为加速推理,可额外装 FlashAttention-3 或 SageAttention(装了会自动启用)。缺失的模型与示例会在首次运行时自动下载,也可手动拉取:
python scripts/download_smplx.py      # 人体参数化模型 SMPL-X
python scripts/download_model.py      # 4DAnyone 权重
python scripts/download_example.py    # 示例视频
核心推理命令
4DAnyone 支持灵活的视角数、仰角层、偏航覆盖,下面是从稀疏到密集的三种典型配置:
# 6 视角全轨道:最紧凑的 360° 布局,先拿来快速测试
python inference.py \
    --video_path "data/source/pexels/2785536-uhd_2160_3840_25fps.mp4" \
    --views_per_layer 6
# 24 视角全轨道:密集 360° 覆盖,适合做 4DGS 重建
python inference.py \
    --video_path "data/source/pexels/2785536-uhd_2160_3840_25fps.mp4" \
    --views_per_layer 24
# 48 视角三层:跨三个仰角环分布,适合复杂衣物/大幅动作
python inference.py \
    --video_path "data/source/pexels/2785536-uhd_2160_3840_25fps.mp4" \
    --views_per_layer 16 --layer_pitches '[-10,15,35]'
注意:输入视频需单人出镜(全身或半身)、9:16 竖屏、≥121 帧(约 4 秒)、1080p 以上,镜头不要大幅移动,人物尽量占画面主体。
📊 与竞品 / 传统方案对比
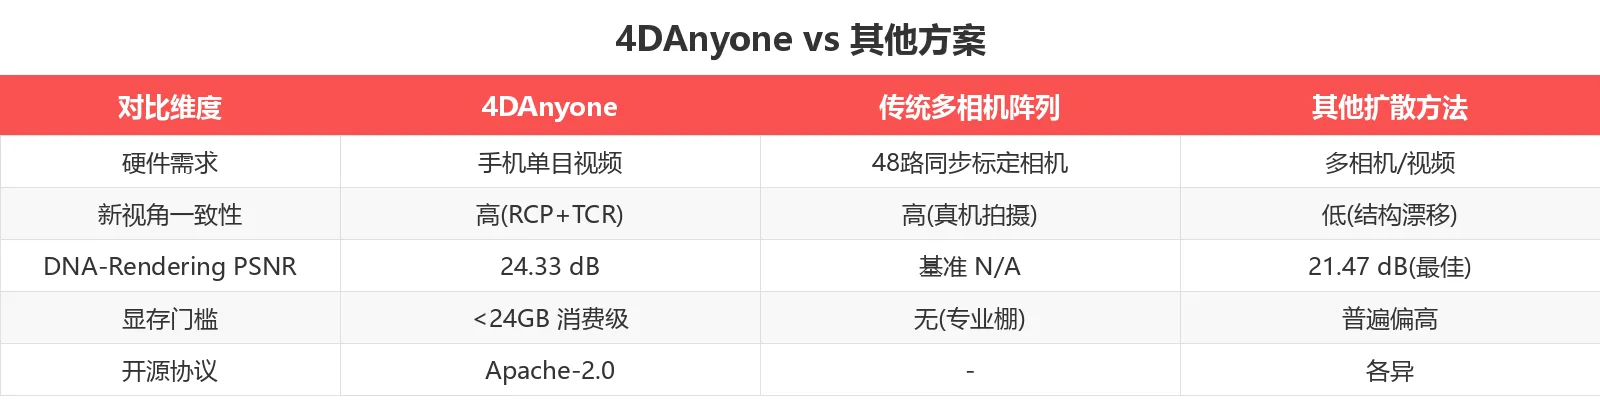
把 4DAnyone 放到更大的坐标系里看:
- vs 传统多相机阵列:DNA-Rendering 用 48 台同步相机才能拿到多视角真值;4DAnyone 只要一段手机视频,硬件门槛从「专业棚」降到「口袋里的手机」。
- vs 其他扩散式新视角方法:同类方法在视角数一多就出现结构漂移,4DAnyone 凭借 RCP+TCR 在 DNA-Rendering 新视角视频质量上拿到 PSNR 24.33 dB,而最佳对比方法仅 21.47 dB——近 3 dB 的差距在轮廓和衣物纹理上肉眼可见。
- 开源与门槛:Apache-2.0 全开源,峰值显存 <24GB,消费级显卡即可,对比很多闭源/高门槛方案友好得多。
💡 适用场景
场景 1:6 视角快速预览
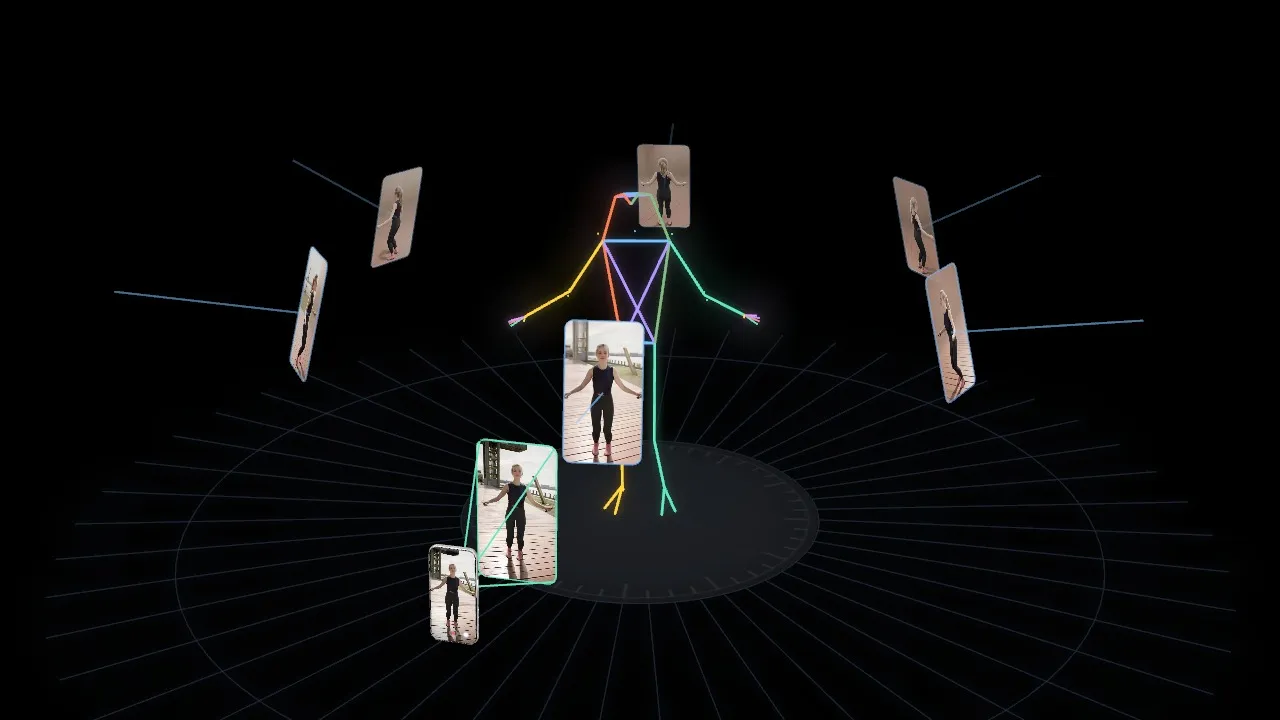
功能说明:一条命令生成 6 个均匀分布的环绕视角,最快验证一条视频能不能跑通。 输入要求:一段符合规范的单人竖屏视频。 输出效果:6 路视角一致的视频,初步看到「转起来」的数字人雏形。 适用场景:创作者做技术预检、教学演示最轻量的入口。
场景 2:24 视角全环绕 + 4DGS 重建
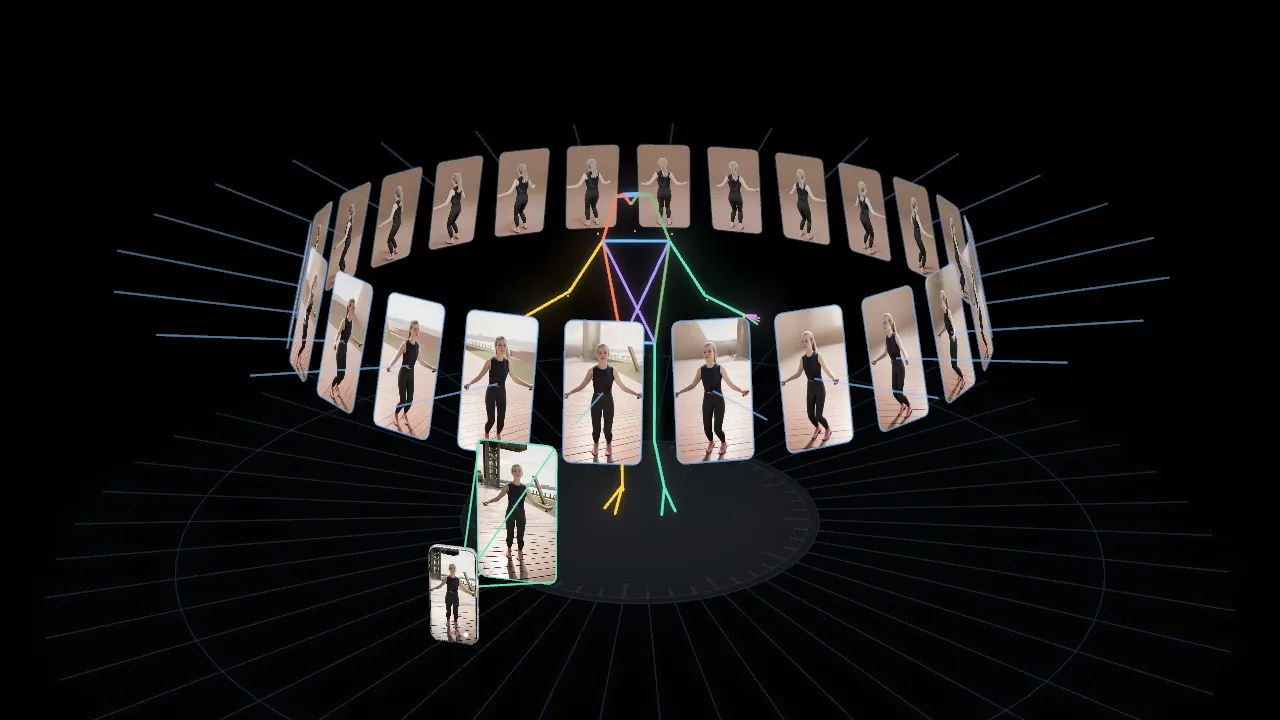
功能说明:24 路密集 360° 覆盖,是官方推荐的 4DGS 重建配置。 输入要求:同上,建议动作幅度适中。 输出效果:可自由转视角的完整 4D 人体,服装与动作一致性高。 适用场景:虚拟人资产生产、短视频/直播里的可旋转 3D 形象。
场景 3:48 视角三层(复杂动作/衣物)
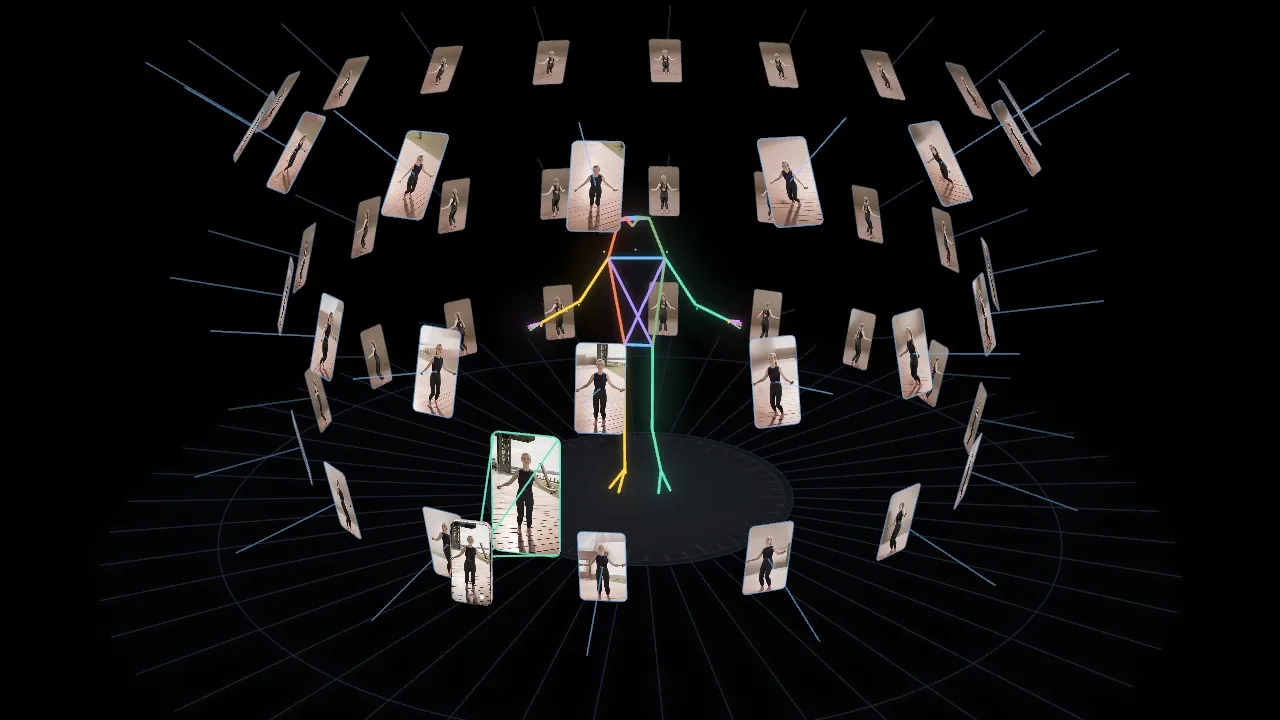
功能说明:跨越三个仰角环分布 48 个视角,覆盖更广。 输入要求:衣物复杂、或动作幅度大的素材。 输出效果:在极端姿态下仍能保持多视角一致性。 适用场景:舞蹈、运动、舞台表演类内容的数字人化。
场景 4:下游 4DGS 渲染与自由视角播放
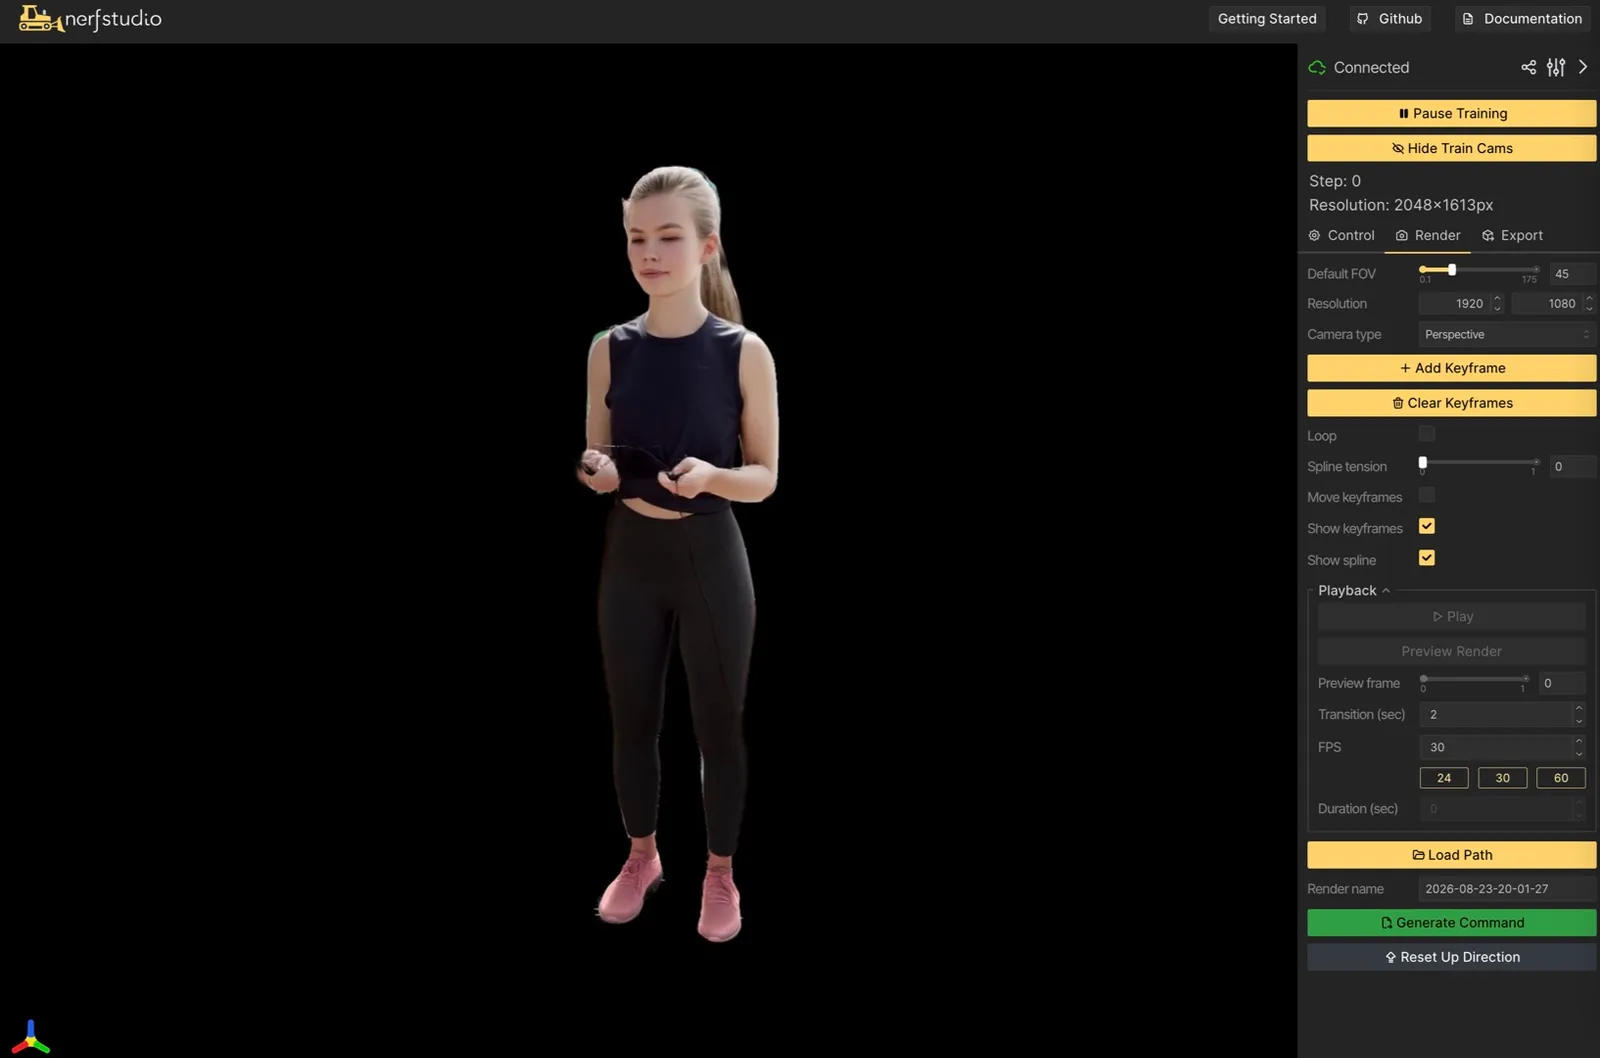
功能说明:把生成的多视角视频用 nerfstudio / FreeTimeGS 重建为 4DGS 模型,可在三维空间自由查看并播放。 输入要求:前面步骤产出的多视角视频 + 相机参数。 输出效果:实时可旋转的 4D 数字人,可直接接入 Unity / 渲染管线。 适用场景:影视预演、游戏过场、元宇宙分身。
用户群体总结
- ✅ 短视频 / 直播创作者:把日常视频一键变成可旋转的 3D 数字人,做新颖转场与分身特效。
- ✅ 虚拟人 / 元宇宙团队:低成本批量生成带动作的真人 4D 形象。
- ✅ 影视 / 游戏预演:快速把演员视频转成多机位素材,省下棚拍成本。
- ❌ 不适合:没有本地 GPU(需约 24GB 显存)的纯云端用户;对人物背面细节要求极高的工业级场景(背面是模型基于前部「合理推测」补全的)。
💰 性能与门槛
- 速度:单张 RTX 4090 上,121 帧视频约 27 秒完成生成(启用 Turbo 蒸馏后 4 步去噪,官方称 5.58× 加速)。
- 显存:峰值 <24GB,消费级显卡即可跑;多 GPU 并行可进一步提速(16 相机层用 4 卡、32 相机用 8 卡)。
- 协议:Apache-2.0 完全开源,模型权重首次运行自动下载(HuggingFace:
AntResearch/4DAnyone)。 - 基准:DNA-Rendering 上 PSNR 24.33 dB,领先最佳对比方法 21.47 dB 近 3 dB;DyMVHumans 上达 21.03 dB。
- 训练背景:基于 Wan2.2(50 亿参数)底座,在 128 张 H20-3E 上用自研游戏引擎数据集 MVGameHuman(3.8 万条多视角视频、318 名演员)训练。
💡 新用户福利:代码、模型、示例视频全部开源免费,首次运行自动拉取权重,零门槛上手,先拿示例视频跑通再说。
🎯 总结
4DAnyone 把「48 台相机才能做的 4D 人体重建」压缩到「一段手机视频」,靠的是 RCP+TCR 解决多视角一致性、3D 骨架兜底几何精度这一套组合拳。它不追求取代专业棚拍,而是把数字人生产从实验室真正下放到了消费级设备——对短视频创作者、虚拟人团队、影视预演都是实打实的效率杠杆。
推荐指数: ⭐⭐⭐⭐⭐(满分 5 星)
适合人群: 短视频/直播创作者、虚拟人/元宇宙团队、影视与游戏预演从业者。
立即体验: 4DAnyone 项目页
GitHub 仓库: ant-research/4DAnyone
模型权重: HuggingFace AntResearch/4DAnyone
数据截至 2026-09-05,最新信息请以官网为准。